

ChatGPT连接外部App前必看:权限层级与同步范围指南
ChatGPT连接外部App时,用户常因权限与同步范围设置不当导致数据泄露或功能异常。本文基于OpenAI官方文档,梳理插件、连接器与动作权限的三层控制逻辑,提供连接前评估要点与首次验证方法,帮助用户安全高效地集成外部工具。
权限控制三层架构解析
ChatGPT与外部App的集成并非简单的“连接”操作,而是涉及多层权限控制。OpenAI的Learn文档将这一过程拆分为三个关键层级:
第一层:插件可用性控制。工作区管理员可独立决定特定插件是否对成员开放。需注意,启用插件不等于自动授予所有连接器权限,两者需分别配置。
第二层:连接器访问范围。插件内可能包含多个连接器,每个连接器需单独配置数据访问范围与操作权限。管理员需先确认插件可用性,再细化连接器权限。
第三层:动作与权限细分。连接器权限分为只读、写入及复杂操作三类。App permissions设置决定ChatGPT何时需用户确认后再执行操作。建议初次连接时仅开放只读权限,避免直接启用写入功能。
对新手而言,核心判断标准应是“该工具首次接入时会访问哪些数据”,而非单纯关注功能强度。明确数据边界可防止内部数据范围意外扩大,降低后续权限清理成本。
连接前必查三项核心配置
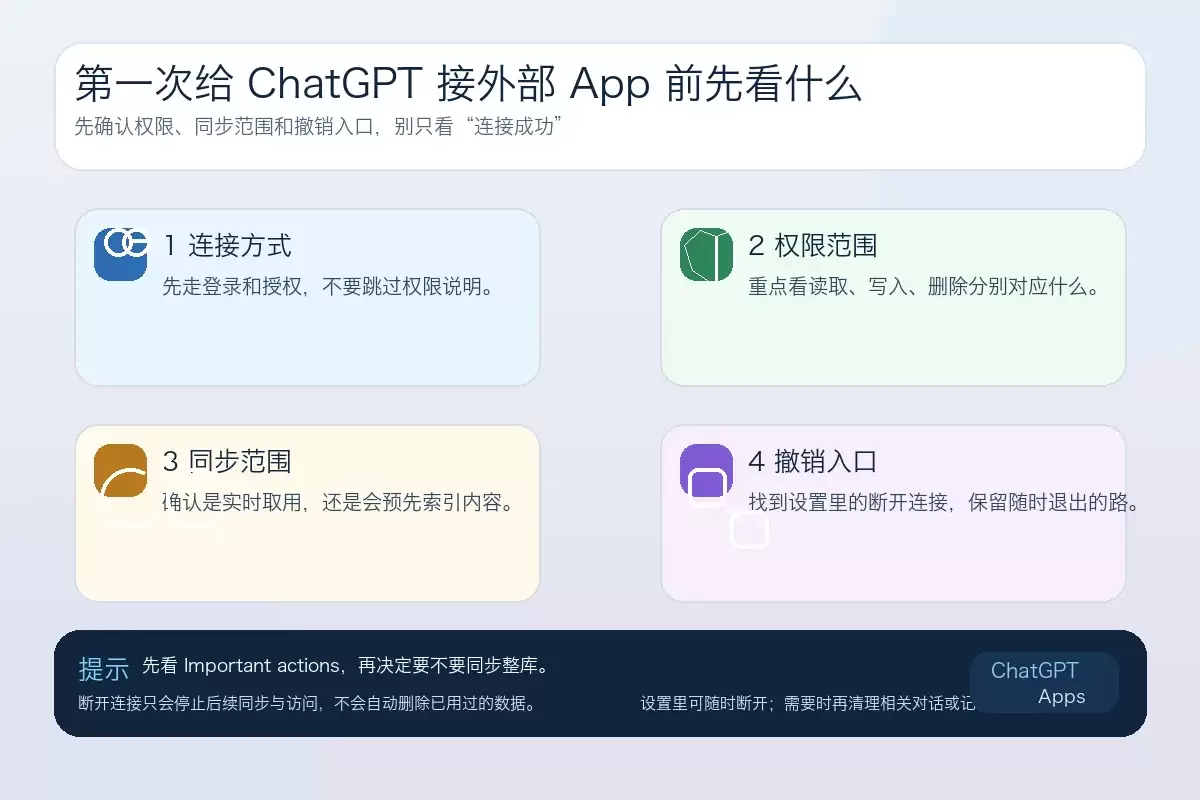
在点击连接按钮前,需完成以下三项关键检查:
- 管理员权限要求:多数团队级插件(如邮箱、日历、文件库及项目管理系统)需工作区管理员预先授权,个人账号无法直接安装。
- 数据同步层级:明确连接器同步的是完整数据库、特定工作空间还是独立知识源。不同层级对应不同的数据暴露风险。
- 权限生效机制:确认权限修改是实时生效还是需等待下一轮同步周期完成。
OpenAI文档指出,未启用sync功能的连接器仅支持临时数据检索,ChatGPT不会将其内容纳入长期索引;而启用sync的连接器会预先建立选定内容的索引。这一差异直接影响查询响应机制:临时检索实时拉取数据,同步索引则优先查询已缓存内容。
若仅为个人临时测试,需确认该App是否支持随时断开连接或降级为只读权限。支持灵活收口的工具更适合小范围试验;反之则应严格限制初始接入范围。
需注意,连接器访问始终受限于已认证用户权限与服务端授权范围。ChatGPT的数据获取能力不会超越原始系统的角色权限与动作控制约束。
同步范围控制与数据隔离策略
新手常见误区是将所有数据一次性接入,导致查询结果混杂且难以溯源。建议采用渐进式接入策略:
- 优先连接高频使用且易于验证的数据源,如单一项目空间、特定文档库或工单集合。
- 区分个人数据与工作区数据。个人账号可见内容未必适合纳入工作区共享;工作区可搜索内容也无需全部同步至每次对话。
- 明确“可搜索”不等于“永久存储”。同步型连接器按规则引用数据,仅在相关查询时激活参考,非主动展开所有内容。此机制常被误判为数据丢失或权限失效。
配置时需持续核对“预期访问范围”与“实际可访问范围”是否一致,而非仅关注连接状态指示灯。数据用途分离是后续权限管理的基础。
首次连接验证与渐进式权限开放
连接完成后,应立即执行最小化验证测试:
- 使用已知答案的查询(如特定文档标题、日期、负责人或固定表述)验证数据引用准确性。
- 优先测试只读功能,确认数据路径正确后再逐步开放写入权限。
- 若返回结果异常,按以下顺序排查:插件安装状态→连接器权限配置→同步完成状态→数据源纳入范围。
OpenAI的权限设计将“读取”“写入”与“用户确认时机”严格分离,此顺序旨在帮助用户先验证数据通路,再评估操作风险。首次集成外部App时,此验证步骤比追求全功能更重要。
后续扩展接入范围时,应遵循以下原则:
- 保留一个稳定命中的数据源后,再添加第二个来源。
- 先确认数据可见范围,再决定同步周期。
- 预先测试断开入口,再逐步接入敏感数据。
按此流程操作虽看似缓慢,但可避免全量开放后的大规模权限清理工作,显著提升集成效率与安全性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。