

Python怎么批量打印列表中每个元素的数据类型

在 Python 中批量打印列表中每个元素的数据类型,核心做法是结合内置的 type() 函数与循环或映射结构。最直接的方式是使用 for 循环配合 enumerate() 逐项获取,如果追求代码紧凑度,则可以使用列表推导式或 map() 函数输出纯净的类型名称。
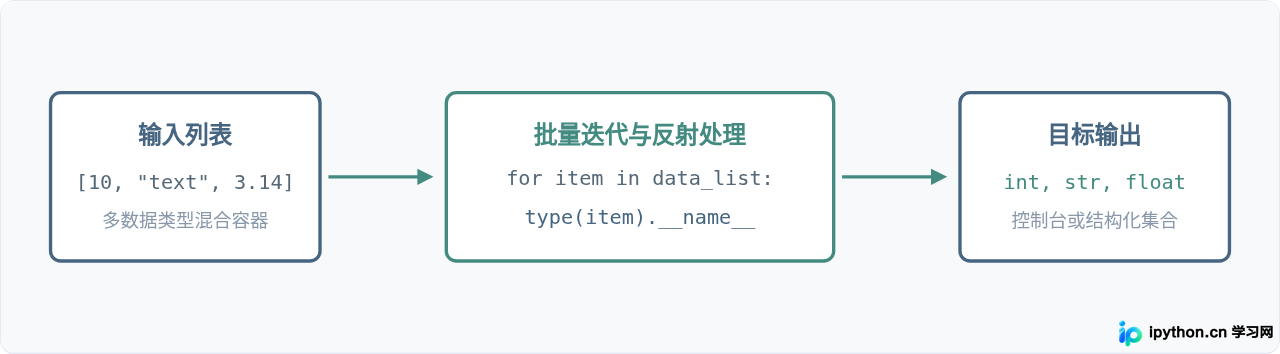
方法一:使用 for 循环与 enumerate 逐项打印
在调试数据或者清洗包含不规则类型的文件内容时,同时知道索引位置、实际值以及具体类型是最清晰排错的方式。使用 for 搭配 enumerate() 能直接获取元素的下标与值。
# 包含多种不同类型数据的测试列表
raw_data = [1024, "Python教程", 3.1415, True, [1, 2], {"status": 200}, None]

# 遍历列表并格式化输出
for idx, item in enumerate(raw_data):
    print(f"索引 {idx}: 元素值 = {repr(item):<16} | 数据类型 = {type(item)}")
索引 1: 元素值 = 'Python教程' | 数据类型 = <class 'str'>
索引 2: 元素值 = 3.1415 | 数据类型 = <class 'float'>
索引 3: 元素值 = True | 数据类型 = <class 'bool'>
索引 4: 元素值 = [1, 2] | 数据类型 = <class 'list'>
索引 5: 元素值 = {'status': 200} | 数据类型 = <class 'dict'>
索引 6: 元素值 = None | 数据类型 = <class 'NoneType'>
直接打印 type(item) 会输出形如 <class 'int'> 的类型对象字符串。如果你只需要纯粹的类型名字,可以通过 type(item).__name__ 获取纯字符串表达(例如直接得到 "int" 而非完整类描述)。
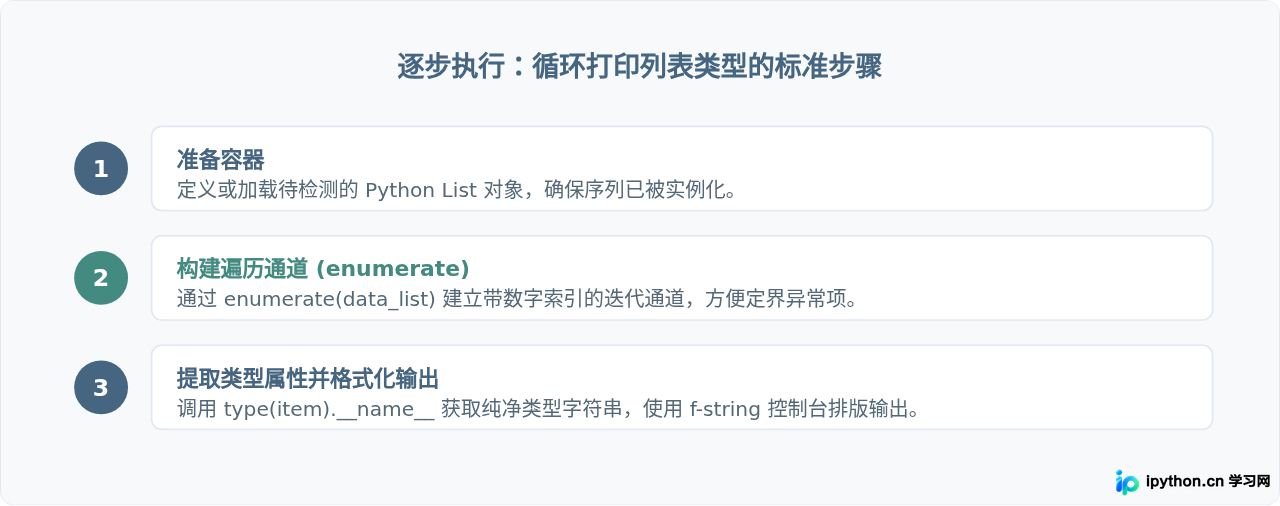
方法二:使用列表推导式与 map 高效批量收集
当你不需要复杂的文本对齐排版,而是想将所有类型名字快速提取成一个新列表便于下游统计或快速在控制台查看时,推导式和内置函数是更符合 Python 惯用语法(Pythonic)的选择。
1. 列表推导式(推荐,可读性最好)
raw_data = [42, "hello", 1.0, False]

# 批量提取类型名称
type_names = [type(item).__name__ for item in raw_data]

# 一次性打印输出
print("元素类型列表:", type_names)
2. map() 与 join 组合(适合生成单行日志或报告)
通过内置的 map() 函数直接将 type 作用于列表的所有元素,再通过生成器表达式将结果拼接为单行文本:
raw_data = [100, "测试", 9.9, None]

# 利用 map 批量执行 type 并取出类名进行拼装
summary_str = " -> ".join(t.__name__ for t in map(type, raw_data))
print("类型链路:", summary_str)
注意区别:精准检测 type() 与继承判断 isinstance()
在批量处理时,很多开发者会纠结到底使用 type() 还是 isinstance()。需要明确两者在底层机制和目标场景上的根本区别:
type(obj):返回对象直接所属的类型类对象。它不考虑继承关系。如果一个类继承自另一个类,type()只会告诉你它是当前派生类。isinstance(obj, class_or_tuple):接收待检测对象和一个目标类型,返回布尔值(True/False)。它能正确识别子类对象也是基类的实例。
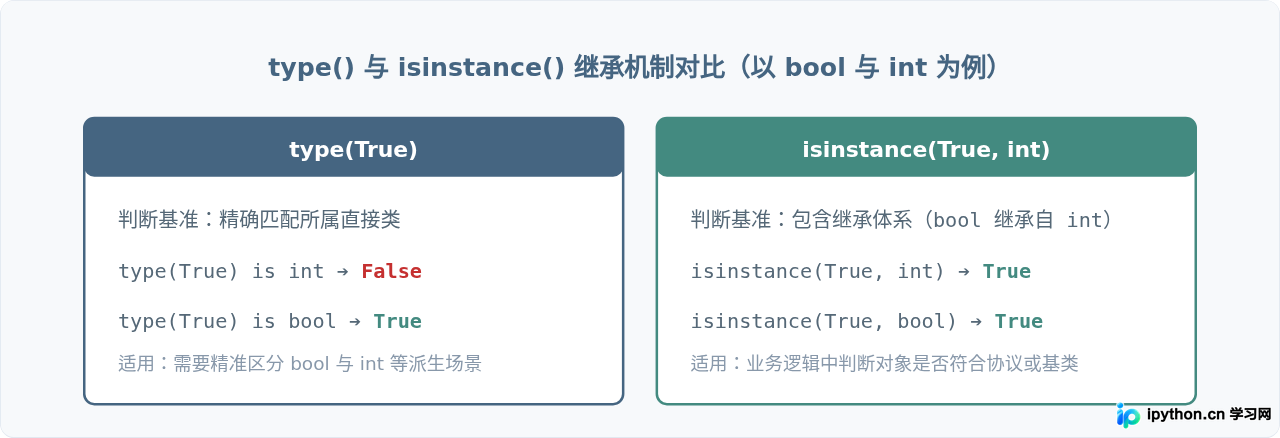
在 Python 中,bool 是 int 的派生子类。如果你只想做“打印并观察列表中到底存了什么”,始终优先使用 type(),因为它能准确告诉你 True 就是 bool,不会混同为整型。
处理嵌套列表:递归批量打印
实际业务数据中,列表常常存在多层嵌套(例如 [1, [2, "a"], 3])。直接遍历外层列表只会将内部子列表打印为单个 list 类型。如果需要探查每一层具体元素的数据类型,可以编写一个轻量的递归打印函数:
def print_list_types(target_list, current_depth=0):
    """
    递归批量打印列表及多层嵌套子列表中每个元素的类型
    """
    indent = "  " * current_depth
    for index, element in enumerate(target_list):
        if isinstance(element, list):
            print(f"{indent}[层级 {current_depth}] 索引 {index} 是嵌套列表 (长度 {len(element)}):")
            # 深入子列表进行递归
            print_list_types(element, current_depth + 1)
        else:
            print(f"{indent}[层级 {current_depth}] 索引 {index}: 元素 = {element!r} | 类型 = {type(element).__name__}")

# 测试嵌套数据
nested_sample = [100, ["Python", 3.14, [True, None]], "结束"]
print_list_types(nested_sample)
[层级 0] 索引 1 是嵌套列表 (长度 3):
[层级 1] 索引 0: 元素 = 'Python' | 类型 = str
[层级 1] 索引 1: 元素 = 3.14 | 类型 = float
[层级 1] 索引 2 是嵌套列表 (长度 2):
[层级 2] 索引 0: 元素 = True | 类型 = bool
[层级 2] 索引 1: 元素 = None | 类型 = NoneType
[层级 0] 索引 2: 元素 = '结束' | 类型 = str
避坑提示:在递归处理未知层级的数据时,如果嵌套深度可能过大(超过默认递归限制 1000 层)或列表存在循环自引用(如 a = []; a.append(a)),直接递归会导致 RecursionError。在生产排查中,如需处理自引用容器,应配合集合记录已访问对象的 id() 进行防环检查。
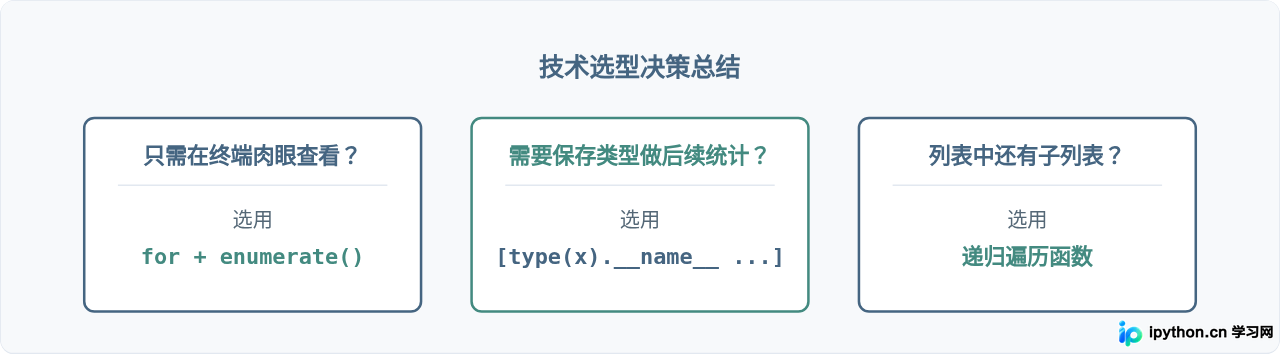
总结与选型参考
根据你的具体使用目的,批量获取或打印列表中元素类型的方式可以归结为以下三种主要场景:
| 实现方案 | 典型使用代码 | 主要优势 | 适用场景 |
|---|---|---|---|
| 带索引的 for 循环 | for i, v in enumerate(lst): print(i, type(v)) |
包含位置与原值,排查定位极为准确 | 日常脚本调试、脏数据快速纠错 |
| 列表推导式 | [type(x).__name__ for x in lst] |
生成标准列表,内存连续,可直接做统计操作 | 数据预处理、单元测试中的断言比对 |
| 递归探测函数 | 封装函数,遇到 list 继续调用自身 |
透传任意深度的树形结构 | 解析 JSON 转化而来的复杂多层嵌套数据 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









