

Python实现DBSCAN聚类:CSV数据读取与效率分析

发布时间:2026-10-15| 5人浏览过
本文介绍如何使用Python读取CSV文件并进行DBSCAN聚类分析。通过示例代码展示数据预处理、参数设置及结果可视化,并深入探讨数据量增大时的计算效率问题,提出后续优化方向,为需要处理大规模数据的用户提供参考。
1.读取csv数据做dbscan分析
首先从CSV文件中提取指定列,将其转换为算法所需的格式,随后执行DBSCAN运算。目前网络上公开的代码资源较为丰富,本文基于公开代码进行了修改和完善。
具体实现代码如下:
from sklearn import datasets
import numpy as np
import random
import matplotlib.pyplot as plt
import time
import copy
import pandas as pd
# from sklearn.datasets import load_iris

def find_neighbor(j, x, eps):
    N = list()
    for i in range(x.shape[0]):
        temp = np.sqrt(np.sum(np.square(x[j] - x[i])))  # 计算欧式距离
        if temp <= eps:
            N.append(i)
    return set(N)


def DBSCAN(X, eps, min_Pts):
    k = -1
    neighbor_list = []  # 用来保存每个数据的邻域
    omega_list = []  # 核心对象集合
    gama = set([x for x in range(len(X))])  # 初始时将所有点标记为未访问
    cluster = [-1 for _ in range(len(X))]  # 聚类
    for i in range(len(X)):
        neighbor_list.append(find_neighbor(i, X, eps))
        if len(neighbor_list[-1]) >= min_Pts:
            omega_list.append(i)  # 将样本加入核心对象集合
    omega_list = set(omega_list)  # 转化为集合便于操作
    while len(omega_list) > 0:
        gama_old = copy.deepcopy(gama)
        j = random.choice(list(omega_list))  # 随机选取一个核心对象
        k = k + 1
        Q = list()
        Q.append(j)
        gama.remove(j)
        while len(Q) > 0:
            q = Q[0]
            Q.remove(q)
            if len(neighbor_list[q]) >= min_Pts:
                delta = neighbor_list[q] & gama
                deltalist = list(delta)
                for i in range(len(delta)):
                    Q.append(deltalist[i])
                    gama = gama - delta
        Ck = gama_old - gama
        Cklist = list(Ck)
        for i in range(len(Ck)):
            cluster[Cklist[i]] = k
        omega_list = omega_list - Ck
    return cluster

# X = load_iris().data
data = pd.read_csv("testdata.csv")
x,y=data['Time (sec)'],data['Height (m HAE)']
print(type(x))
n=len(x)
x=np.array(x)
x=x.reshape(n,1)
y=np.array(y)
y=y.reshape(n,1)
X = np.hstack((x, y))
cluster_std=[[.1]], random_state=9)

eps = 0.08
min_Pts = 5
begin = time.time()
C = DBSCAN(X, eps, min_Pts)
end = time.time()
plt.figure()
plt.scatter(X[:, 0], X[:, 1], c=C)
plt.show()
2.输出结果显示
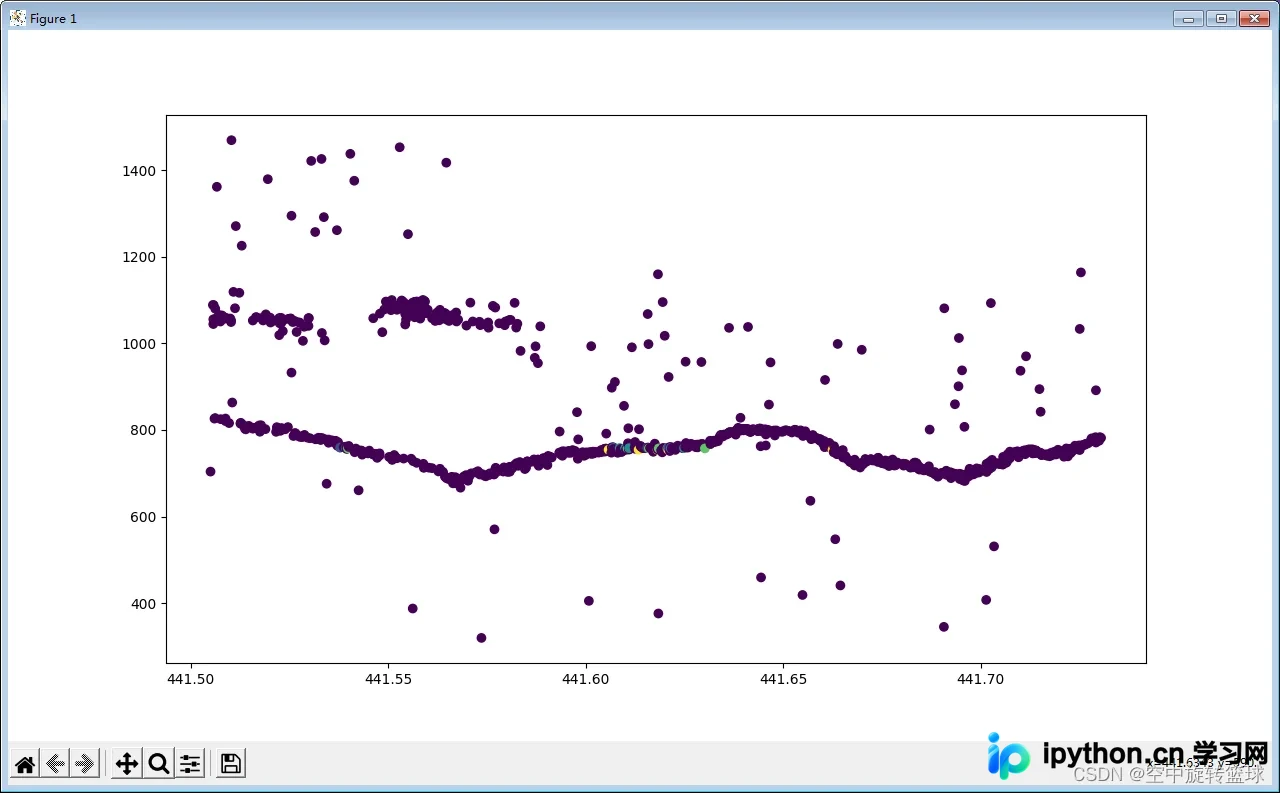
调整参数后的显示效果:
eps = 0.8
min_Pts = 5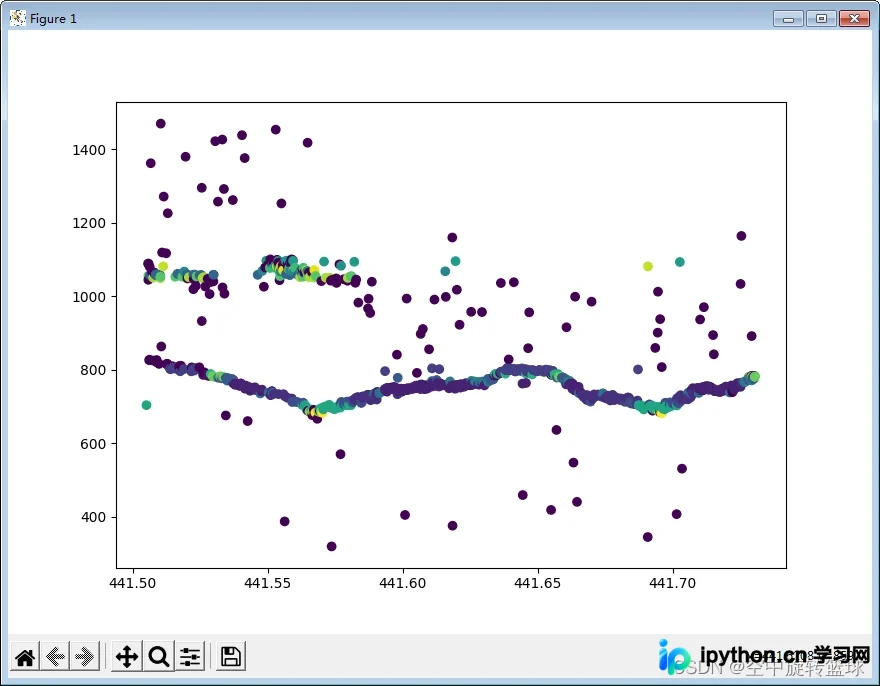
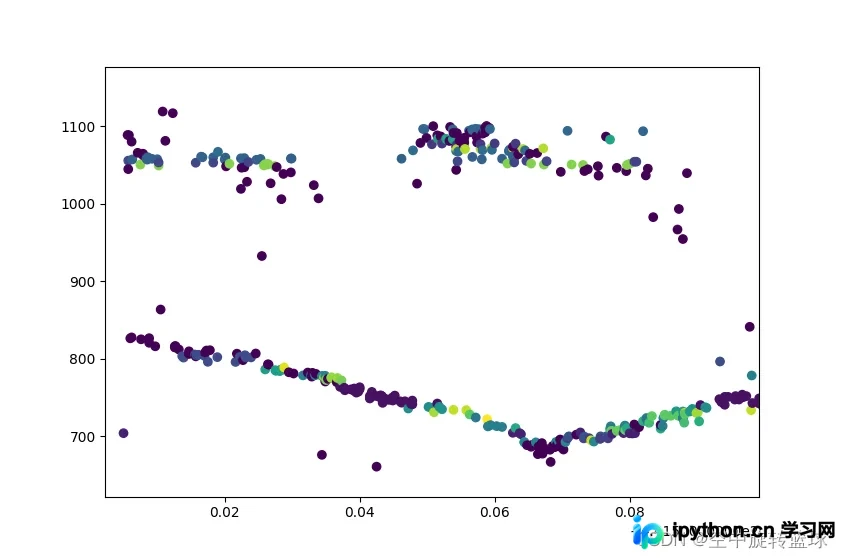
3.计算效率
在数据量较小时,计算效率差异不明显;但随着数据规模增加,计算耗时显著上升,难以满足大规模数据的处理需求。后续计划优化计算方法或引入C++代码以提升性能。
至此,关于Python读取CSV文件进行DBSCAN分析的介绍完毕。如需了解更多Python DBSCAN相关内容,请查阅本站过往文章或继续浏览后续内容,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









