

Python解包赋值时怎么用下划线忽略不需要的值

在 Python 中对元组、列表或生成器进行解包赋值时,经常会遇到序列中包含多个元素,而当前逻辑仅需使用其中某一项或某几项的情况。Python 官方与开源社区通行的最佳实践是使用单下划线 _ 作为占位符变量名,指示对应位置的值已被丢弃;若需要忽略连续的不定长多个元素,则可以配合星号使用 *_ 进行扩展解包。本文将具体讲解这两种核心语法的使用方法、底层原理及开发中的避坑要点。
一、使用单下划线 _ 忽略单个固定位置的值
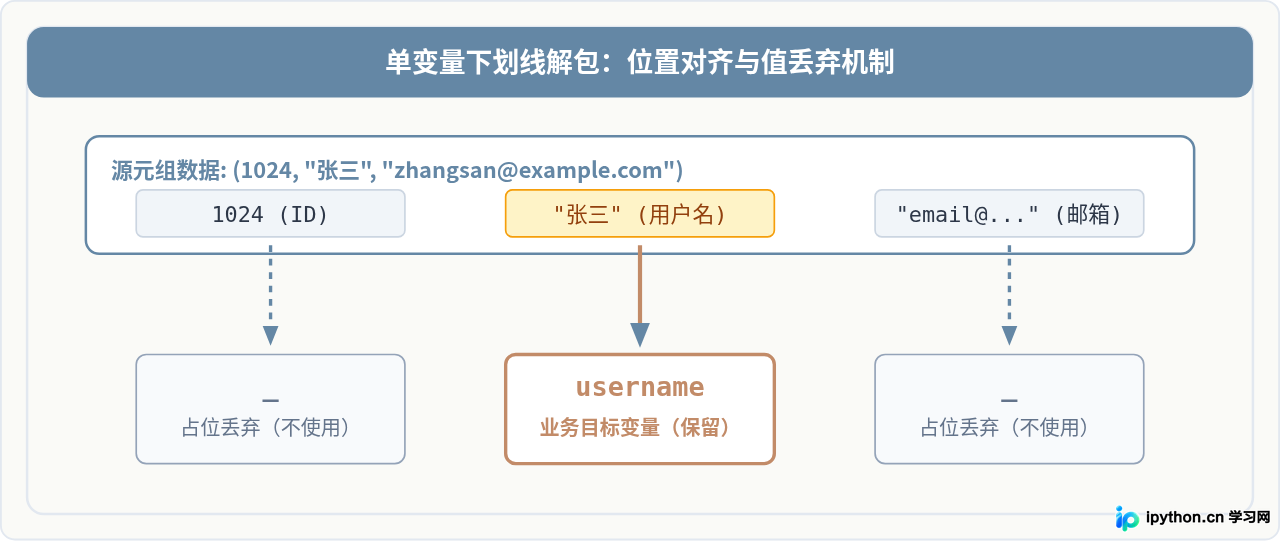
解包赋值要求左侧变量数量与右侧可迭代对象的元素数量精确一致。如果函数返回了包含三项的元组,而我们只需要第二项,直接少写变量会导致解包报错。此时在不需要的索引位置填入单下划线 _ 即可满足对齐要求。
# 示例 1:忽略函数返回的多余字段
def get_user_record():
    return (1024, "张三", "zhangsan@example.com")

# 只需要用户名,忽略用户ID和邮箱
_, username, _ = get_user_record()
print("用户名:", username) # 输出: 用户名: 张三在语法层面,_ 并不是语法保留字,而是一个合法的标识符。Python 解释器在运行时依然会把对应位置的值赋给名为 _ 的变量,只是在程序员之间达成了默契:凡是命名为 _ 的变量,后续逻辑都不应再次读取和引用。
这种写法在循环遍历键值对或枚举序列时同样极为普遍:
# 示例 2:在循环中忽略字典键或列表索引
data = {"apple": 5, "banana": 12, "cherry": 30}

# 仅需要统计总库存,不需要键名
total_stock = sum(count for _, count in data.items())

# 仅需要执行特定次数的循环,不关心计数器数值
for _ in range(5):
    # 执行5次重试逻辑
    pass
二、使用星号扩展解包 *_ 忽略多余或不定长元素
当可迭代对象包含较长序列,或者元素的具体长度在运行时不固定时,写满多个 _ 既繁琐又易出错。Python 3 引入了扩展可迭代对象解包语法(Extended Iterable Unpacking),允许在变量名前加上星号 *。结合下划线写为 *_,即可将连续的多项元素通配收集为一个列表并直接忽略。
1. 忽略前缀或后缀
scores = [95, 88, 72, 60, 45, 30]

# 提取最高分,忽略后续所有成绩
highest, *_ = scores

# 提取最低分,忽略前面所有成绩
*_, lowest = scores
2. 忽略中间元素,只保留首尾
record = ["2026-10-10", "order_9981", "item_4", "qty_2", "COMPLETED"]

# 提取日期和最终状态,忽略中间的订单内部详情
date, *_, status = record
print(f"日期: {date}, 状态: {status}")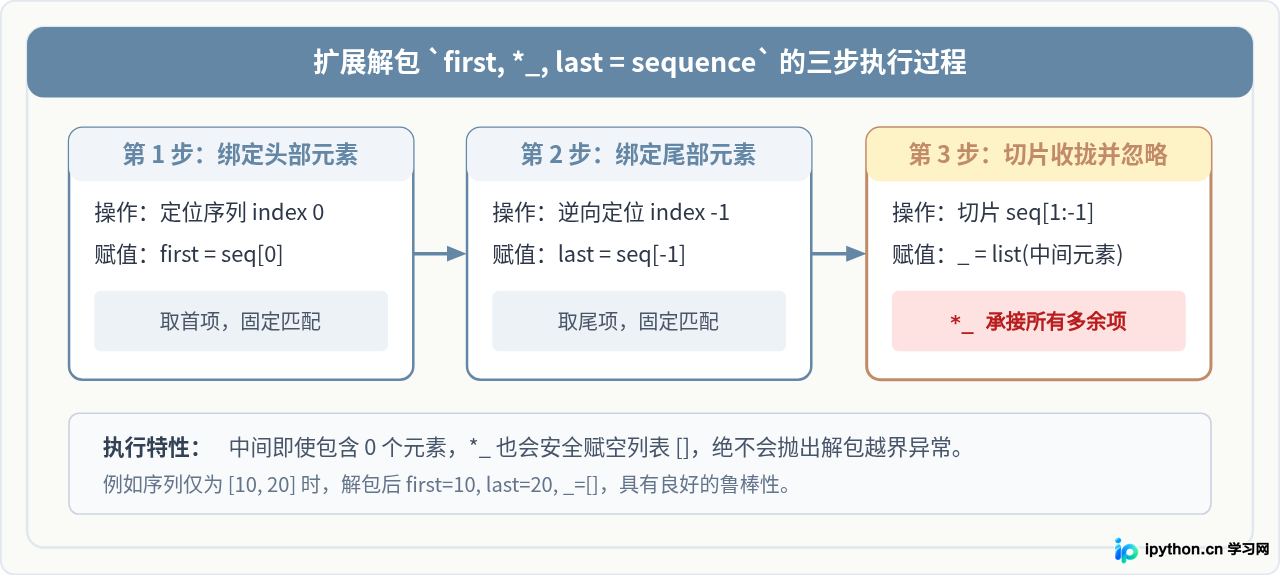
三、场景选择:单下划线与星号下划线的选用对比
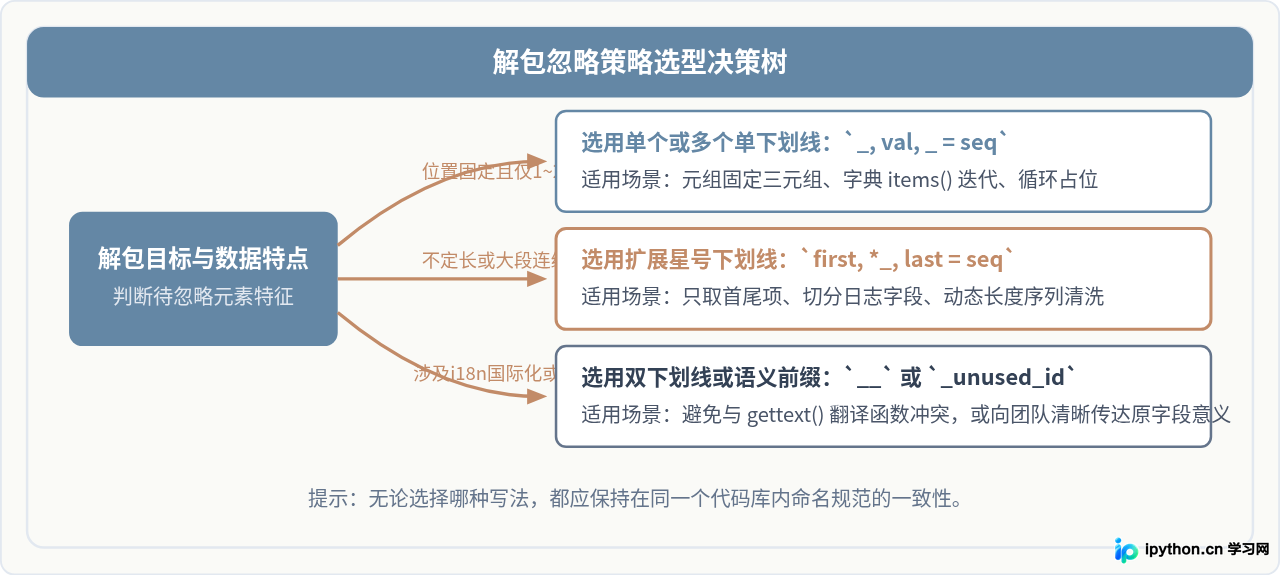
在工程实践中,如何选择合适的忽略写法取决于被解包数据的结构和业务上下文。以下决策分支可作为选择依据:
四、关键细节与避坑注意事项
下划线解包虽然使用简便,但在特定语法环境和工程背景下,存在几个容易引发 Bug 的关键细节:
1. 赋值语句中最多只能出现一个星号表达式
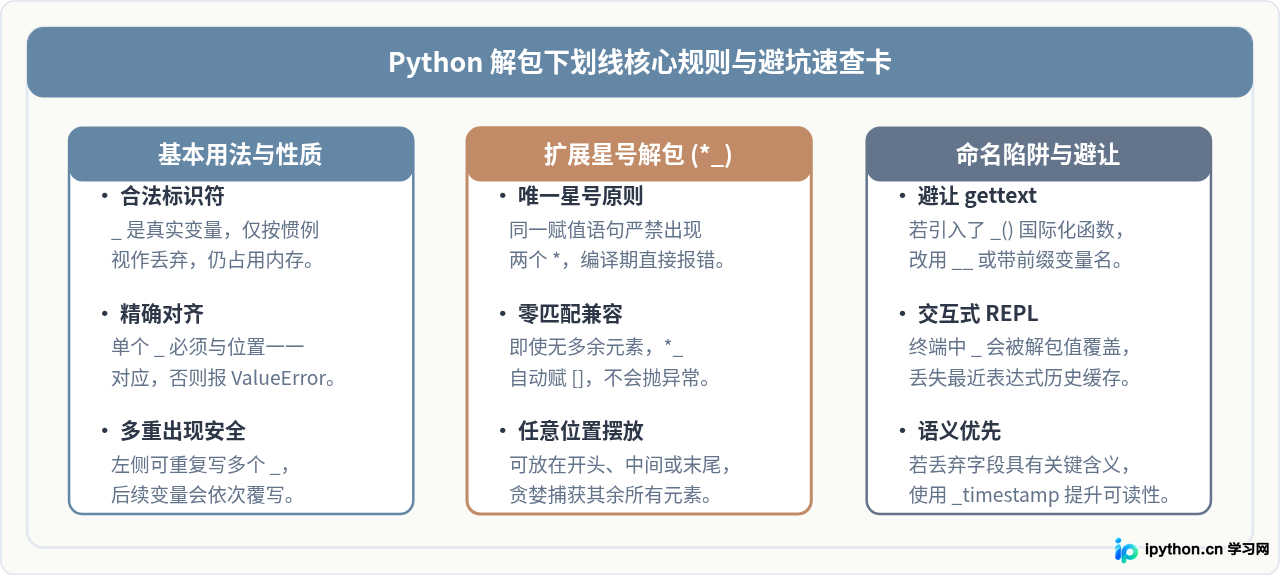
在解包赋值时,Python 无法对两个同时存在的未知长度变量进行贪婪切分。因此如果写出 *_, mid, *_ = sequence,Python 解释器在编译期就会抛出 SyntaxError: two starred expressions in assignment。若需要跳过中间和两头,必须明确其中一方的边界长度。
2. 单下划线变量在环境中的特殊冲突
虽然单下划线 _ 适合快速丢弃变量,但在两个特定场景下需要保持谨慎:
- 国际化多语言项目(gettext):在 Django 等 Web 项目中,通常会导入
from django.utils.translation import gettext as _。此时若在函数内执行_, result = get_pair(),局部的_就会覆盖掉全局翻译函数,导致后续调用_("Hello")报TypeError。这种情况下推荐使用__或_unused。 - 交互式命令行(REPL / Jupyter):在交互式解释器中,
_默认保存着“上一条执行表达式的结果”。解包赋值会覆写该变量,使得后续无法通过_快捷获取上一步结果。
3. 解包元素数量不足与过多
对于未使用星号的普通解包 a, _, c = data,当右侧长度与变量数不符时,会报 ValueError: not enough values to unpack(数量不足)或 ValueError: too many values to unpack(数量过多)。如果源数据可能出现长度波动,请务必使用带星号的 *_ 进行自适应吸收。
五、总结
在 Python 解包赋值中,合理使用单下划线 _ 与带星号的 *_ 能够让数据提取代码变得精炼、意图清晰。在实际编写代码时:
- 对于已知长度的固定序列,直接使用单个或多个
_对应丢弃位置; - 对于不定长或仅需首尾特定项的序列,优先使用
first, *_, last = sequence扩展解包; - 在大型团队协作或涉及国际化翻译的项目中,注意避开
_变量覆盖,必要时采用__或具有语义提示的下划线变量(如_unused)。
掌握这套规则后,你便能在处理复杂返回值或序列切分时写出兼具稳健性与 Pythonic 风格的代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









