

Python set() 去重的底层原理:哈希与相等性判断详解

本文深入解析 Python 中 set() 去重的底层实现机制。集合利用元素的唯一性进行去重,其核心依赖于 __hash__ 和 __eq__ 两个魔术方法的协同工作。当哈希值不同时视为不同元素;哈希值相同时,进一步通过 __eq__ 判断是否真正相等。文章包含自定义类去重的完整代码示例,展示如何重写哈希与相等逻辑以满足特定业务需求。
set是什么?
在数学定义中,集合是由不同元素组成的整体,这些元素被称为集合元素。Python 将这一概念引入到其内置的集合类型对象中。集合对象本质上是一组无序排列且可哈希(hashable)的值。它支持关系测试以及并集、交集等标准集合运算,行为符合数学集合的直观预期。
set特点
集合中的元素具备以下三个核心特征:
1. 确定性:集合中的每一个元素必须是明确且确定的;
2. 互异性:集合内的元素互不相同,例如若集合 A={1, a},则 a 不能等于 1;
3. 无序性:集合中的元素没有顺序之分,例如 {3, 4, 5} 与 {3, 5, 4} 被视为同一个集合。
在 Python 中,集合(set)是一个无序且不包含重复元素的集。它的基本功能包括关系测试和消除重复元素,同时也支持计算交集、差集和并集。与列表(list)类似,但关键区别在于集合不允许包含重复值,且其元素是无序排列的。
在 Python 中,可以使用大括号 {} 来创建集合。需要注意的是,如果要创建或初始化一个空集合,必须使用 set() 函数,而不能使用 {}。因为 {} 在 Python 中被解析为创建一个空的字典,字典这种数据结构将在后续章节中介绍。
一、set去重简单实例
ls = [1,2,3,1,2]
print(set(ls))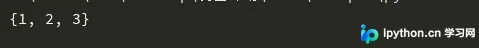
对于列表而言,最简单的去重方法是直接调用 set 函数,利用集合元素的唯一性来实现去重。然而,其底层的实现原理究竟如何,往往容易被忽视。
接下来我们将对这一过程进行深入剖析。
二、重新set实现机制
class Foo:
    def __init__(self,name,count):
        self.name = name
        self.count = count
    def __hash__(self):
        print("%s调用了哈希方法"%self.name)
        return hash(id(self))
    def __eq__(self, other):
        print("%s调用了eq方法")
        if self.__dict__ == other.__dict__:
            return True
        else:return False
f1 = Foo('f1',1)
f2 = Foo('f2',2)
f3 = Foo('f3',3)
ls = [f1,f2,f3]
print(set(ls))
从上述简单示例可以看出,set 方法似乎只是调用 hash 方法,然后根据哈希值是否相同来进行去重判断。但事实是否如此简单呢?请看下面的程序分析。
class Foo:
    def __init__(self,name,count):
        self.name = name
        self.count = count
    def __hash__(self):
        print("%s调用了哈希方法"%self.name)
        return hash(self.count)
    def __eq__(self, other):
        print("%s调用了eq方法"%self.name)
        return self.__dict__ == other.__dict__
f1 = Foo('f1',1)
f2 = Foo('f2',1)
f3 = Foo('f3',3)
ls = [f1,f2,f3]
print(set(ls))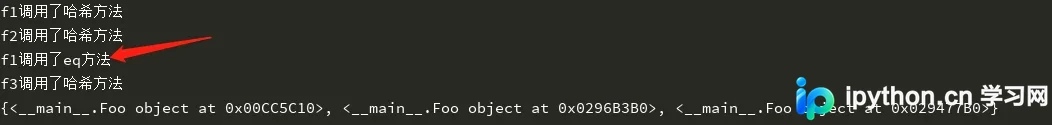
观察运行结果可以发现,实际上 f1 和 f3 的哈希值是相等的,但 set 并没有简单地据此判定 f1 和 f3 为重复元素。相反,它会进一步通过 __eq__ 方法判断这两个值是否真正相等,只有当 __eq__ 返回 True 时,才会认为这两个对象实际上是同一个,从而进行去重。为了验证这一说法,我们查看下面的代码示例。
f1 = Foo('f1',1)
f2 = Foo('f1',1)
f3 = Foo('f3',3)
ls = [f1,f2,f3]
print(set(ls))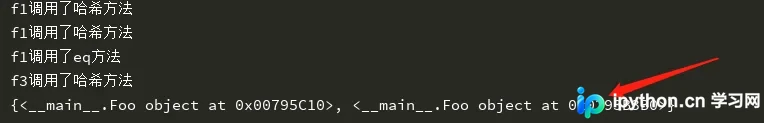
从输出结果可以看出,去重后的集合中只剩下两个元素,这证实了上述关于哈希冲突处理机制的说法。
三、结论
set 的去重机制是通过 __hash__ 和 __eq__ 两个函数结合实现的: 1. 当两个变量的哈希值不相同时,直接认为这两个变量是不同的; 2. 当两个变量的哈希值相同时(即发生哈希冲突),调用 __eq__ 方法进行比较。若返回值为 True,则认为这两个变量是同一个,应去除其中一个;若返回 False,则不去重,保留两个元素。
四、应用场景需求
假设有一个公司,现有 100 名员工。由于数据库不完善且使用时间较长,数据中存在大量重复记录需要清理。具体需求如下:
每位员工的属性包括:姓名、性别、年龄和部门。由于年龄和部门信息可能会发生变化,因此我们定义:只要两名员工的姓名和性别相同,即视为同一个人。
请根据上述规则实现员工数据的去重:
class Staff:
    def __init__(self,name,gender,age,department):
        self.name = name
        self.gender = gender
        self.age  = age
        self.department = department
    def __hash__(self):
        return hash(self.name+self.gender)
    def __eq__(self, other):
        return True
ls = ['zs','ls','ww','zq']
gender_list = ['man','femal']
staff_list = []
for i in range(100):
    staff_list.append(Staff(ls[i%4],gender_list[i%2],i,'class'))
print(set(staff_list))
print([(i.name,i.gender) for i in set(staff_list)])
到此这篇关于 python set() 去重的底层原理的文章就介绍到这了,更多相关 python set() 去重内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









