

利用Python多处理库高效处理3D数据:从7z存档到并行计算

本文详解如何使用Python的multiprocessing库高效处理存储在7z压缩包中的大量3D网格数据。通过自定义可迭代类实现流式读取,结合imap与tqdm实现进度监控,计算点云与网格间的最大距离以进行匹配。文章提供了完整代码示例,展示了如何在内存受限环境下利用多核并行加速3D计算机视觉任务。
引言:并行处理3D数据的必要性
在处理海量数据时,掌握高效的工具至关重要。本文将超越官方手册的基础介绍,分享一些实用的技巧,例如如何结合tqdm与multiprocessing的imap功能、并行处理压缩档案、绘制及处理3D数据,以及在点云数据中搜索相似对象网格的方法。
为何需要并行计算?在当今处理各类数据时,我们常面临“大数据”挑战。当数据量超过内存(RAM)容量时,必须分块处理。现代编程语言支持生成在多个核心处理器上高效运行的进程(甚至线程)。需要注意的是,这并不意味着单核处理器无法使用多处理,相关讨论可参考Stack Overflow上的相关线程。
本文旨在解决一个常见的3D计算机视觉任务:计算网格与点云之间的距离。例如,当需要从所有可用网格中找出与给定3D点云定义相同对象的网格时,便会遇到此类问题。
自定义7z归档数据接口
我们的数据由存储在.7z归档文件中的.obj文件组成,这种格式在存储效率方面表现优异。然而,访问其中的特定部分需要额外的工作。为此,我定义了一个封装7-zip归档并提供底层数据接口的类。
类 Archive7z(基础):
def __init__ ( self , file , password = None ):
# ...
自我。文件={}
# ...
对于信息的文件。文件:
#创建一个知道磁盘位置的ArchiveFile实例
file = ArchiveFile ( info , pos , src_pos , folder , self , maxsize = maxsize )
# ...
自我。文件。追加(文件)
# ...
自我。文件映射。更新([(X。文件名,X)为X的自我。文件])
#从files_map字典返回ArchiveFile的方法
def getmember ( self , name ):
if isinstance ( name , ( int , long )):
尝试:
回归自我。文件[名称]
除 了 IndexError:
返回无
回归自我。文件映射。获取(名称,无)
类 Archive7(基础):
定义读取(自我):
# ...
对于水平,编码器在枚举(自我。_folder。编码器):
# ...
#获取解码器并解码底层数据
data = getattr ( self , decoder ) ( coder , data , level , num_coders )
返回数据
该类几乎不依赖py7zlib包,它允许我们在每次调用get方法时解压缩数据,并提供归档中的文件数量。此外,我们定义了__iter__方法,这将帮助我们在该对象上启动多处理,使其表现得像一个可迭代对象。
众所周知,可以创建一个Python类来实例化可迭代对象。该类需满足两个条件:覆盖__getitem__以返回self,以及__next__以返回后续元素。我们严格遵循了这一规则。
上述定义赋予了我们遍历归档的能力,但它是否允许并行随机访问内容?这是一个有趣的问题,我在网上未找到现成答案,但我们可以研究py7zlib的源代码并自行解答。
在此,我提供了来自pylzma的代码片段:
类 Archive7z(基础):
def __init__ ( self , file , password = None ):
# ...
自我。文件={}
# ...
对于信息的文件。文件:
#创建一个知道磁盘位置的ArchiveFile实例
file = ArchiveFile ( info , pos , src_pos , folder , self , maxsize = maxsize )
# ...
自我。文件。追加(文件)
# ...
自我。文件映射。更新([(X。文件名,X)为X的自我。文件])
#从files_map字典返回ArchiveFile的方法
def getmember ( self , name ):
if isinstance ( name , ( int , long )):
尝试:
回归自我。文件[名称]
除 了 IndexError:
返回无
回归自我。文件映射。获取(名称,无)
类 Archive7z(基础):
定义读取(自我):
# ...
对于水平,编码器在枚举(自我。_folder。编码器):
# ...
#获取解码器并解码底层数据
data = getattr ( self , decoder ) ( coder , data , level , num_coders )
返回数据
从代码中可以看到,在从归档中读取下一个对象期间会调用相关方法。显然,只要同时多次读取归档,就没有理由阻止这种操作。
3D网格与点云基础概念
接下来,我们简要介绍网格和点云的概念。
首先,网格是顶点、边和面的集合。顶点由空间中的(x,y,z)坐标定义并分配唯一编号。边和面则是相应的点对和三元组,通过唯一的点ID进行定义。通常,“网格”指的是“三角形网格”,即由三角形组成的表面。使用trimesh库在Python中处理网格更为简便,例如它提供了加载.obj文件到内存的接口。若要在Jupyter Notebook中显示和交互3D对象,可以使用k3d库。
因此,通过以下代码片段,我回答了这个问题:“如何在Jupyter中使用k3d绘制trimesh对象?”
进口饰面
导入k3d
使用 open ( w. /data/meshes/stanford-bunny, obj")作为 f : bunny_mesh =网眼。力口载(f , 'obj')
情节=k3d。情节()
网格= k3d。网格 (bunny_mesh . vertices> bunny_mesh . faces) 绘图上网格
情节。显示。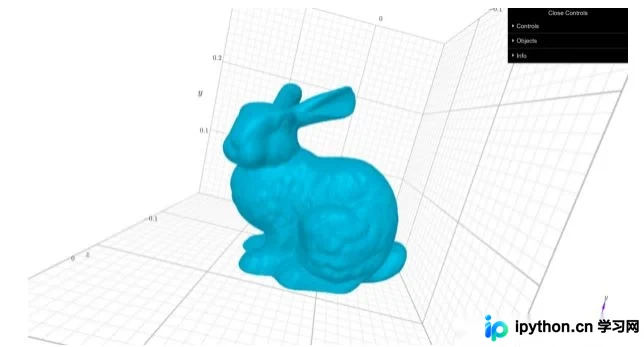
其次,点云是表示空间中对象的3D点数组。许多3D扫描仪生成点云作为扫描对象的表示。为了演示,我们可以读取相同的网格并将其顶点显示为点云。
进口饰面
导入k3d
使用 open ( w. /data/meshes/stanford-bunny, obj")作为 f :
bunny_mesh =网眼。力口载(f , 'obj')
情节=k3d。情节()
云=k3d。点(bunny_mesh . vertices , point_size = 0. 0001 , shader = "flat")
情节+=云
情节。显示。
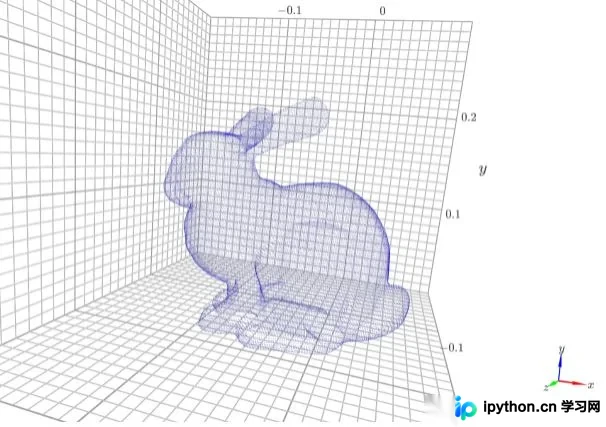
k3d绘制的点云效果如图所示。
基于最大距离的网格匹配算法
如上所述,3D扫描仪为我们提供了点云。假设我们有一个网格数据库,希望找到与扫描对象(即点云)对齐的网格。为解决此问题,我们可以提出一种简单方法:从归档中搜索给定点云与每个网格之间的最大距离。如果某些网格的距离小于1e-4,我们将认为该网格与点云对齐。
利用multiprocessing.Pool实现并行计算
最后,我们进入多处理部分。请记住,我们的归档中包含大量文件,可能无法全部加载到内存中,因此我们倾向于并行处理。为此,我们将使用multiprocessing.Pool,它通过map或imap/imap_unordered方法处理用户定义函数的多次调用。map和imap的区别在于,map在将可迭代对象发送到工作进程之前会将其转换为列表。如果归档太大无法写入RAM,则不应将其解压缩到Python列表中。换句话说,两者的执行速度相似。
[加载网格:pool.map w/o manager] 4 个进程的池经过时间:37.213207403818764 秒
[加载网格:pool.imap_unordered w/o manager] 4 个进程的池经过时间:37.219303369522095 秒
上面展示了从适合内存的网格归档中简单读取的结果。
进一步探讨imap:让我们讨论如何实现目标,即找到靠近点云的网格。数据方面,我们有5种来自斯坦福模型的不同网格。我们将通过向斯坦福兔子网格的顶点添加噪声来模拟3D扫描。
将numpy导入为np
A numpy。随机 导入 defaulting
def normalize_pc (点):
   点额=点额-点额。平均值(轴=0)[无,:]
   分布=np。linalg<>范数(点,轴=1) scaled_points =点 / dists中。最大值。 返回 scaled_points
def load_bunny_pc ( bunny_path ):
   标准差=lₑ-3
   使用 open ( bunny_path )作为 f : bunny_mesh = load_mesh ( f )
   #标准化后云
   scaled_bunny = normalize_pc ( bunny_mesh . vertices )
   #向点云添加一些噪声 rng = defaulting ()
   噪音=rng。正常(0. 0 , STD , scaled_bunny . shape ) 畸变兔子=缩放兔子+噪声
    返回 di st ort ed_bunny
当然,我们之前已将点云和网格顶点归一化,以便在3D立方体中缩放它们。
要计算点云和网格之间的距离,我们将使用igl。为了完成此任务,我们需要编写一个函数来调用每个进程及其依赖项。总结如下:
导入迭代工具
导入时间
将 numpy 导入为 np
  nwnpyo 随机导入 default rng
面以1 口口如 进进从
A多处理导入池
de£ load_mesh ( obj_file ):
   目二 trimesh。力口载(obj_file , ' obj')
   返回网格
def get_max__dist ( basjmesh , point_cloud ):
   distance_sq , mesh_face__indexes , _ = igl。point_mesh_squared_distance (
       点云,
       basjmesho 顶点,
       basjmesho 面孔
   )
   返回distancjsq。最大值0
def 1 oad_mesh__get_di stance ( args ):
   obj_file , point__cloud = args [ 0 ]/ args [ 1 ]
   网格二 load_mesh ( obj_file )
   网。顶点=RormaliNe_pc (网格。顶点)
   max_dist = get_max_dist (网格,点云)
   返回 max__dist
de£ read_meshes__get__di stances_pool__imap ( archive_path , point_cloud , nwn_proc , nwn_i terations ):
   #在疝中进行向格“理
   elapsed__time =[]
   为一在 范围(nujn-i terati ons ):
      归档二 MeshesArchive (ARCHIVE-PATH)
      池二池(nwn_proc )
      开始=时间。时间0
      导致=名单(tqdm(池。IMAP (
         1 o ad_m e sh__ge t_di s t anc e ,
         zip (存档,itertoolso 重复(point_cloud)),
      ),总计=len辱档)))
      池。关闭0
      池。加入o
      结束=时间。时间0
      elapsed time o追加(结束一开始)
   print ( F [Process meshes: pool, imap] {num_proc}个进程的池经过的时间:{np. array (elapsed_time). mean()} sec )
   对于 name , di st in zip ( archive . namesjist , result ): 打印(r{name} {dist}")
   返回结果
如果 _name_ ==
   bunny_path =  /data/meshes/stanford-bunny, obj"
   archive_path = /data/meshes. 7zff
   nwn_proc = 4
   num_iterations = 3
   point__cloud - load__bunny_pc ( bunny_path )
     read_meshes__get__di stances_pool_no_manager__imap ( archive_path ,point_cloud , nwn_proc , num.
iterations )
这个read_meshes_get_distances_pool_imap是核心函数,其中执行以下操作:
- 初始化MeshesArchive和multiprocessing.Pool。
- 使用tqdm观察池进度,并手动完成整个池的分析。
- 输出执行结果。
请注意我们如何传递参数给imap,使用zip(archive, itertools.repeat(point_cloud))。这允许我们将点云数组附加到归档的每个条目上,避免将archive转换为列表。
执行结果如下:
100%|########################################### #####################| 5/5 [00:00<00:00, 5.14it/s]
100%|########################################### #####################| 5/5 [00:00<00:00, 5.08it/s]
100%|########################################### #####################| 5/5 [00:00<00:00, 5.18it/s]
[进程网格:pool.imap w/o manager] 4 个进程的池经过时间:1.0080536206563313 秒
犰狳.obj 0.16176825266293382
野兽.obj 0.28608649819198073
牛.obj 0.41653845909820164
现货.obj 0.22739556571296735
stanford-bunny.obj 2.3699851136074263e-05
实验结果与总结
我们可以注意到斯坦福兔子是最接近给定点云的网格。此外,尽管我们没有使用大量数据,但已证明即使归档中包含大量网格,该解决方案依然有效。
多处理使数据科学家不仅在3D计算机视觉中,而且在机器学习的其他领域都取得了出色表现。理解并行执行比在循环内执行快得多至关重要。差异在正确编写算法时变得显著。大量数据揭示了如果没有关于如何使用有限资源的创造性方法,许多问题将无法解决。幸运的是,Python语言及其广泛的库集帮助我们数据科学家解决了这些问题。
到此这篇关于利用Python多处理库处理3D数据详解的文章就介绍到这了,更多相关Python处理3D数据内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









