

pandas列转行与行转列实战:melt、stack与unstack详解

本文详细解析pandas中数据长宽转换的核心方法。通过对比set_index、stack与melt函数,演示列转行的多种实现路径;深入讲解unstack与pivot在行转列中的应用。结合多级索引处理、缺失值填充及实际案例,帮助开发者掌握高效的数据重塑技巧。
一、列转行
1、背景描述
在常规数据处理场景中,我们常遇到如下格式的数据结构:
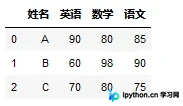
而在进行统计分析时,通常需要将数据转换为以下格式:
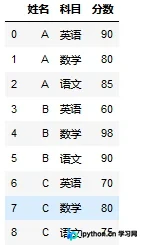
2.方法描述
准备数据
df = pd.DataFrame({'姓名': ['A','B','C'],
                  '英语':[90,60,70],
                  '数学':[80,98,80],
                  '语文':[85,90,75]})
实现该转换有多种方式,此处集中展示几种常见做法。
2.1 方法1
tmp=df.set_index(['姓名']).stack()
tmp2=tmp.rename_axis(index=['姓名','科目'])
tmp2.name='分数'
tmp2.reset_index()
2.2 方法2
tmp=df.set_index(['姓名']).stack()
tmp.index.names=['姓名','科目']
tmp.reset_index(name='分数')
2.3 方法3
tmp=df.set_index(['姓名']).stack().reset_index()
tmp.columns=['姓名','科目','分数']
2.4 方法4
tmp=pd.melt(df,id_vars='姓名',var_name='科目',value_name='分数')
3 思考与总结
通过上述对比,相信读者已了解各方法的优劣。接下来重点解析melt函数。该函数主要包含以下参数:
frame:待处理的数据帧。id_vars:指定不参与列转行的字段,若不设置则默认处理所有列。value_vars:指定参与列转行的字段,不指定则处理所有非id_vars列。var_name:定义转换后生成字段列的名称,用于重命名原列名。value_name:定义转换后生成数值列的名称,用于重命名原数值。col_level:指定列名层级,适用于多级列名场景。
4 思维延伸
4.1 例子1
转换前:
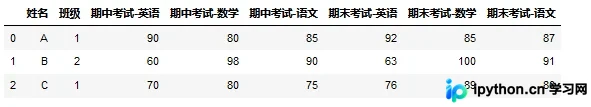
转换后:
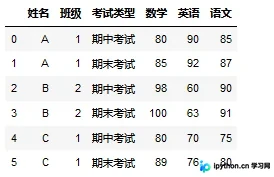
实现的一种方法:
#准备数据
df2 = pd.DataFrame({'姓名': ['A', 'B', 'C'],
                    '班级':[1,2,1],
                    '期中考试-英语': [90, 60, 70],
                    '期中考试-数学': [80, 98, 80],
                    '期中考试-语文': [85, 90, 75],
                    '期末考试-英语': [92, 63, 76],
                    '期末考试-数学': [85,100, 89],
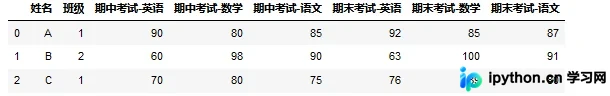
                    '期末考试-语文': [87, 91, 80]})
#实现部分
t1=pd.melt(df2, id_vars=['姓名','班级'],  var_name='科目', value_name='分数')
t2=t1.set_index(['姓名','班级','分数'])['科目'].str.split('-',expand=True).reset_index()
t2.set_index(['姓名','班级',0,1]).unstack().reset_index().rename_axis()
t3=t2.set_index(['姓名','班级',0,1]).unstack()
t3.columns=t3.columns.droplevel(0)
result=t3.rename_axis(columns=None).reset_index().rename(columns={0:'考试类型'})
result
4.2 例子2
转换前:
转换后:
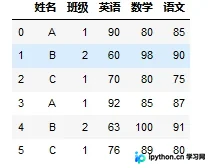
实现方法举例:
pd.lreshape(df2,{'英语':['期中考试-英语','期末考试-英语'],
                '数学':['期中考试-数学','期末考试-数学'],
                '语文':['期中考试-语文','期末考试-语文']})
二、行转列
在前文第一部分中,我们完成了列转行任务,即将多列数据转换为tmp格式。若需执行反向操作,即行转列,该如何处理?
1.准备数据
tmp=pd.DataFrame({'姓名':['A', 'B', 'C', 'A', 'B', 'C', 'A', 'B', 'C'],
             '科目':['英语', '英语', '英语', '数学', '数学', '数学', '语文', '语文', '语文'],
             '分数':[90, 60, 70, 80, 98, 80, 85, 90, 75]})
tmp
2.行转列实现
2.1 方法1
tmp2=tmp.set_index(['姓名','科目'])['分数'].unstack()
df=tmp2.rename_axis(columns=None).reset_index()
2.2 方法2
tmp2=tmp.set_index(['姓名','科目'])['分数'].unstack()
df=tmp2.rename_axis(columns=None).reset_index()
2.3 方法3
df=tmp.pivot(index='姓名',columns='科目',values='分数').rename_axis(columns=None).reset_index()
3.思考与总结
从行转列示例可见,核心函数为unstack。该函数将多重索引数据转换为标准表格形式,主要包含两个参数:
level:指定取消堆叠的索引级别,可传递级别名称,默认值为-1(即最后一个索引)。fill_value:若取消堆叠后存在缺失数据,指定以固定字符填充。
三、行列转换(长宽互换)
(1) stack和unstack
California   2000 33871648

                2010 37253956

New York  2000 18976457

                2010 19378102

Texas        2000 20851820

                2010 25145561
以上述数据为例
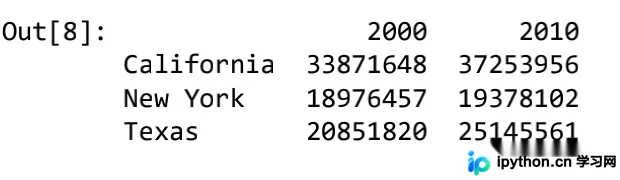
new_df = pop.unstack()

new_df
unstack()方法可快速将多级索引Series转化为普通索引DataFrame;stack则可将列转化为索引。
来看一个实际的行列互换例子
列转行
import pandas as pd

df = pd.read_csv('data/pew.csv')

df.head(10)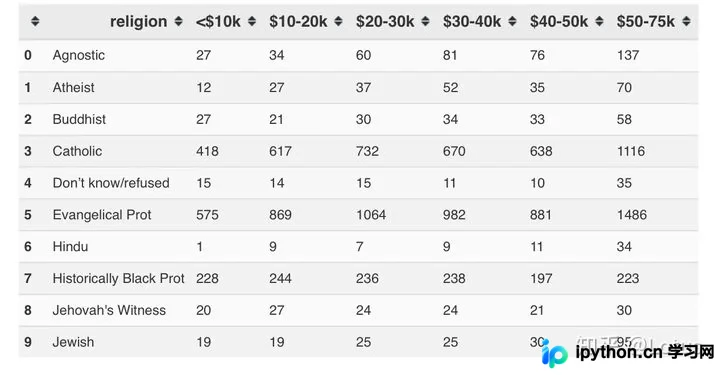
df = df.set_index('religion') #先把religion设为索引

df = df.stack() #将列转化为二级索引

df.index = df.index.rename('income', level=1) #二级索引命命

df.name = 'frequency'

df = df.reset_index() #将索引转化为Series

df.head(10)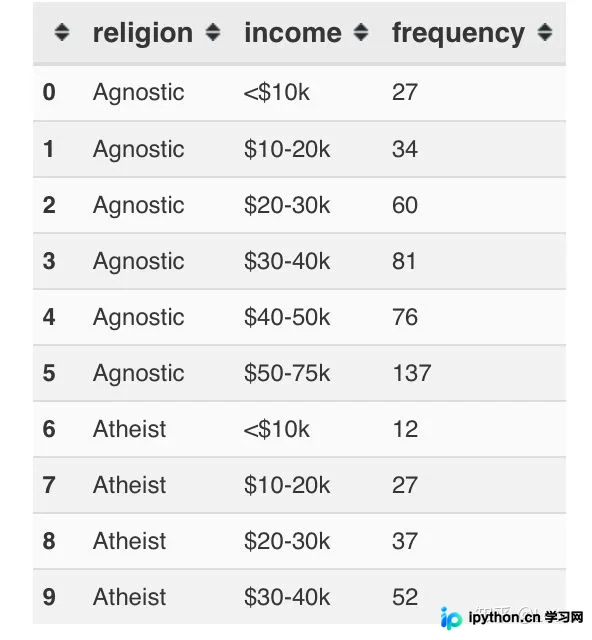
上述转化可视为宽表转长表,便于记忆:将具有相同特征的一组列合并为一列,使表格变窄;同时为保持一一对应关系,需与其他列组合,从而使表格变长。
总结
至此,关于pandas列转行及行转列的讲解结束。如需了解更多相关内容,请搜索本站往期文章或继续浏览后续文章。感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









