

Python数据化运营实战:KMeans聚类分析与评估指标详解

本文详细介绍Python中KMeans聚类算法在数据化运营中的应用,涵盖用户群体分类、产品价值组合及异常值发现等场景。重点解析Inertias、调整兰德指数、轮廓系数等核心评估指标的计算方法与意义,并提供完整的代码实现与可视化方案,助力提升运营精细化水平。
内容介绍
本文通过Python使用KMeans算法进行聚类分析的简单示例,来介绍聚类分析的基本应用。
聚类分析(或简称聚类)旨在将一组对象划分为若干组,使得同一组(即聚类)内的对象彼此相似,而与其他组中的对象差异较大。
作为探索性数据挖掘的核心任务之一,聚类也是统计分析的常用技术手段,广泛应用于机器学习、模式识别、图像分析、信息检索、生物信息学、数据压缩及计算机图形学等多个领域。
一般应用场景
目标用户的群体分类:
基于运营或商业目标选取特定变量,对目标群体进行聚类划分,将其细分为具有显著特征差异的子群体。在运营活动中,针对这些细分群体实施精细化、个性化的运营与服务策略,从而提升运营效率与商业效果。
不同产品的价值组合:
依据特定指标变量对众多产品种类进行聚类分析,将产品体系细分为具有不同价值定位、不同使用目的及多维度组合的产品集群。在此基础上,制定相应的产品开发计划、运营计划和服务计划。
探索、发现孤立点及异常值:
主要应用于风控领域。孤立点可能蕴含欺诈风险成分,通过聚类识别这些异常值有助于风险管控。
聚类的常见方法
聚类算法主要分为基于划分、层次、密度、网格、统计学及模型等类型。典型算法包括经典的K均值(K-Means)、DBSCAN、两步聚类、BIRCH以及谱聚类等。
KMeans聚类实现
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn import metrics
import random
# 随机生成100组包含3组特征的数据
feature = [[random.random(),random.random(),random.random()] for i in range(100)]
label = [int(random.randint(0,2)) for i in range(100)]
# 转换数据格式
x_feature = np.array(feature)
# 训练聚类模型
n_clusters = 3  # 设置聚类数量
model_kmeans = KMeans(n_clusters=n_clusters, random_state=0)  # 建立聚类模型对象
model_kmeans.fit(x_feature)  # 训练聚类模型
y_pre = model_kmeans.predict(x_feature)  # 预测聚类模型
y_pre

聚类的评估指标
inertias
这是K均值模型对象的一个属性,表示所有样本到其最近聚类中心的距离总和。它作为在没有真实分类结果标签情况下的无监督评估指标。
该值越小越好,数值越小表明样本在类间的分布越集中,即类内距离越小,聚类效果越好。
# 样本距离最近的聚类中心的总和
inertias = model_kmeans.inertia_
adjusted_rand_s:
调整后的兰德指数(Adjusted Rand Index)。兰德指数通过考虑在预测聚类和真实聚类中分配在相同或不同聚类中的所有样本对和计数对,来计算两个聚类之间的相似性度量。
调整后的兰德指数通过对兰德指数的调整,得到独立于样本量和类别数量的接近于0的值。其取值范围为[-1, 1],负数代表结果较差,越接近于1表示聚类结果与真实情况越吻合。
# 调整后的兰德指数
adjusted_rand_s = metrics.adjusted_rand_score(label, y_pre)
mutual_info_s:
互信息(Mutual Information, MI)。互信息衡量一个随机变量中包含的关于另一个随机变量的信息量,在此处指相同数据的两个标签之间相似度的度量,结果为非负值。
# 互信息
mutual_info_s = metrics.mutual_info_score(label, y_pre)
adjusted_mutual_info_s:
调整后的互信息(Adjusted Mutual Information, AMI)。这是互信息评分的调整得分。
它考虑到了具有更多聚类群时,无论实际上是否有更多信息共享,MI通常较高的情况,通过调整聚类群的概率来纠正这种影响。
当两个聚类集完全相同(即完全匹配)时,AMI返回值为1;随机分区(独立标签)的平均预期AMI约为0,也可能为负数。
# 调整后的互信息
adjusted_mutual_info_s = metrics.adjusted_mutual_info_score(label, y_pre)
homogeneity_s:
同质化得分(Homogeneity)。如果所有聚类都只包含属于单个类的成员的数据点,则聚类结果满足同质性。其取值范围[0,1],值越大意味着聚类结果与真实情况越吻合。
# 同质化得分
homogeneity_s = metrics.homogeneity_score(label, y_pre)
completeness_s:
完整性得分(Completeness)。如果作为给定类成员的所有数据点都是相同集群的元素,则聚类结果满足完整性。其取值范围[0,1],值越大意味着聚类结果与真实情况越吻合。
# 完整性得分
completeness_s = metrics.completeness_score(label, y_pre)
v_measure_s:
它是同质化和完整性之间的调和平均值,计算公式为 v = 2 * (均匀性 * 完整性) / (均匀性 + 完整性)。其取值范围[0,1],值越大意味着聚类结果与真实情况越吻合。
v_measure_s = metrics.v_measure_score(label, y_pre)
silhouette_s:
轮廓系数(Silhouette)。它用于计算所有样本的平均轮廓系数,通过平均群内距离和每个样本的平均最近簇距离来计算。这是一种无监督评估指标。其最高值为1,最差值为-1,0附近的值表示聚类存在重叠,负值通常表示样本被分配到了错误的集群。
# 平均轮廓系数
silhouette_s = metrics.silhouette_score(x_feature, y_pre, metric='euclidean')
calinski_harabaz_s:
该分数定义为群内离散度与簇间离散度的比值,它是一种无监督评估指标。
# Calinski和Harabaz得分
calinski_harabaz_s = metrics.calinski_harabasz_score(x_feature, y_pre)
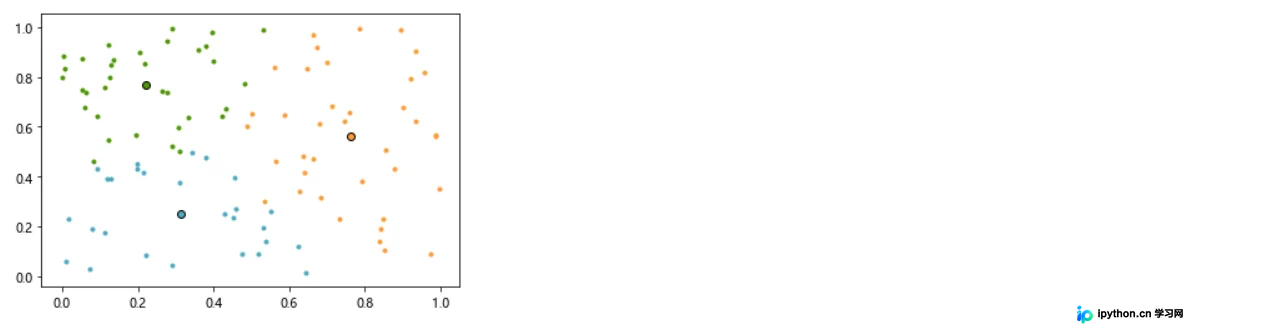
聚类效果可视化
# 模型效果可视化
centers = model_kmeans.cluster_centers_  # 各类别中心
colors = ['#4EACC5', '#FF9C34', '#4E9A06']  # 设置不同类别的颜色
plt.figure()  # 建立画布
for i in range(n_clusters):  # 循环读类别
    index_sets = np.where(y_pre == i)  # 找到相同类的索引集合
    cluster = x_feature[index_sets]  # 将相同类的数据划分为一个聚类子集
    plt.scatter(cluster[:, 0], cluster[:, 1], c=colors[i], marker='.')  # 展示聚类子集内的样本点
    plt.plot(centers[i][0], centers[i][1], 'o', markerfacecolor=colors[i], markeredgecolor='k',
             markersize=6)  # 展示各聚类子集的中心
plt.show()  # 展示图像
数据预测
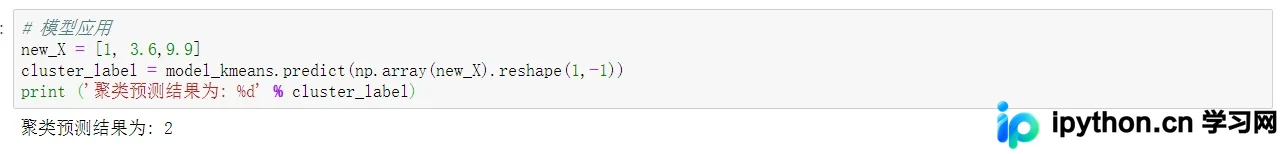
# 模型应用
new_X = [1, 3.6,9.9]
cluster_label = model_kmeans.predict(np.array(new_X).reshape(1,-1))
print ('聚类预测结果为: %d' % cluster_label)
以上就是分析总结Python数据化运营KMeans聚类的详细内容,更多关于Python数据化运营KMeans聚类的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









