

Python关联规则分析:从原理到代码实现详解

发布时间:2026-10-14| 5人浏览过
本文详解Python中关联规则分析的核心原理与实现方法。通过啤酒与尿布的典型案例,阐述支持度与置信度的定义及计算逻辑,并提供基于pandas的自定义Apriori算法代码示例,帮助开发者掌握从数据预处理到规则提取的完整流程。
内容介绍
本文将以Python为例,简要演示关联规则分析的具体应用方式。
关联规则,亦常被称为购物篮分析,主要用于挖掘数据集中各项商品或变量之间存在的潜在关联关系。
一般应用场景
在关联规则分析的历史上,最著名的案例莫过于“啤酒与尿布”。据传,沃尔玛超市在分析顾客购买记录时发现,许多购买啤酒的顾客同时也购买了婴儿尿布。基于这一发现,超市调整了货架布局,将这两类商品相邻摆放,最终显著提升了双方的销量。分析认为,这一现象源于刚生小孩的男士在选购啤酒时,往往会顺手购买婴幼儿用品。
此后,该分析方法被引申至更多场景,用于分析变量间的相互关系。总体而言,关联规则分析主要处理的是类别型变量。
关联规则实现
import pandas as pd
from apriori_new import * #导入自行编写的apriori函数
import time #导入时间库用来计算用时
import re
import random
import pandas as pd
# 自定义关联规则算法
def connect_string(x, ms):
    x = list(map(lambda i: sorted(i.split(ms)), x))
    l = len(x[0])
    r = []
    # 生成二项集
    for i in range(len(x)):
        for j in range(i, len(x)):
            #      if x[i][l-1] != x[j][l-1]:
            if x[i][:l - 1] == x[j][:l - 1] and x[i][l - 1] != x[j][
                l - 1]:  # 判断数字和字母异同,初次取字母数字不全相同(即不同症状(字母),或同一证型程度不同(数字))
                r.append(x[i][:l - 1] + sorted([x[j][l - 1], x[i][l - 1]]))
    return r
# 寻找关联规则的函数
def find_rule(d, support, confidence, ms=u'--'):
    result = pd.DataFrame(index=['support', 'confidence'])  # 定义输出结果
    support_series = 1.0 * d.sum() / len(d)  # 支持度序列
    column = list(support_series[support_series > support].index)  # 初步根据支持度筛选,符合条件支持度,共 276个index证型
    k = 0
    while len(column) > 1:  # 随着项集元素增多 可计算的column(满足条件支持度的index)会被穷尽,随着证型增多,之间的关系会越来越不明显,(同时发生可能性是小概率了)
        k = k + 1
        print(u'\n正在进行第%s次搜索...' % k)
        column = connect_string(column, ms)
        print(u'数目:%s...' % len(column))
        sf = lambda i: d[i].prod(axis=1, numeric_only=True)  # 新一批支持度的计算函数
        len(d)
        # 创建连接数据,这一步耗时、耗内存最严重。当数据集较大时,可以考虑并行运算优化。
        # 依次对column每个元素(如[['A1', 'A2'], ['A1', 'A3']]中的['A1', 'A2'])运算,计算data_model_中对应该行的乘积,930个,若['A1', 'A2']二者同时发生为1则此行积为1
        d_2 = pd.DataFrame(list(map(sf, column)),index=[ms.join(i) for i in column]).T  # list(map(sf,column)) 276X930  index 276
        support_series_2 = 1.0 * d_2[[ms.join(i) for i in column]].sum() / len(d)  # 计算连接后的支持度
        column = list(support_series_2[support_series_2 > support].index)  # 新一轮支持度筛选
        support_series = support_series.append(support_series_2)
        column2 = []
        for i in column:  # 遍历可能的推理,如{A,B,C}究竟是A+B-->C还是B+C-->A还是C+A-->B?
            i = i.split(ms)  # 由'A1--B1' 转化为 ['A1', 'B1']
            for j in range(len(i)):  #
                column2.append(i[:j] + i[j + 1:] + i[j:j + 1])
        cofidence_series = pd.Series(index=[ms.join(i) for i in column2])  # 定义置信度序列
        for i in column2:  # 计算置信度序列  如i为['B1', 'A1']
            # i置信度计算:i的支持度除以第一个证型的支持度,表示第一个发生第二个发生的概率
            cofidence_series[ms.join(i)] = support_series[ms.join(sorted(i))] / support_series[ms.join(i[:len(i) - 1])]
        for i in cofidence_series[cofidence_series > confidence].index:  # 置信度筛选
            result[i] = 0.0  # B1--A1    0.330409  A1--B1    0.470833,绝大部分是要剔除掉的,初次全剔除
            result[i]['confidence'] = cofidence_series[i]
            result[i]['support'] = support_series[ms.join(sorted(i.split(ms)))]
    result = result.T.sort_values(by=['confidence', 'support'],ascending=False)  # 结果整理,输出,先按confidence升序,再在confidence内部按support升序,默认升序,此处降序
    return result
关联规则应用举例
sku_list = [
    '0000001','0000002','0000003','0000004','0000005',
    '0000006','0000007','0000008','0000009','0000010',
    '0000011','0000012','0000013','0000014','0000015',
    '0000016','0000017','0000018','0000019','0000020',
    'A0000001','A0000002','A0000003','A0000004','A0000005',
    'A0000006','A0000007','A0000008','A0000009','A0000010',
    'A0000011','A0000012','A0000013','A0000014','A0000015',
    'A0000016','A0000017','A0000018','A0000019','A0000020',
]
# 随机抽取数据生成列表
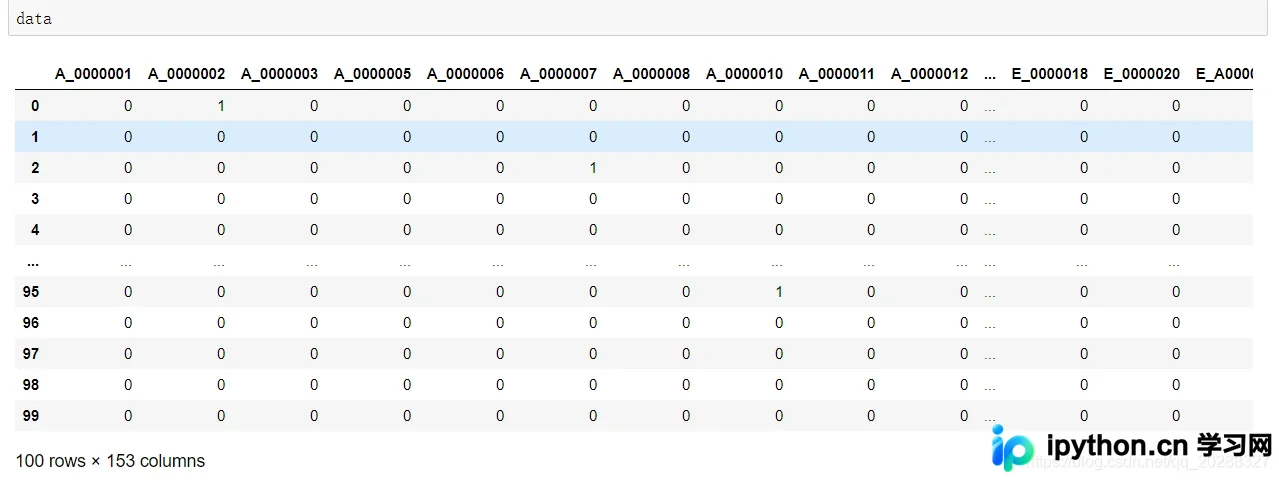
mat = [ random.sample(sku_list, random.randint(2,5))  for i in range(100)]
data = pd.DataFrame(mat,columns=["A","B","C","D","E"])
data = pd.get_dummies(data) # 转换类别变量矩阵
data = data.fillna(0)
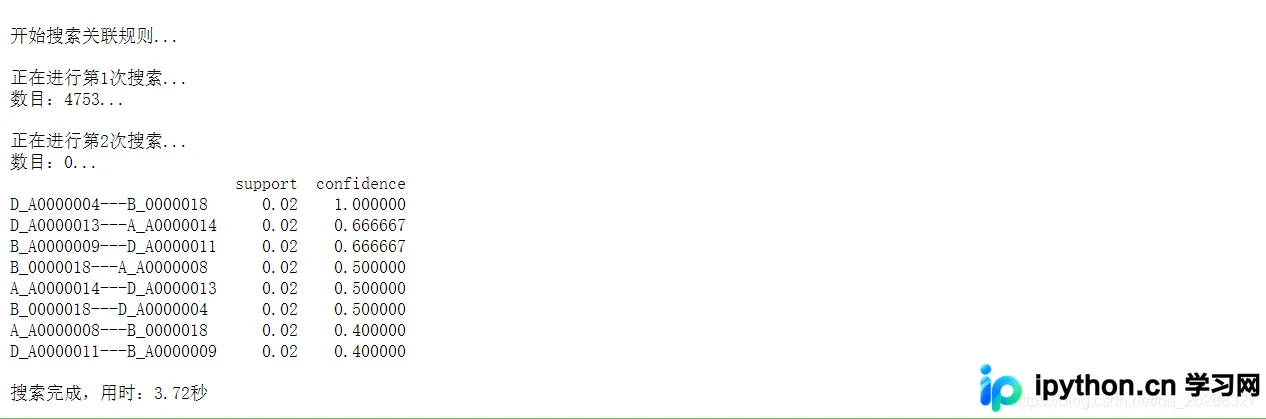
- 支持度:用于衡量项集{X,Y}在整个数据集中出现的概率。
- 置信度:表示在前提条件X发生的情况下,由关联规则“X→Y”推导出Y的概率。它反映了在发生X的项集中,同时发生Y的可能性,即X和Y同时出现的次数占仅X出现次数的比例。
support = 0.01 #最小支持度
confidence = 0.05 #最小置信度
ms = '---' #连接符,默认'--',用来区分不同元素,如A--B。需要保证原始表格中不含有该字符
start = time.clock() #计时开始
print(u'\n开始搜索关联规则...')
print(find_rule(data, support, confidence, ms))
end = time.clock() #计时结束
print(u'\n搜索完成,用时:%0.2f秒' %(end-start))
以上即为关于Python数据化运营中关联规则分析的详细内容,更多相关技术资料请查阅本站其他文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









