

Python pandas中众数与分位数的计算方法详解

本文详细介绍Python pandas库中众数(mode)和分位数(quantile)的计算方法。通过具体代码示例,演示如何对全表、单行、单列及多行多列进行众数和分位数统计,并对比pandas的quantile与numpy的percentile在分组计算中的差异与用法。
准备工作
本文所使用的示例数据表格如下所示:
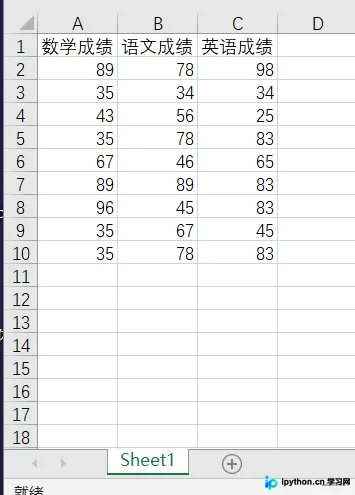
首先查看原始数据的状态:
import pandas as pd
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df)
运行结果如下:
数学成绩 语文成绩 英语成绩 0 89 78 98 1 35 34 34 2 43 56 25 3 35 78 83 4 67 46 65 5 89 89 83 6 96 45 83 7 35 67 45 8 35 78 83
1. 计算众数
1.1 针对整个数据表的操作
1.1.1 计算每一列的众数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.var())
运行结果如下:
数学成绩 语文成绩 英语成绩 0 35 78 83
1.1.2 计算每一行的众数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.mode(axis=1))
运行结果如下:
0 1 2 0 78.0 89.0 98.0 1 34.0 NaN NaN 2 25.0 43.0 56.0 3 35.0 78.0 83.0 4 46.0 65.0 67.0 5 89.0 NaN NaN 6 45.0 83.0 96.0 7 35.0 45.0 67.0 8 35.0 78.0 83.0
1.2 针对单独某一行或某一列的操作
1.2.1 计算单独某一列的众数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.mode(axis=1))
运行结果如下:
0 35 dtype: int64
1.2.2 计算单独某一行的众数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.iloc[[0]].mode())
运行结果如下:
数学成绩 语文成绩 英语成绩 0 89 78 98
1.3 针对多行或多列的操作
1.3.1 计算多列的众数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df[['数学成绩', "语文成绩"]].mode())
运行结果如下:
数学成绩 语文成绩 0 35 78
1.3.2 计算多行的众数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.iloc[[0, 1]].mode())
运行结果如下:
数学成绩 语文成绩 英语成绩 0 35 34 34 1 89 78 98
2. 计算分位数
分位数是一种基于位置更细致的统计指标,相比中位数提供了更多信息。常见的分位数包括四分之一分位数(25%)、二分之一分位数(即中位数,50%)以及四分之三分位数(75%)。
2.1 计算不同分位点的分位数
2.1.1 计算四分之一分位数
import pandas as pd
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.quantile(0.25))
运行结果如下:
数学成绩 35.0 语文成绩 46.0 英语成绩 45.0 Name: 0.25, dtype: float64
2.1.2 计算四分之三分位数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.quantile(0.75))
运行结果如下:
数学成绩 89.0 语文成绩 78.0 英语成绩 83.0 Name: 0.75, dtype: float64
2.2 针对整个数据表的操作
2.2.1 计算每一列的分位数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.quantile(0.25))
运行结果如下:
数学成绩 35.0 语文成绩 46.0 英语成绩 45.0 Name: 0.25, dtype: float64
2.2.2 计算每一行的分位数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.quantile(0.25, axis=1))
运行结果如下:
0 83.5 1 34.0 2 34.0 3 56.5 4 55.5 5 86.0 6 64.0 7 40.0 8 56.5 Name: 0.25, dtype: float64
2.3 针对单独一行或一列的操作
2.3.1 计算某一列的分位数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df['数学成绩'].quantile(0.25))
运行结果如下:
35.0
2.3.2 计算某一行的分位数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.iloc[[0]].quantile(0.25))
运行结果如下:
数学成绩 89.0 语文成绩 78.0 英语成绩 98.0 Name: 0.25, dtype: float64
2.4 针对多行或多列的操作
2.4.1 计算多列的分位数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df[['数学成绩', "语文成绩"]].quantile(0.25))
运行结果如下:
数学成绩 35.0 语文成绩 46.0 Name: 0.25, dtype: float64
2.4.2 计算多行的分位数
df = pd.read_excel(r'C:\Users\admin\Desktop\测试.xlsx')
print(df.iloc[[0, 1]].quantile(0.25))
运行结果如下:
数学成绩 48.5 语文成绩 45.0 英语成绩 50.0 Name: 0.25, dtype: float64
附录:pandas与numpy计算分位数的区别
pandas和numpy库均提供了计算分位数的功能,其中pandas使用quantile方法,而numpy使用percentile方法。
这两种方法在计算原理上基本一致,主要区别在于用法。quantile的一个显著优势是可以与pandas中的groupby函数结合使用,从而方便地计算每个分组内的特定分位数。
使用quantile的代码示例如下:
import pandas as pd
import numpy as np
data = pd.read_csv('order_rank_p_0409.txt',sep='\t')
#将data按id_1 和 id_2 分组
grouped=data.groupby(['id_1','id_2'])
#用quantile计算第40%的分位数
grouped['gmv'].quantile(0.4)
#用to_csv生成文件
x.to_csv('order_ran_re.txt',sep= '\t')
使用percentile的代码示例如下:
import pandas as pd
import numpy as np
data = pd.read_csv('order_rank_p_0409.txt',sep='\t')
a = array(data['gmv'])
np.percentile(a,0.4)
尽管代码写法不同,但两种方法计算得出的结果是相同的。
总结
至此,关于Python pandas中众数和分位数的介绍已完成。如需了解更多pandas众数和分位数相关内容,请查阅本站过往文章或继续阅读后续教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









