

DeepSeek网页版怎么导出历史对话?数据管理与隐私设置说明

在数字化工作流中,我们习惯于将重要信息“落袋为安”。无论是会议纪要还是代码片段,一旦生成,第一反应往往是保存或备份。然而,在使用DeepSeek网页版进行深度思考或创意发散时,许多用户会遭遇一个尴尬的断层:对话记录静静地躺在左侧侧边栏,却找不到一个显眼的“导出”按钮。
这种缺失并非技术无能,而往往源于产品对“轻量化”与“云端同步”的侧重。但对于需要归档项目资料、构建个人知识库或单纯出于数据主权意识的用户来说,无法本地化保存历史对话是一种明显的体验短板。在官方未提供原生导出接口之前,理解现有的数据管理机制并掌握变通方法,比等待功能更新更为务实。
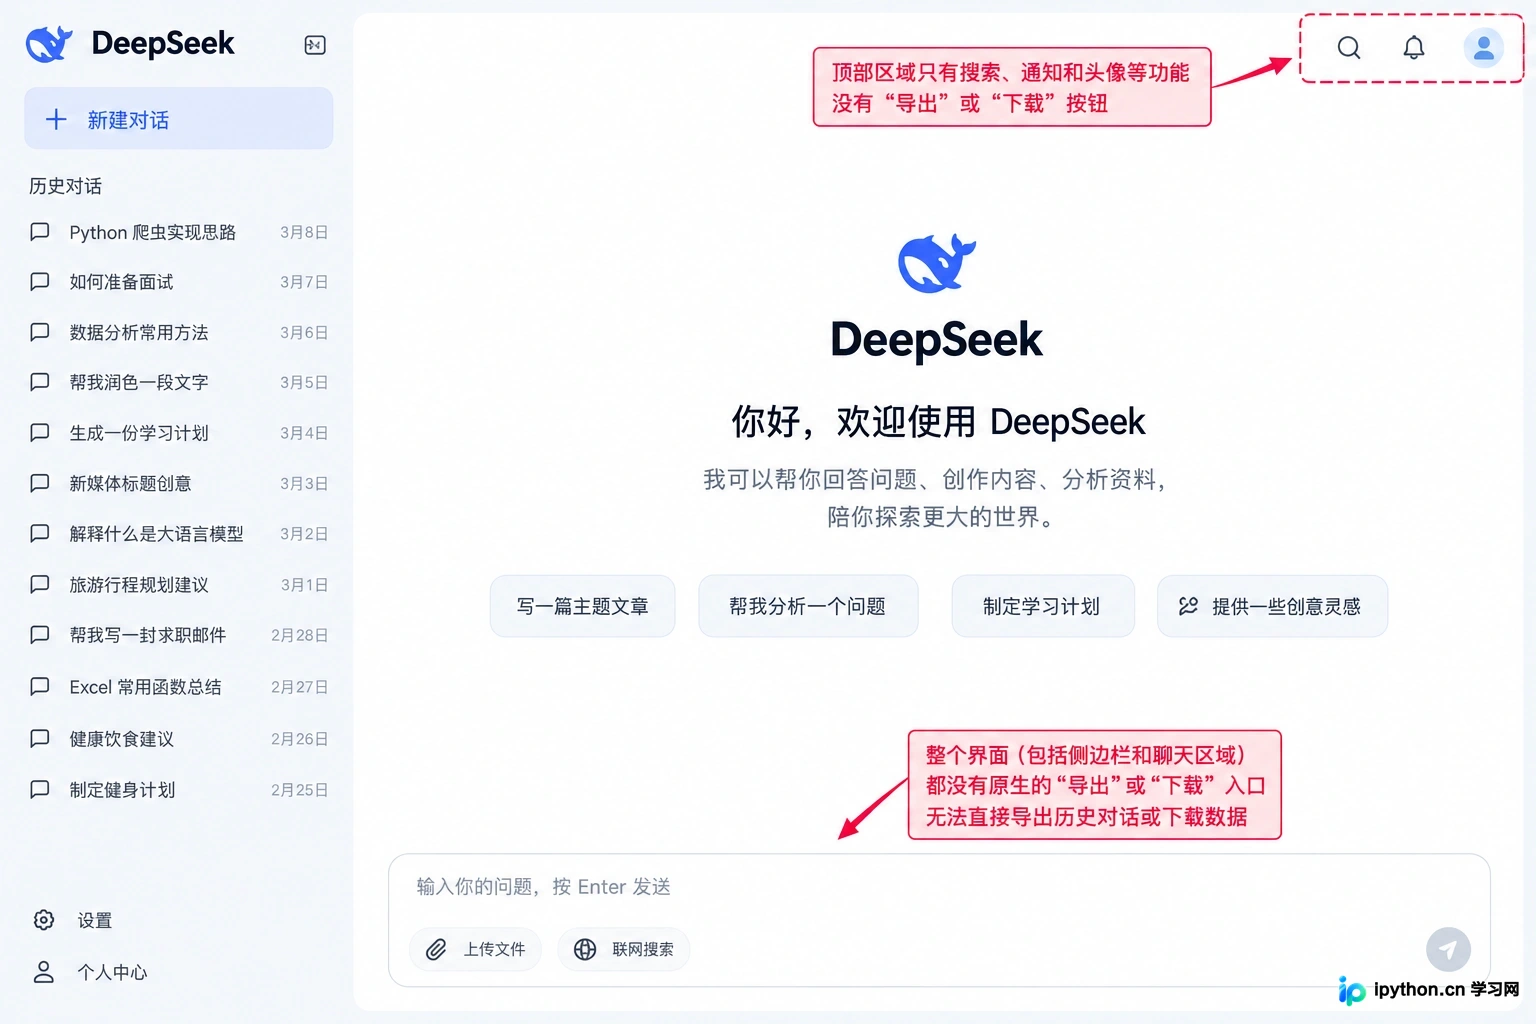
DeepSeek网页版侧边栏界面,展示了历史对话列表,但缺乏原生的数据导出入口
曲线救国:浏览器原生的“物理”导出法
既然DeepSeek网页版目前未内置JSON或Markdown格式的批量导出功能,我们需要将视角从应用内部转移到承载它的容器——浏览器。网页的本质是HTML文档,这意味着任何你在屏幕上看到的内容,理论上都可以被捕获。
对于单篇高质量对话的保存,最稳妥且格式保留最完整的方式是利用浏览器的“打印”功能。这听起来有些复古,但它能完美保留对话的层级结构、代码块的高亮样式以及数学公式的渲染效果。在对话页面按下 Ctrl+P(Mac为 Cmd+P),在目标打印机中选择“另存为PDF”。
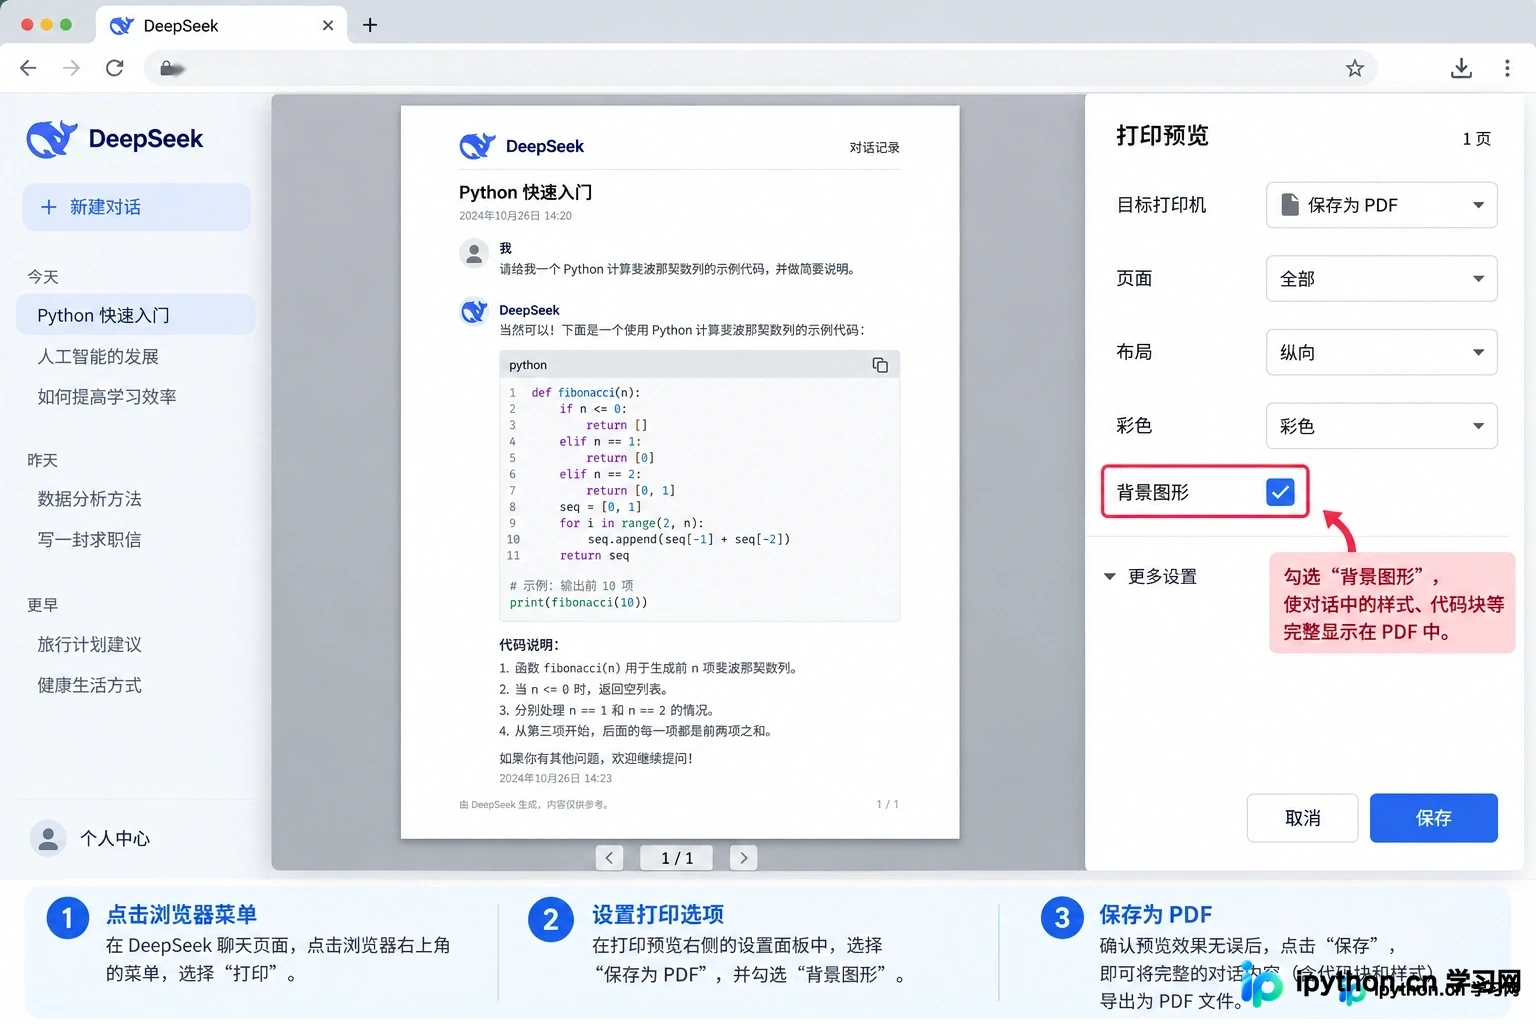
利用浏览器打印功能将对话保存为PDF,需勾选“背景图形”以保留代码高亮
关键在于调整打印设置中的“背景图形”选项。勾选此项后,DeepSeek界面中的深色模式背景、代码块的底色以及气泡的区分色将被保留,生成的PDF不仅可读,而且具备视觉上的可追溯性。如果不勾选,你得到的将是一份黑白文字稿,丢失了代码与正文的视觉界限,后期整理成本极高。
若你需要的是可编辑的文本而非固定版式的PDF,复制粘贴仍是主流选择。但直接全选复制往往会混入侧边栏导航、输入框等无关元素。更高效的操作是:鼠标双击选中某一条回复,通常浏览器会智能识别段落边界;或者使用浏览器的“检查”元素功能,定位到包含对话内容的特定 div 容器,仅复制该部分HTML或文本。这种方法虽然繁琐,但对于提取特定代码段或长文本用于二次编辑,其纯净度远高于整页截图。
隐形开关:隐私设置如何重塑对话体验
比起数据导出,隐私设置是更直接影响日常使用体验的“隐形开关”。在DeepSeek网页版的设置菜单中,关于数据留存的选项往往被折叠在不起眼的角落,但它们决定了你的对话是被用于模型优化,还是仅仅作为一次性的查询。
大多数AI平台默认开启“使用对话历史改进模型”或类似选项。这意味着你的提问和模型的回复,在经过脱敏处理后,可能成为训练数据的一部分。对于处理通用知识、闲聊或非敏感创意工作的用户,这无伤大雅,甚至有助于模型变得更聪明。但对于涉及公司代码、个人隐私或未公开商业逻辑的场景,关闭数据共享选项是必须执行的安全动作。
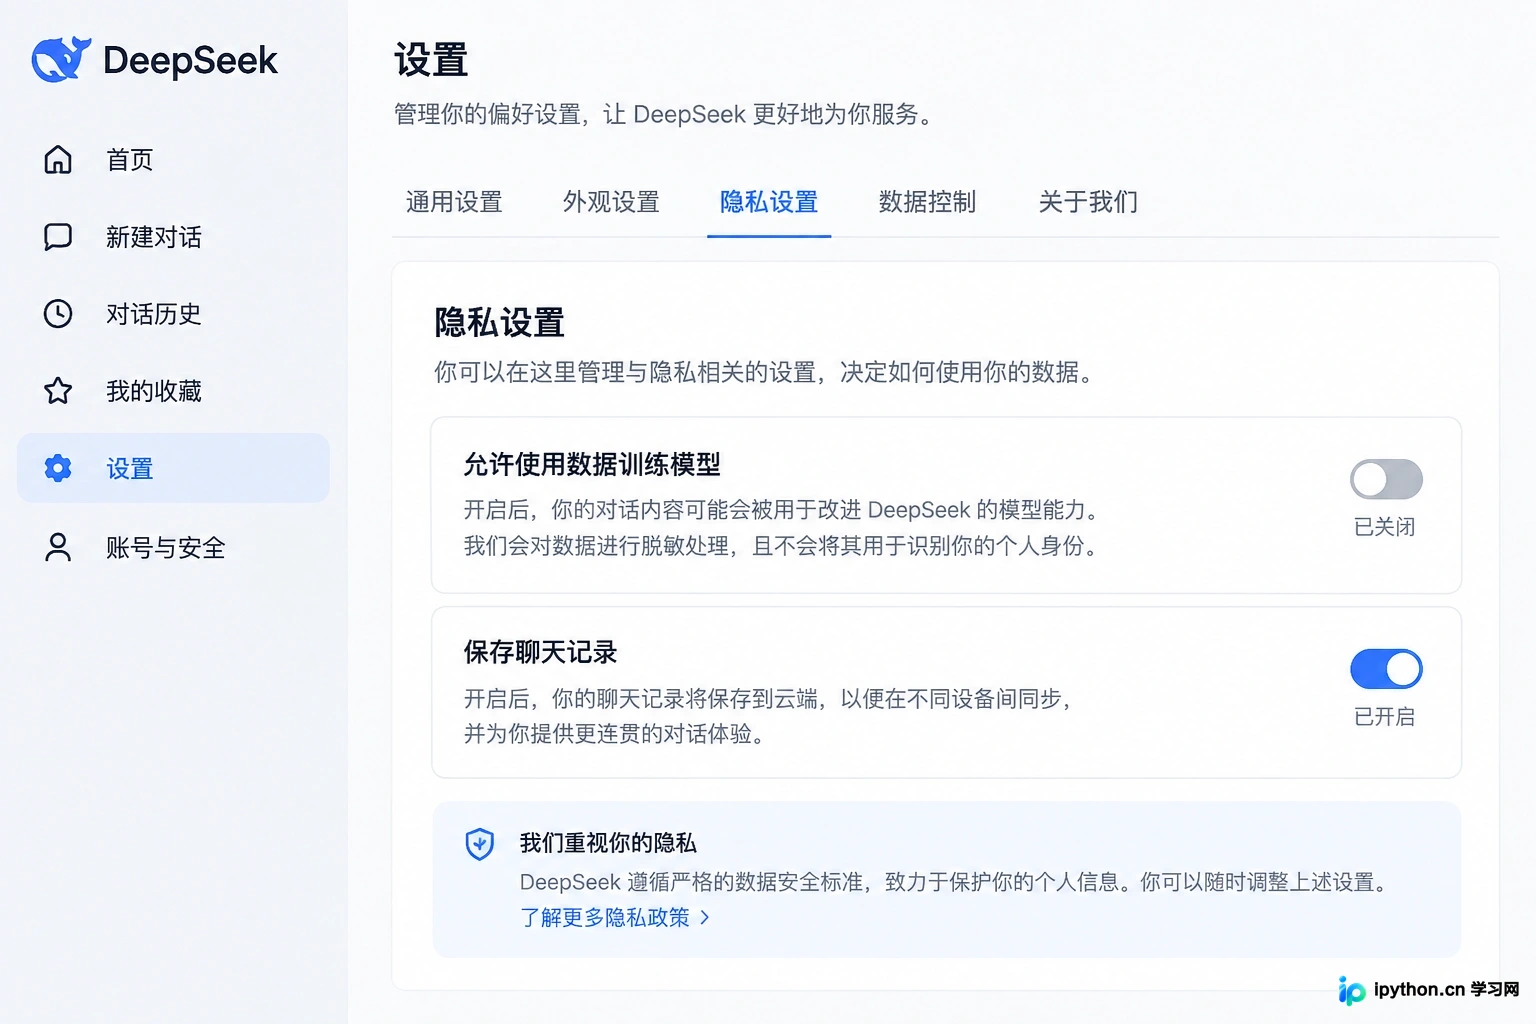
隐私设置界面,展示数据训练授权与历史记录保存的开关选项
在DeepSeek的设置界面中,寻找“数据控制”或“隐私”相关标签。通常会有两个核心选项:一是“保存聊天历史”,二是“允许使用数据训练”。需要注意的是,这两者有时是联动的。部分平台规定,若选择完全不保存历史记录(即开启“无痕模式”或临时聊天),则数据必然不会被用于训练;反之,若希望保留历史以便回溯,则需仔细甄别是否同意将其用于模型迭代。
关闭训练授权并不会显著降低模型的响应速度或智力水平,它改变的是数据流向而非计算逻辑。因此,除非你极度依赖云端多设备同步且不在意数据贡献,否则建议在处理敏感任务前,手动检查并关闭相关授权。这是一种低成本、高收益的风险隔离手段。
侧边栏管理:在混乱中建立秩序
当导出功能缺位时,侧边栏就成了唯一的数据管理界面。随着使用时间推移,左侧的对话列表会变得冗长且杂乱。DeepSeek网页版提供了基础的分组或删除功能,但缺乏标签系统或文件夹分类,这使得检索早期对话变得困难。
在这种限制下,主动的命名策略优于被动的搜索。在开启一个新话题时,养成在第一轮对话后立即重命名标题的习惯。默认的标题通常是用户的第一句提问,往往含糊不清(如“帮我写个代码”)。将其修改为包含项目名、日期和具体任务的格式(如“202410-Python数据清洗脚本-V1”),能极大提升后续在侧边栏中肉眼检索的效率。
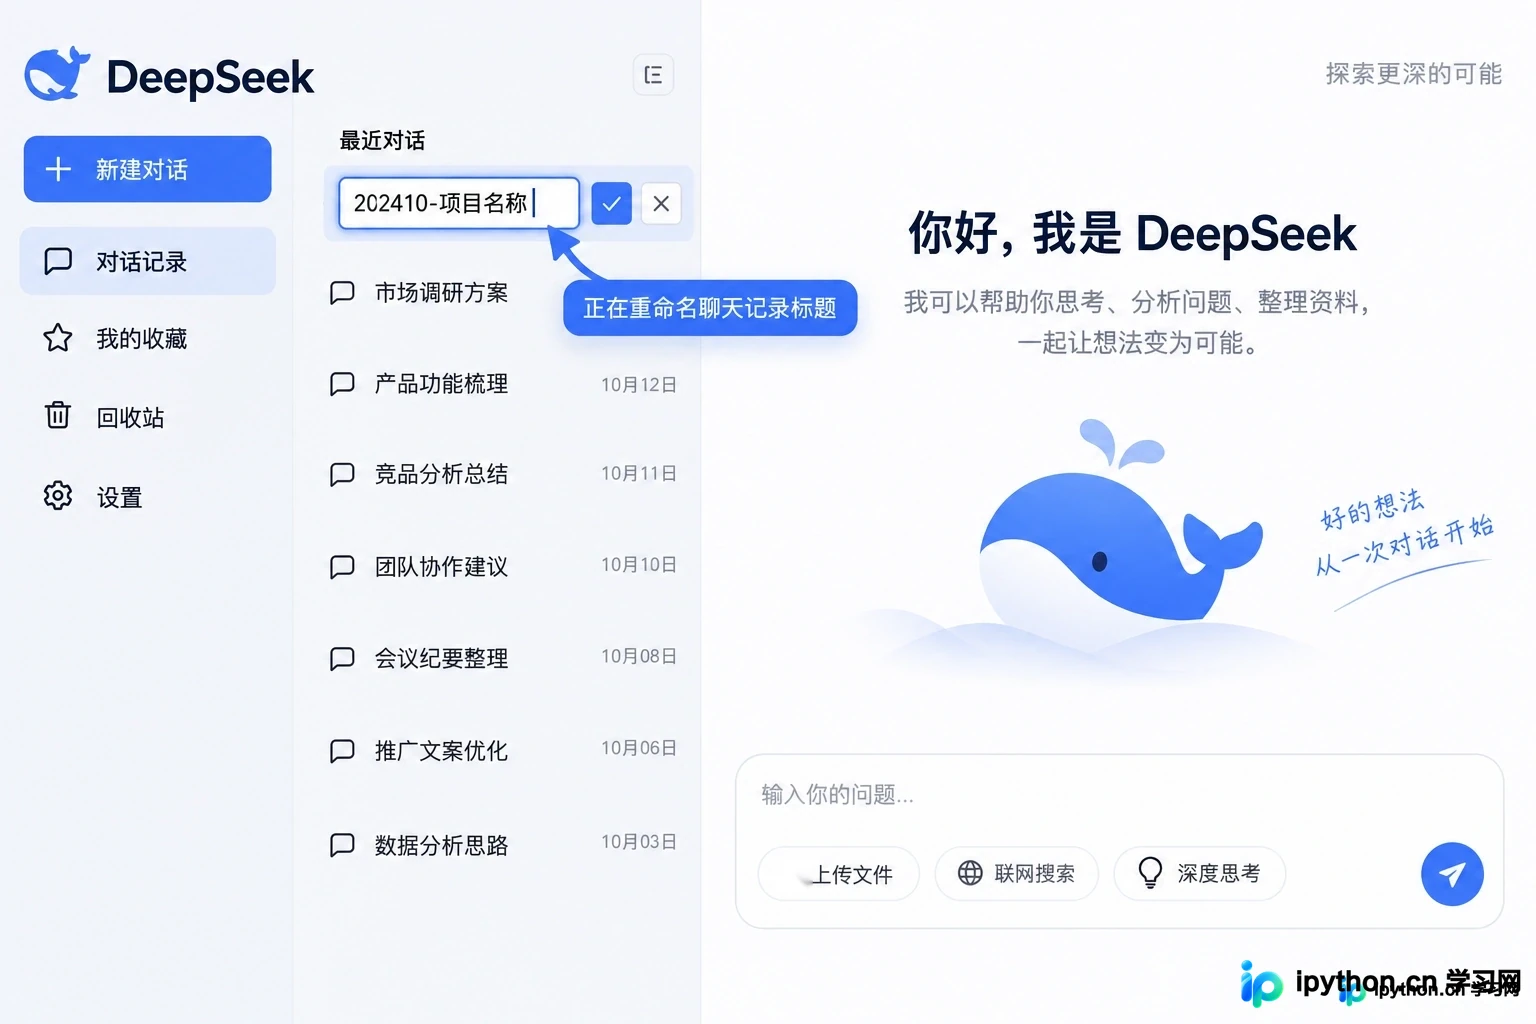
在侧边栏对对话标题进行规范化重命名,以提升检索效率
此外,定期清理无效对话不仅是释放云端存储空间的举措,更是保护隐私的防线。对于那些包含试错过程、敏感信息或已废弃方案的对话,直接使用删除功能比归档更为彻底。虽然删除操作在服务器端可能有延迟或缓存,但从用户界面层面看,这是切断数据关联最直接的方式。不要指望AI会自动帮你分类,在缺乏智能管理工具的当下,用户的自律是唯一的管理算法。
结语:在流动的数据中把握确定性
DeepSeek网页版在模型能力上的突破有目共睹,但在数据主权工具链上仍留有空白。这种取舍反映了当前AI产品在“易用性”与“可控性”之间的权衡。对于普通用户,云端同步带来的无缝体验足以弥补无法导出的不便;但对于专业用户,数据资产的安全性要求我们必须采取更主动的管理策略。
通过浏览器打印实现高质量归档,通过隐私设置切断非必要的数据外流,通过规范命名优化本地检索,这些看似琐碎的操作,构成了我们在AI时代保护数字资产的基石。在官方推出原生导出功能之前,这些变通方案不仅是权宜之计,更是一种成熟的数据素养体现。毕竟,真正重要的不是对话存在哪里,而是你是否拥有随时取用且安心掌控的权利。
通过主动管理策略,在云端便捷性与本地控制权之间取得平衡
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









