

Python实现敏感词过滤:DFA与AC自动机算法详解

发布时间:2026-10-14| 4人浏览过
本文详细介绍Python中实现敏感词过滤的两种核心算法:确定有穷自动机(DFA)与AC自动机。通过具体代码示例,展示如何构建敏感词库、处理用户输入并进行批量替换。同时包含一道BAT面试题的解决思路,探讨十亿级标题中快速过滤五万敏感词的高效方案,帮助开发者掌握高性能文本处理技巧。
简述:
敏感词过滤本质上属于文本反垃圾处理算法的一种。例如,题目要求读取敏感词文本文件 filtered_words.txt,当用户输入包含敏感词语时,系统需将其替换为星号 *。具体场景如用户输入「北京是个好城市」,系统应输出「**是个好城市」。相关实现代码如下:
#coding=utf-8
def filterwords(x):
    with open(x,'r') as f:
        text=f.read()
    print text.split('\n')
    userinput=raw_input('myinput:')
    for i in text.split('\n'):
        if i in userinput:
            replace_str='*'*len(i.decode('utf-8'))
            word=userinput.replace(i,replace_str)
            return word

print filterwords('filtered_words.txt')
另一类典型应用是反黄内容过滤:
开发敏感词语过滤程序,提示用户输入评论内容,如果用户输入的内容中包含特殊的字符:
敏感词列表 li = ["苍老师","东京热",”武藤兰”,”波多野结衣”]
则将用户输入的内容中的敏感词汇替换成***,并添加到一个列表中;如果用户输入的内容没有敏感词汇,则直接添加到上述的列表中。
content = input('请输入你的内容:')
li = ["苍老师","东京热","武藤兰","波多野结衣"]
i = 0
while i < 4:
    for li[i] in content:
        li1 = content.replace('苍老师','***')
        li2 = li1.replace('东京热','***')
        li3 = li2.replace('武藤兰','***')
        li4 = li3.replace('波多野结衣','***')
    else:
        pass
    i += 1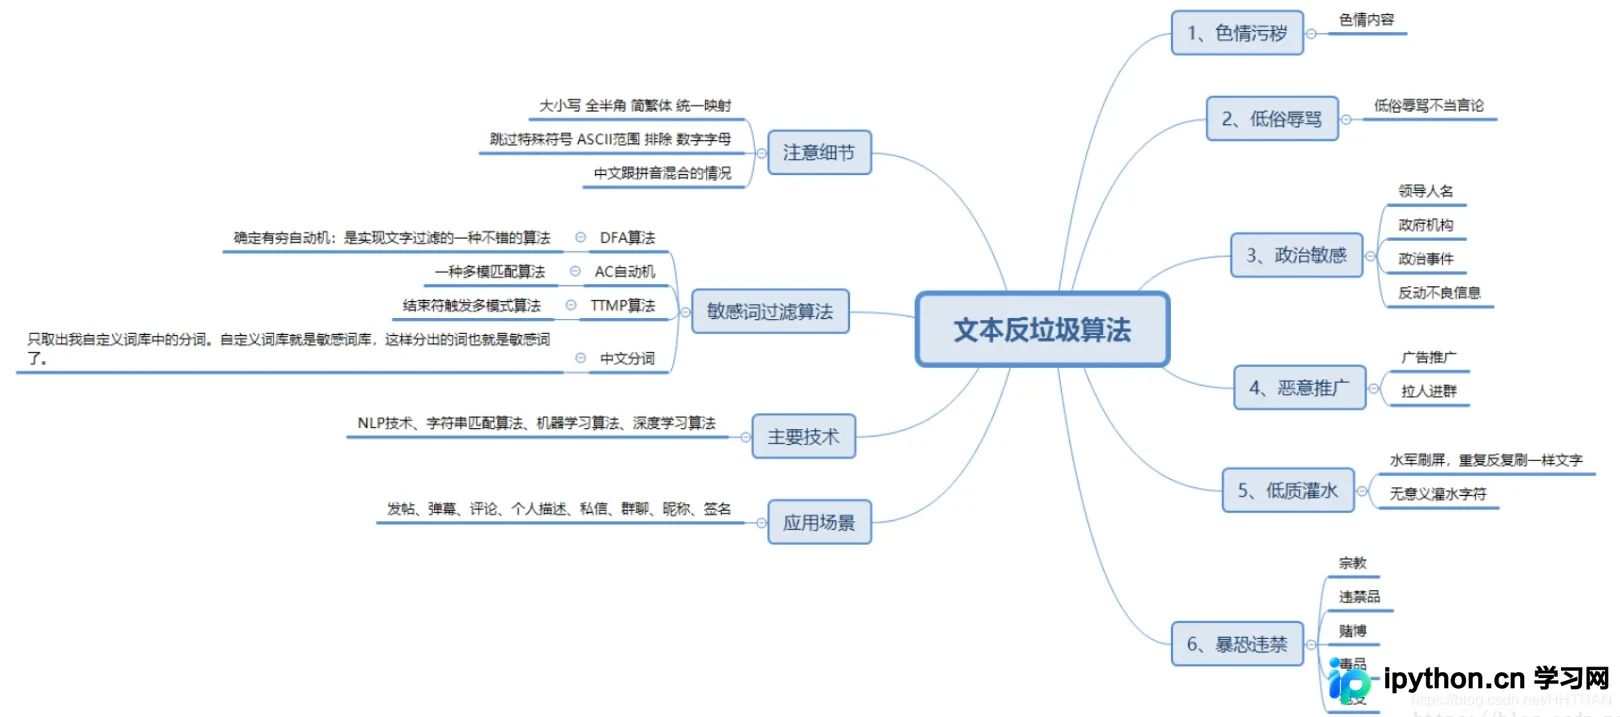
实战案例:
这是一道常见的BAT面试题:如何在10亿条标题中快速替换5万个敏感词? 假设有一个包含10亿个标题的文件,每行一个标题。另有一个文件存储5万个敏感词。编写程序过滤所有标题中的敏感词,并将结果保存至新文件。
1、DFA过滤敏感词算法
在文本过滤算法中,DFA(Deterministic Finite Automaton,确定有穷自动机)是较为高效的实现方式。 该算法的核心在于基于敏感词构建多棵敏感词树。 以下是Python实现DFA算法的代码:
# -*- coding:utf-8 -*-

import time
time1=time.time()

# DFA算法
class DFAFilter():
    def __init__(self):
        self.keyword_chains = {}
        self.delimit = '\x00'

    def add(self, keyword):
        keyword = keyword.lower()
        chars = keyword.strip()
        if not chars:
            return
        level = self.keyword_chains
        for i in range(len(chars)):
            if chars[i] in level:
                level = level[chars[i]]
            else:
                if not isinstance(level, dict):
                    break
                for j in range(i, len(chars)):
                    level[chars[j]] = {}
                    last_level, last_char = level, chars[j]
                    level = level[chars[j]]
                last_level[last_char] = {self.delimit: 0}
                break
        if i == len(chars) - 1:
            level[self.delimit] = 0

    def parse(self, path):
        with open(path,encoding='utf-8') as f:
            for keyword in f:
                self.add(str(keyword).strip())

    def filter(self, message, repl="*"):
        message = message.lower()
        ret = []
        start = 0
        while start < len(message):
            level = self.keyword_chains
            step_ins = 0
            for char in message[start:]:
                if char in level:
                    step_ins += 1
                    if self.delimit not in level[char]:
                        level = level[char]
                    else:
                        ret.append(repl * step_ins)
                        start += step_ins - 1
                        break
                else:
                    ret.append(message[start])
                    break
            else:
                ret.append(message[start])
            start += 1

        return ''.join(ret)


if __name__ == "__main__":
    gfw = DFAFilter()
    path="F:/文本反垃圾算法/sensitive_words.txt"
    gfw.parse(path)
    text="新疆骚乱苹果新品发布会雞八"
    result = gfw.filter(text)

    print(text)
    print(result)
    time2 = time.time()
    print('总共耗时:' + str(time2 - time1) + 's')
运行效果:
新疆骚乱苹果新品发布会雞八
****苹果新品发布会**
总共耗时:0.0010344982147216797s
2、AC自动机过滤敏感机算法
AC自动机常用于解决多模式匹配问题,例如给定n个单词,判断包含m个字符的文章中出现了多少个单词。 简而言之,AC自动机结合了字典树、KMP算法与失配指针的特性。
# -*- coding:utf-8 -*-

import time
time1=time.time()

# AC自动机算法
class node(object):
    def __init__(self):
        self.next = {}
        self.fail = None
        self.isWord = False
        self.word = ""

class ac_automation(object):

    def __init__(self):
        self.root = node()

    # 添加敏感词函数
    def addword(self, word):
        temp_root = self.root
        for char in word:
            if char not in temp_root.next:
                temp_root.next[char] = node()
            temp_root = temp_root.next[char]
        temp_root.isWord = True
        temp_root.word = word

    # 失败指针函数
    def make_fail(self):
        temp_que = []
        temp_que.append(self.root)
        while len(temp_que) != 0:
            temp = temp_que.pop(0)
            p = None
            for key,value in temp.next.item():
                if temp == self.root:
                    temp.next[key].fail = self.root
                else:
                    p = temp.fail
                    while p is not None:
                        if key in p.next:
                            temp.next[key].fail = p.fail
                            break
                        p = p.fail
                    if p is None:
                        temp.next[key].fail = self.root
                temp_que.append(temp.next[key])

    # 查找敏感词函数
    def search(self, content):
        p = self.root
        result = []
        currentposition = 0

        while currentposition < len(content):
            word = content[currentposition]
            while word in p.next == False and p != self.root:
                p = p.fail

            if word in p.next:
                p = p.next[word]
            else:
                p = self.root

            if p.isWord:
                result.append(p.word)
                p = self.root
            currentposition += 1
        return result

    # 加载敏感词库函数
    def parse(self, path):
        with open(path,encoding='utf-8') as f:
            for keyword in f:
                self.addword(str(keyword).strip())

    # 敏感词替换函数
    def words_replace(self, text):
        """
        :param ah: AC自动机
        :param text: 文本
        :return: 过滤敏感词之后的文本
        """
        result = list(set(self.search(text)))
        for x in result:
            m = text.replace(x, '*' * len(x))
            text = m
        return text


if __name__ == '__main__':

    ah = ac_automation()
    path='F:/文本反垃圾算法/sensitive_words.txt'
    ah.parse(path)
    text1="新疆骚乱苹果新品发布会雞八"
    text2=ah.words_replace(text1)

    print(text1)
    print(text2)

    time2 = time.time()
    print('总共耗时:' + str(time2 - time1) + 's')
运行结果:
新疆骚乱苹果新品发布会雞八
****苹果新品发布会**
总共耗时:0.0010304450988769531s
以上为Python实现敏感词过滤的详细内容,更多关于Python过滤敏感词的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









