

Python实现逐步回归:原理、代码与案例解析

发布时间:2026-10-14| 5人浏览过
本文详细介绍Python中逐步回归的实现方法。逐步回归通过F检验和t检验筛选显著变量,利用AIC准则优化模型。文章包含理论介绍、9变量消费案例及完整Python代码,展示如何自动添加和剔除变量以构建最优线性回归模型。
算法介绍
逐步回归是线性回归中用于自变量筛选的一种常用方法。其核心逻辑是逐个引入解释变量,每引入一个变量后需进行F检验,并对已选入的变量逐一进行t检验。若原有变量因新变量的引入而变得不再显著,则将其剔除,确保方程中仅保留显著变量。该过程反复迭代,直至既无显著变量可引入,也无不显著变量需剔除,从而获得最优的解释变量集合。本文选用赤池信息量(AIC)作为变量选择的评估准则,旨在使AIC值最小化,这是一种基于最大似然估计的模型选择标准。
数据情况
案例
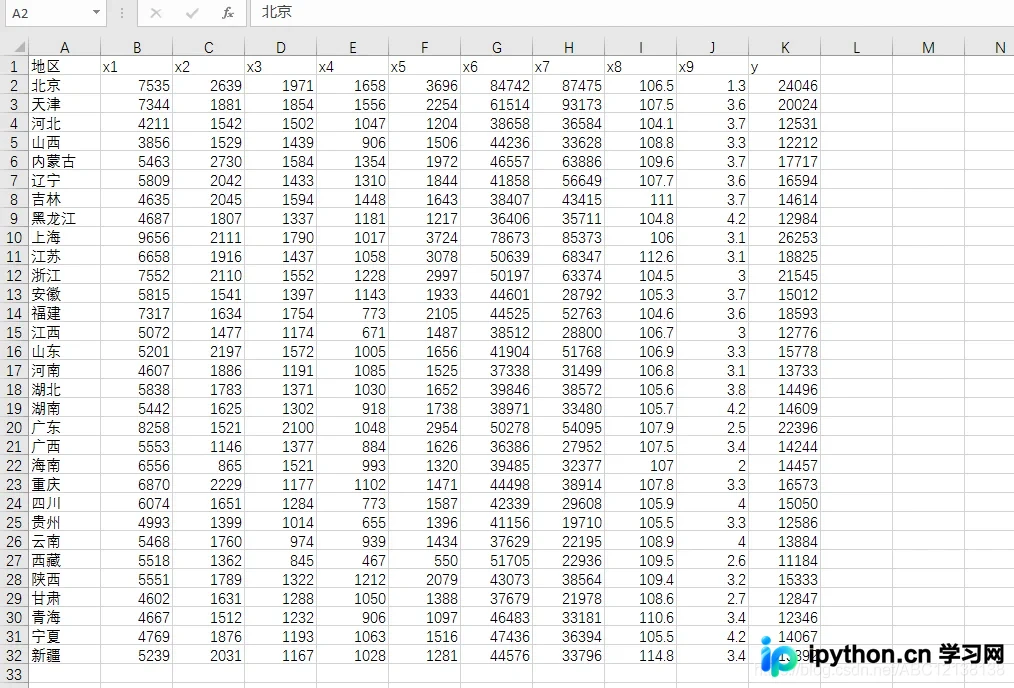
在现实场景中,影响地区居民消费的因素众多。本案例选取9个解释变量来研究城镇居民家庭全年人均消费支出y,具体变量定义如下: x1:居民食品花费 x2:居民衣着消费 x3:居民居住花费 x4:居民医疗保健花费 x5:居民文教娱乐花费 x6:地区职工平均工资 x7:地区人均GDP x8:地区消费价格指数 x9:地区失业率(%)
数据
代码
# -*- coding: UTF-8 -*-

import numpy as np
import statsmodels.api as sm
import statsmodels.formula.api as smf
from statsmodels.stats.api import anova_lm
import matplotlib.pyplot as plt
import pandas as pd
from patsy import dmatrices
import itertools as it
import random


# Load data 读取数据
df = pd.read_csv('data3.1.csv',encoding='gbk')
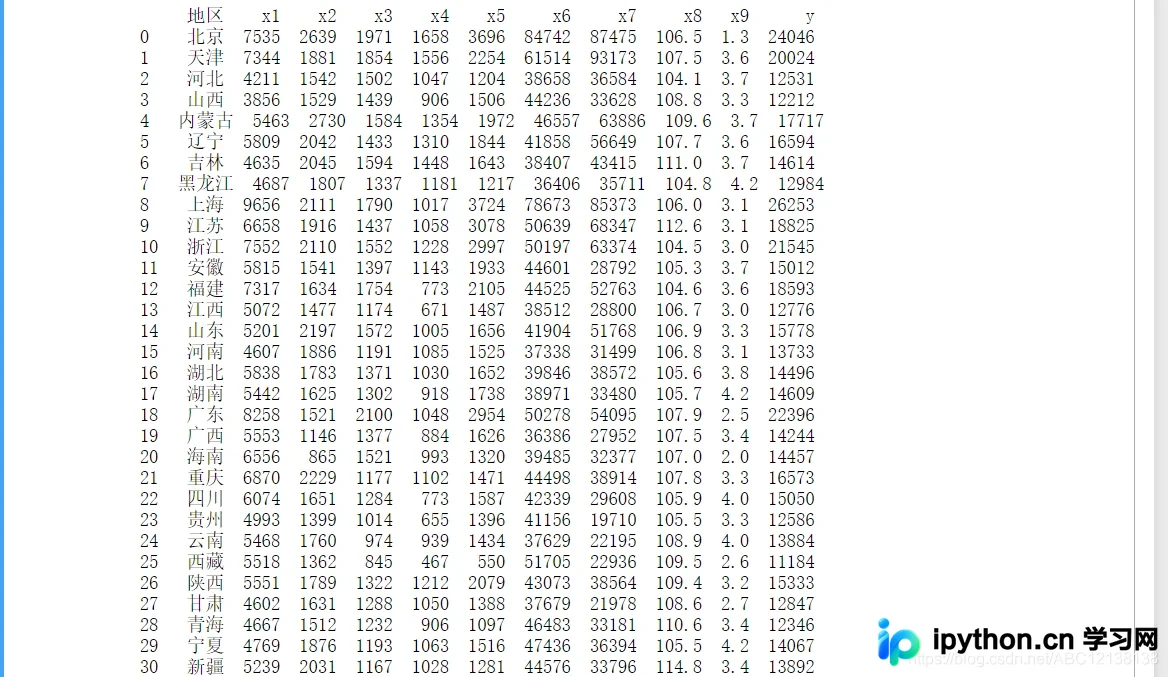
print(df)


target = 'y'
variate = set(df.columns) #获取列名
variate.remove(target) #去除无关列
variate.remove('地区')

#定义多个数组,用来分别用来添加变量,删除变量
x = []
variate_add = []
variate_del = variate.copy()
# print(variate_del)
y = random.sample(variate,3) #随机生成一个选模型,3为变量的个数
print(y)
#将随机生成的三个变量分别输入到 添加变量和删除变量的数组
for i in y:
 variate_add.append(i)
 x.append(i)
 variate_del.remove(i)

global aic #设置全局变量 这里选择AIC值作为指标
formula="{}~{}".format("y","+".join(variate_add)) #将自变量名连接起来
aic=smf.ols(formula=formula,data=df).fit().aic #获取随机函数的AIC值,与后面的进行对比
print("随机化选模型为:{}~{},对应的AIC值为:{}".format("y","+".join(variate_add), aic))
print("\n")


#添加变量
def forwark():
 score_add = []
 global best_add_score
 global best_add_c
 print("添加变量")
 for c in variate_del:
  formula = "{}~{}".format("y", "+".join(variate_add+[c]))
  score = smf.ols(formula = formula, data = df).fit().aic
  score_add.append((score, c)) #将添加的变量,以及新的AIC值一起存储在数组中

  print('自变量为{},对应的AIC值为:{}'.format("+".join(variate_add+[c]), score))

 score_add.sort(reverse=True) #对数组内的数据进行排序,选择出AIC值最小的
 best_add_score, best_add_c = score_add.pop()

 print("最小AIC值为:{}".format(best_add_score))
 print("\n")

#删除变量
def back():
 score_del = []
 global best_del_score
 global best_del_c
 print("剔除变量")
 for i in x:

  select = x.copy() #copy一个集合,避免重复修改到原集合
  select.remove(i)
  formula = "{}~{}".format("y","+".join(select))
  score = smf.ols(formula = formula, data = df).fit().aic
  print('自变量为{},对应的AIC值为:{}'.format("+".join(select), score))
  score_del.append((score, i))

 score_del.sort(reverse=True) #排序,方便将最小值输出
 best_del_score, best_del_c = score_del.pop() #将最小的AIC值以及对应剔除的变量分别赋值
 print("最小AIC值为:{}".format(best_del_score))
 print("\n")

print("剩余变量为:{}".format(variate_del))
forwark()
back()

while variate:

#  forwark()
#  back()
 if(aic < best_add_score < best_del_score or aic < best_del_score < best_add_score):
  print("当前回归方程为最优回归方程,为{}~{},AIC值为:{}".format("y","+".join(variate_add), aic))
  break
 elif(best_add_score < best_del_score < aic or best_add_score < aic < best_del_score):
  print("目前最小的aic值为{}".format(best_add_score))
  print('选择自变量:{}'.format("+".join(variate_add + [best_add_c])))
  print('\n')
  variate_del.remove(best_add_c)
  variate_add.append(best_add_c)
  print("剩余变量为:{}".format(variate_del))
  aic = best_add_score
  forwark()
 else:
  print('当前最小AIC值为:{}'.format(best_del_score))
  print('需要剔除的变量为:{}'.format(best_del_c))
  aic = best_del_score #将AIC值较小的选模型AIC值赋给aic再接着下一轮的对比
  x.remove(best_del_c) #在原集合上剔除选模型所对应剔除的变量
  back()
结果
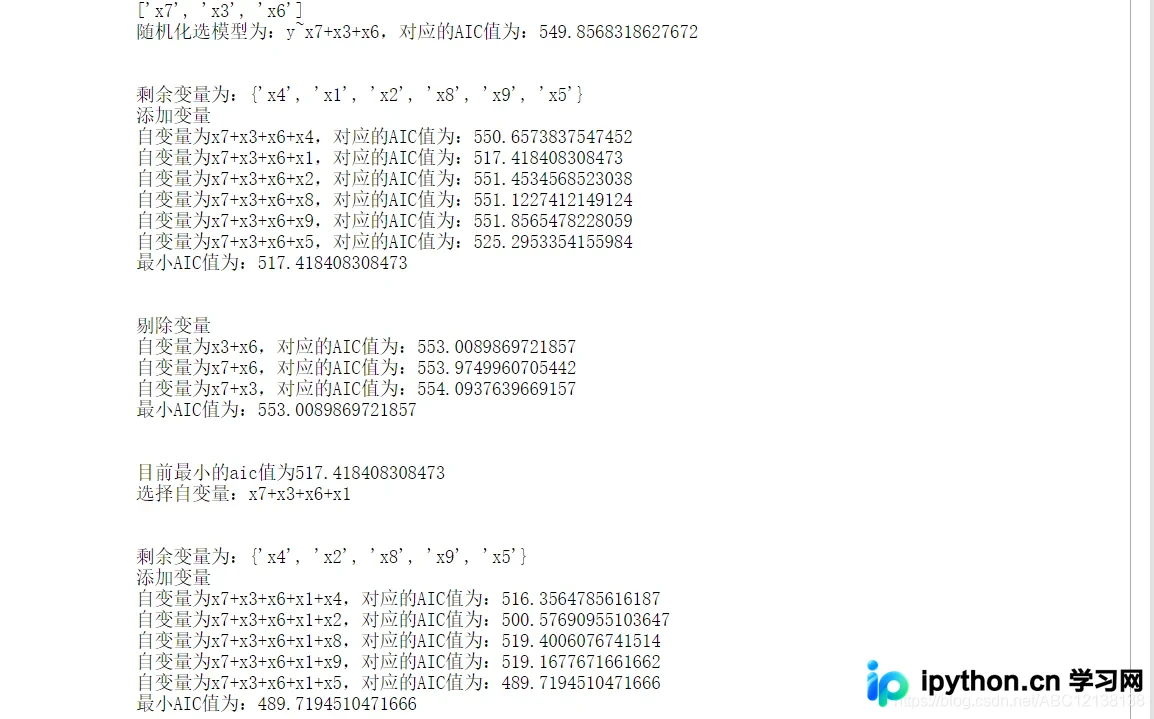
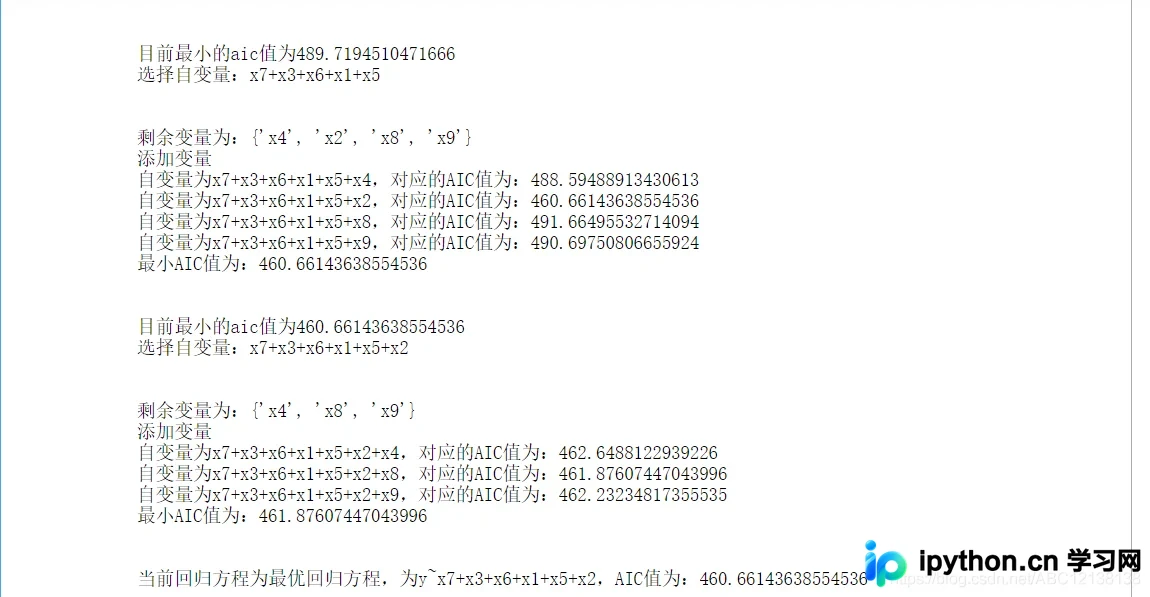
以上即为使用Python进行逐步回归的完整流程。如需获取更多关于Python逐步回归的技术资料,建议查阅本站其他相关文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









