

Python调用百度API实现淘宝评论观点抽取与关键词提取

本文介绍如何使用Python调用百度AI平台自然语言处理接口,对淘宝购物评论进行观点抽取。通过获取Access Token,指定type为12(购物类),提取积极、中性及消极关键词,并分析模型在特定语境下的表现与局限性。
借助百度AI平台自然语言处理技术中的评论观点抽取功能,对淘宝商品评论数据进行分析并提取关键词,有助于买家快速掌握商品核心特点。具体实现步骤如下:
1、创建相关新应用
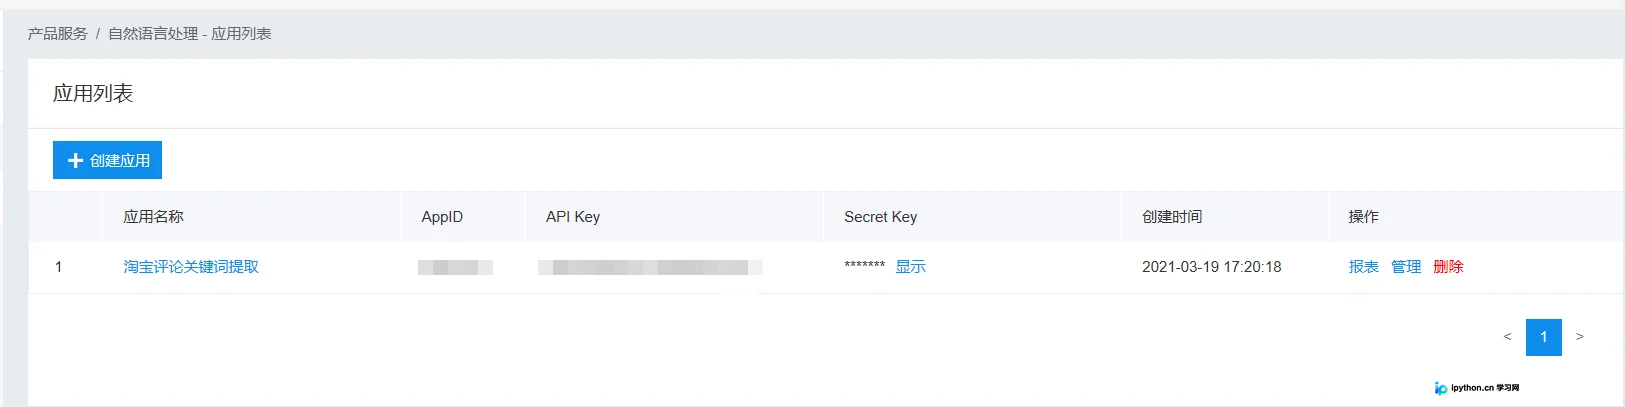
首先,登录百度AI平台,创建一个自然语言处理相关的应用(可领取免费额度),获取AppID、API Key和Secret Key,如下图所示:
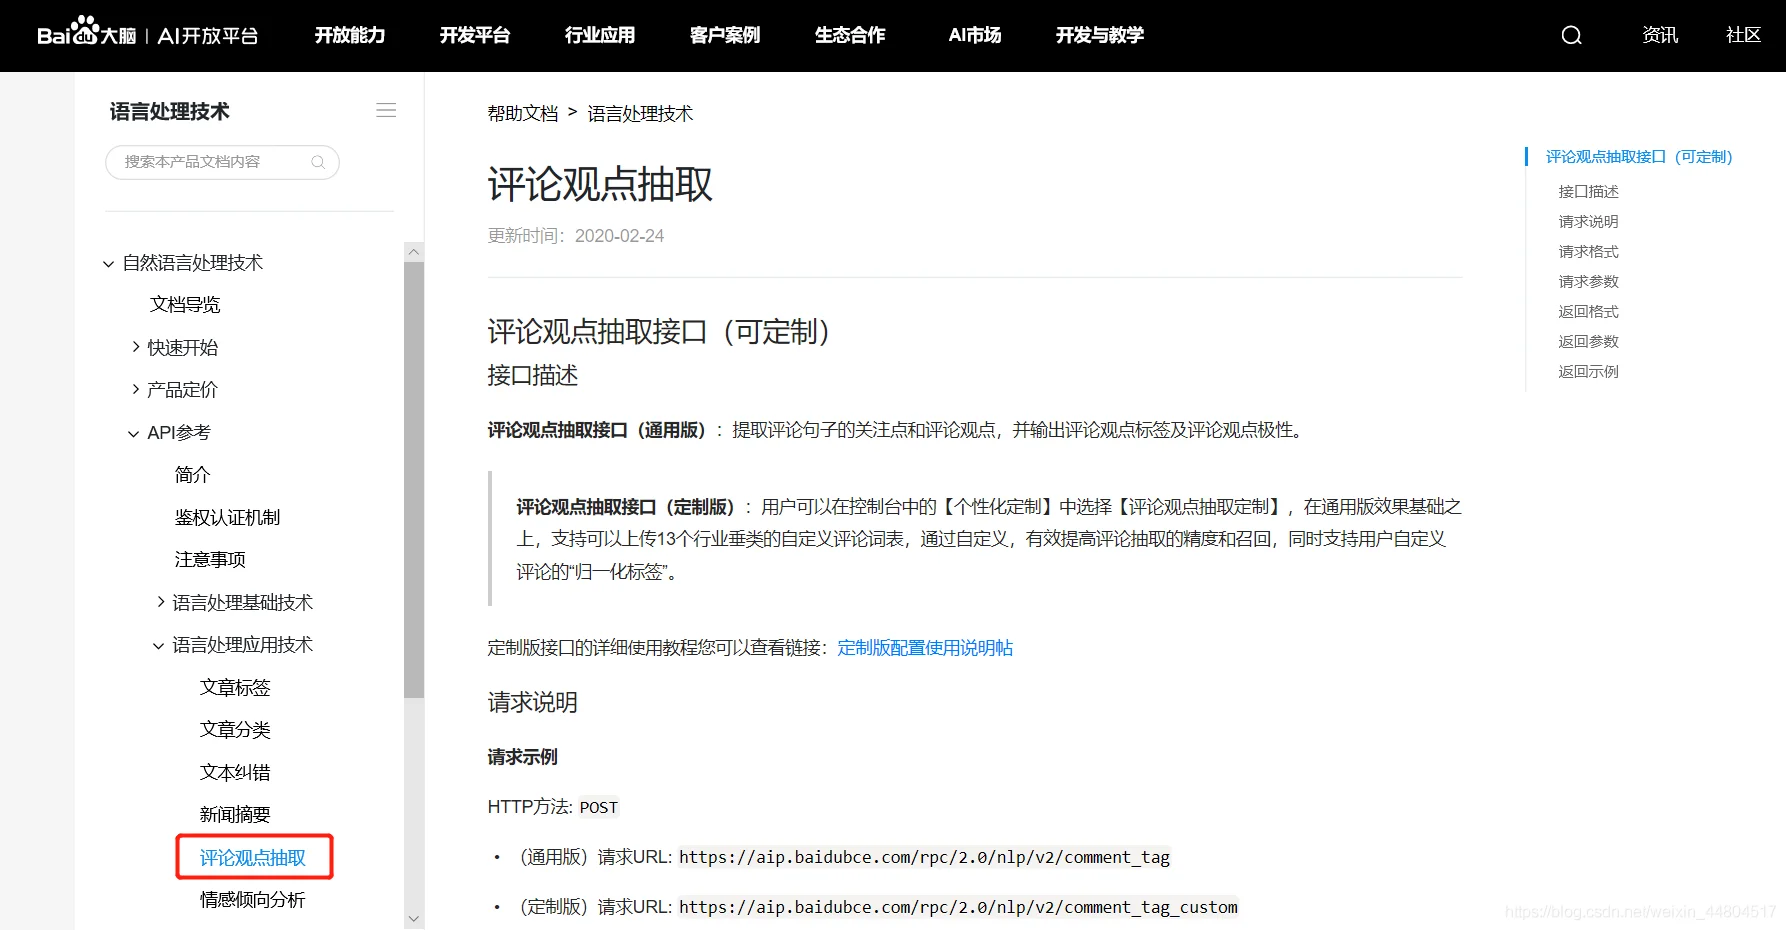
随后下载Python SDK,并参考API使用手册及自然语言处理技术中的观点抽取案例进行开发:
2、获取Access Token
调用百度API前需先获取Access Token,该过程需使用上一步获得的API Key和Secret Key。根据百度官方说明,建议使用POST方式请求指定URL来获取access_token,并可添加Header,该方式支持UTF-8编码。具体实现代码如下:
import json
import time
import requests
from urllib.request import urlopen

#定义获取token函数
def get_token():
  req = Request(Token_url)
  req.add_header('Content-Type', 'application/json; charset=UTF-8')
  try:
    f = urlopen(req,timeout=5)
    result_str = f.read().decode('utf-8')
  except URLError as err:
    print(err)
  result = json.loads(result_str)
  #返回Access Token字符串
  return result['access_token']
3、分析评论并进行观点抽取
获取Access Token后,即可调用百度API对评论进行分析并抽取关键词。根据使用说明,调用API时需传入text和type两个参数,其中text为待分析的文本内容,type包含13个类别,具体取值说明如下:
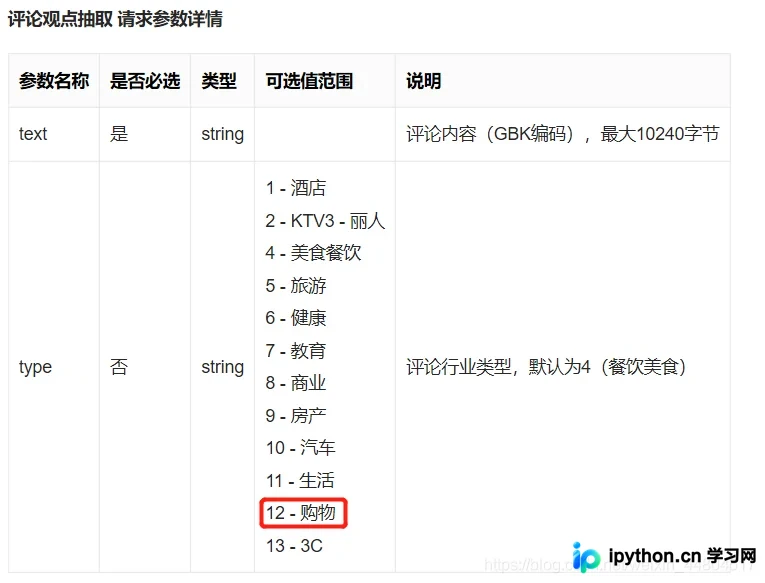
由于本文针对的是淘宝购物评论数据,因此将type参数设置为12。此外,返回格式需指定为UTF-8编码。在调用返回的参数中,主要使用prop、adj和sentiment三个字段,具体解释如下:
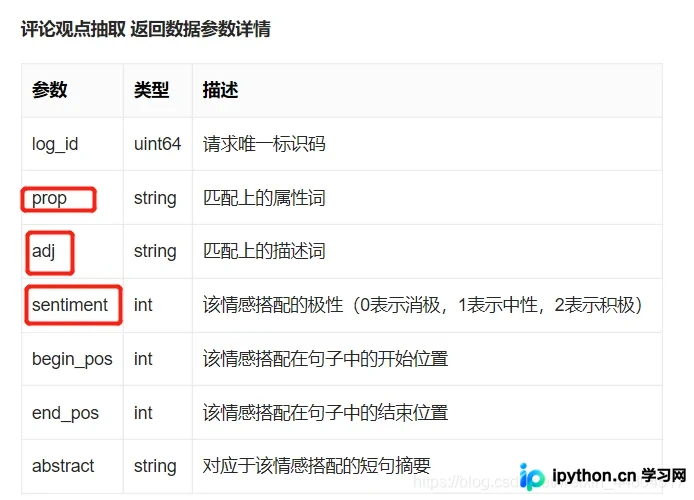
具体实现代码如下:
def analysis_comment(host,comment):
  #定义分析类别(购物)
  data = json.dumps(
    {
      "text":comment,
      "type":12
    })

  request = Request(url=host,data=data.encode('utf-8'))
  request.add_header('Content-Type', 'application/json; charset=UTF-8')
  response = urlopen(request)
  content = response.read().decode('utf-8')
  rdata = json.loads(content)

  print("--------------------------------------------------------------")
  print("评论:")
  print("  " + comment)
  print("\n评论关键字:")
  #把积极、中性、消极关键词分类出来并打印
  for item in rdata['items']:
    if item['sentiment'] == 2:
      print(u"  积极的评论关键词:" + item['prop'] + item['adj'])
    if item['sentiment'] == 1:
      print(u"  中性的评论关键词:" + item['prop'] + item['adj'])
    if item['sentiment'] == 0:
      print(u"  消极的评论关键词:" + item['prop'] + item['adj'])
4、运行结果
定义上述函数后,运行代码并调用该函数:
if __name__ == '__main__':
  #定义访问url(API Key和Secret Key换成自己的)
  Comment_url = "https://aip.baidubce.com/rpc/2.0/nlp/v2/comment_tag"
  Token_url = "https://aip.baidubce.com/oauth/2.0/token?grant_type=client_credentials&client_id=your_API_Key&client_secret=your_Secret_Key"

  A_t = get_token()
  host = Comment_url + "?charset=UTF-8&access_token="+A_t

  comment1 = {"text":"版型不错,颜色很好看,面料非常舒服而且厚度适中"}
  comment2 = {"text":"上身效果一般,做工也一般,会有点起球,没有想象中好"}
  comment3 = {"text":"设计做工一点都不好,袖子特别长,衣服比例设计非常差,性价比不高"}
  comment1 = comment1["text"]
  comment2 = comment2["text"]
  comment3 = comment3["text"]

  analysis_comment(host,comment1)
  analysis_comment(host,comment2)
  analysis_comment(host,comment3)
运行结果如下:
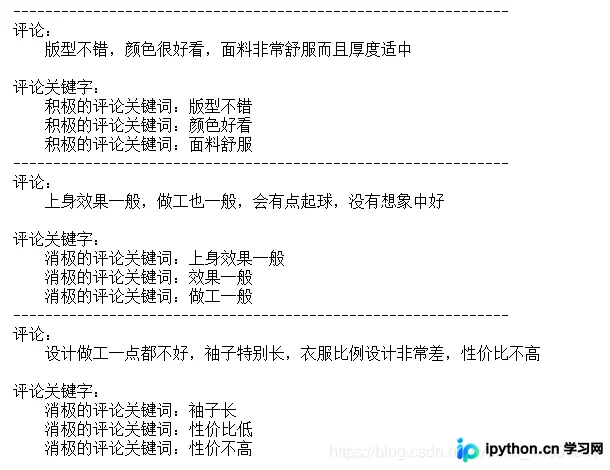
从结果可以看出,在第二句评论中,“一般”一词本应被定义为中性,但模型将其判定为消极。这表明该模型在特定语境下仍存在一定瑕疵,这也是后续需要改进的方向。
以上为Python利用百度API进行淘宝评论关键词提取的详细内容,更多关于Python淘宝评论关键词提取的资料,请关注本站其他相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









