

Python3统计单词字母频率:从基础实现到优化思考

本文介绍使用Python3统计大量单词中各字母出现次数和频率的方法。通过逐行读取文件、忽略音标并统计大小写字母,利用列表存储结果。文章展示了格式化输出技巧,并针对代码可读性、数据结构选择(如字典)及小数格式化等问题提出改进建议,适合Python初学者参考。
Python3统计单词字母频率基础实现
首先以只读模式打开单词文件,利用列表推导式初始化两个列表:sta用于记录各字母出现的次数,freq用于记录各字母出现的频率。
f = open('5500词.txt','r',encoding='utf-8')
sta = [0 for i in range(26)]
freq = [0 for i in range(26)]
单词文件格式示例如下: a [ei] art.一(个);每一(个);(同类事物中)任一个 abandon [ə'bændən] vt.离弃,丢弃;遗弃,抛弃;放弃 abdomen [æb'dəumen] n.腹,下腹(胸部到腿部的部分) abatement [ə'beitmənt] n.减(免)税,打折扣,冲销 abide [ə'baid] vi.(abode,abided)(by)遵守;坚持;vt.忍受,容忍
由于每个单词独占一行,程序选择按行读取文件内容。
文件读取与字母统计逻辑
for i in range(5500):
  buf = f.readline()
接着依次统计每个字符串中的字母个数,注意大写字母也需要被统计(后续字母统计逻辑省略)。
for j in buf:
    if j == 'a' or j == 'A':
      sta[0] = sta[0] + 1
    elif j == 'b' or j == 'B':
      sta[1] = sta[1] + 1
考虑到每个单词后跟随有音标,当遇到中括号“[”时停止计数。
if j == '[':
      break
随后每五个字母为一行,依次输出各个单词中各字母出现的次数。将print函数中的end参数由默认的换行符改为几个空格,使输出更加格式化。字母通过ASCII码进行输出。
结果格式化输出
print('5498个词汇中,各字母出现的次数分别为:\n')
asc = 97
for i in range(26):
  if i < 25:
    print("%c" % asc,':',sta[i],end='  ')
    if (i + 1) % 5 == 0:
      print('\n')
  else:
    print("%c" % asc,':',sta[i])
  asc = asc + 1
利用一个for循环遍历计算出所有字母数量的总和。
sum = 0
for i in sta:
  sum = sum + i
利用一个for循环计算各字母出现的频率。注意到Python中计算出的频率会自动保留17位小数,为了方便查看,使用round()函数保留四位小数。值得注意的是,使用round()函数会自动去掉数字末尾的0。
频率计算与精度处理
for i in range(26):
  freq[i] = round(sta[i] / sum,4)
最后以每五个字母为一行,依次输出各个单词中各字母出现的频率,将print函数中的end参数由默认换行改成几个空格,使输出更格式化。字母利用ASCII码输出。
print('各字母出现的频率分别为:\n')
for i in range(26):
  if i < 25:
    print("%c" % asc,':',freq[i],end='  ')
    if (i + 1) % 5 == 0:
      print('\n')
  else:
    print("%c" % asc,':',freq[i])
  asc = asc + 1
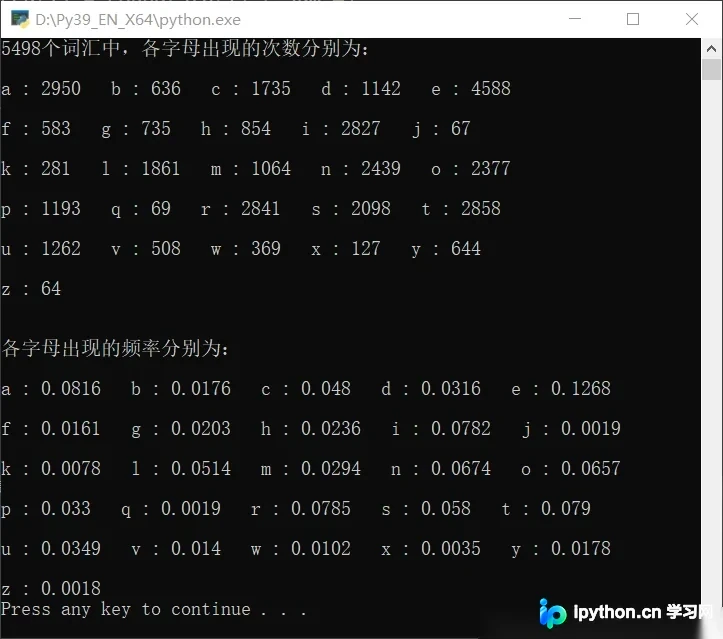
最后输出的结果如下图所示:
代码优化思考与改进建议
上概率论的课时,偶然看见有人拿着词典去数字母的数量,便想能否写一个自动统计的程序,于是随手编写。代码功底较差,因此写得较为杂乱(居然有25个elif),仅供娱乐参考。
总的来说,认为有以下几个可以改进的地方: ①读取单词的方法可以改进,这种一行一行读取的方式对格式要求很高,较难找到合适的数据源 ②用字典来存储频数和频率是否会更好?后续输出时避免使用ASCII码,但字典推导式记忆不清晰 ③判断计数的这些if和elif能否抽象出一个方法?以增加代码复用性 ④round()函数会自动去掉小数后面的0,是否有方法使0被保留下来?这样输出的格式会更好看
代码的优点估计只有一点: ①Python初学者就能看懂
到此这篇关于利用Python3实现统计大量单词中各字母出现的次数和频率的方法的文章就介绍到这了,更多相关Python3字母出现次数和频率内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









