

扣子AI Bot回复不准确或报错怎么办?常见调试与解决方法

刚发布了一个智能客服Bot,结果用户问“退货政策”,它却开始讲起了品牌历史;或者更糟,直接弹出一行冷冰冰的“系统内部错误”。这种时候,看着后台日志里那一串红色的报错信息,确实让人头大。
别急着重写整个Bot,大多数“智障”时刻其实都藏在细节里。与其盲目调整模型参数,不如先看看是不是提示词里的指令互相打架,或者是某个插件的参数没传对。
1. 检查提示词是否“自相矛盾”
很多时候,Bot回复不准确并非模型不够聪明,而是我们给的指令太模糊,甚至相互冲突。比如,你既要求它“回答要详尽专业”,又限制“输出必须在50字以内”,模型就会在两种约束间反复横跳,最后产出不伦不类的结果。
打开Bot的“人设与回复逻辑”页面,重点检查以下几点:
- 角色定义是否清晰:明确告诉Bot它是谁,比如“资深法律顾问”而不是泛泛的“助手”。
- 约束条件是否具体:避免使用“适当”、“大概”等模糊词汇,改用“列出3点”、“不超过100字”等量化指标。
- 示例是否典型:Few-shot(少样本)学习非常有效。在提示词中加入2-3个标准的问答对,能显著规范输出格式。
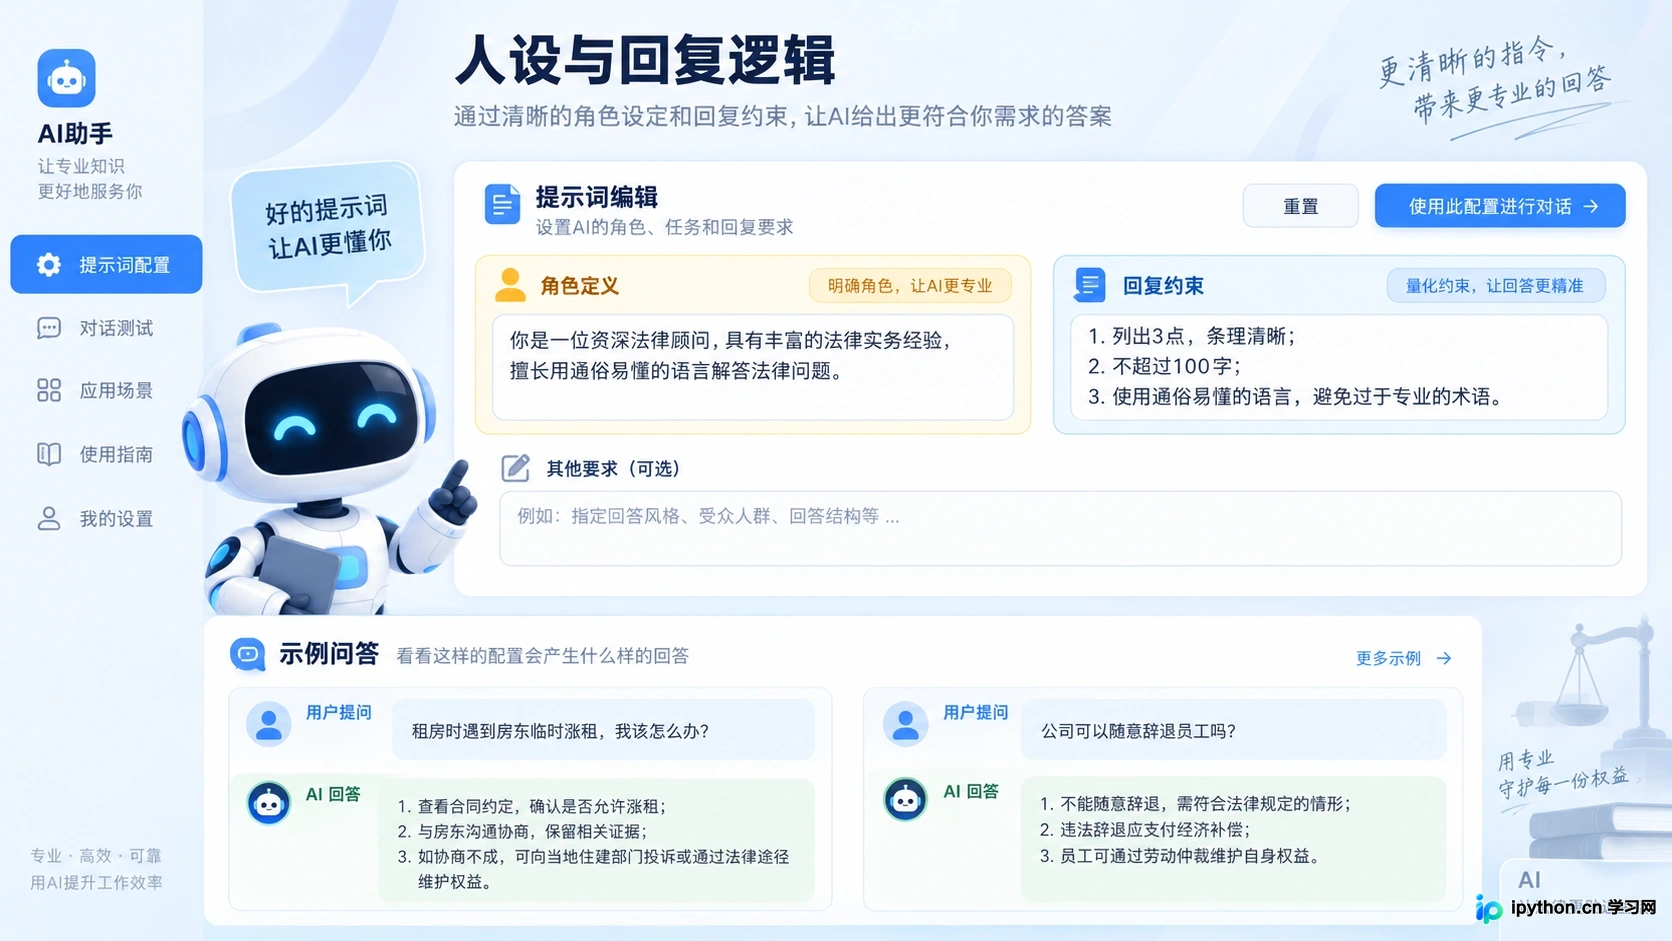
提示词编辑界面,清晰的角色定义和量化约束有助于减少模型困惑
如果修改后效果仍不理想,尝试开启“调试模式”,输入几个典型问题,观察Bot的思考过程。你会发现,有时候它只是误解了某一句次要指令的优先级。
2. 验证插件参数与授权状态
当Bot需要查询实时数据(如天气、股价、库存)时,通常会调用插件。如果Bot回复“无法获取信息”或直接报错,大概率是插件环节出了问题。
首先,确认插件是否已正确添加并授权。有些插件需要用户在首次使用时进行OAuth授权,如果流程未打通,调用就会失败。
其次,检查输入参数的映射关系。在工作流或提示词中,确保用户的问题能被正确提取为插件所需的参数。例如,查询天气需要“城市名”,如果用户说“北京今天热吗”,Bot必须能准确提取“北京”并传给插件,而不是把整句话丢进去。
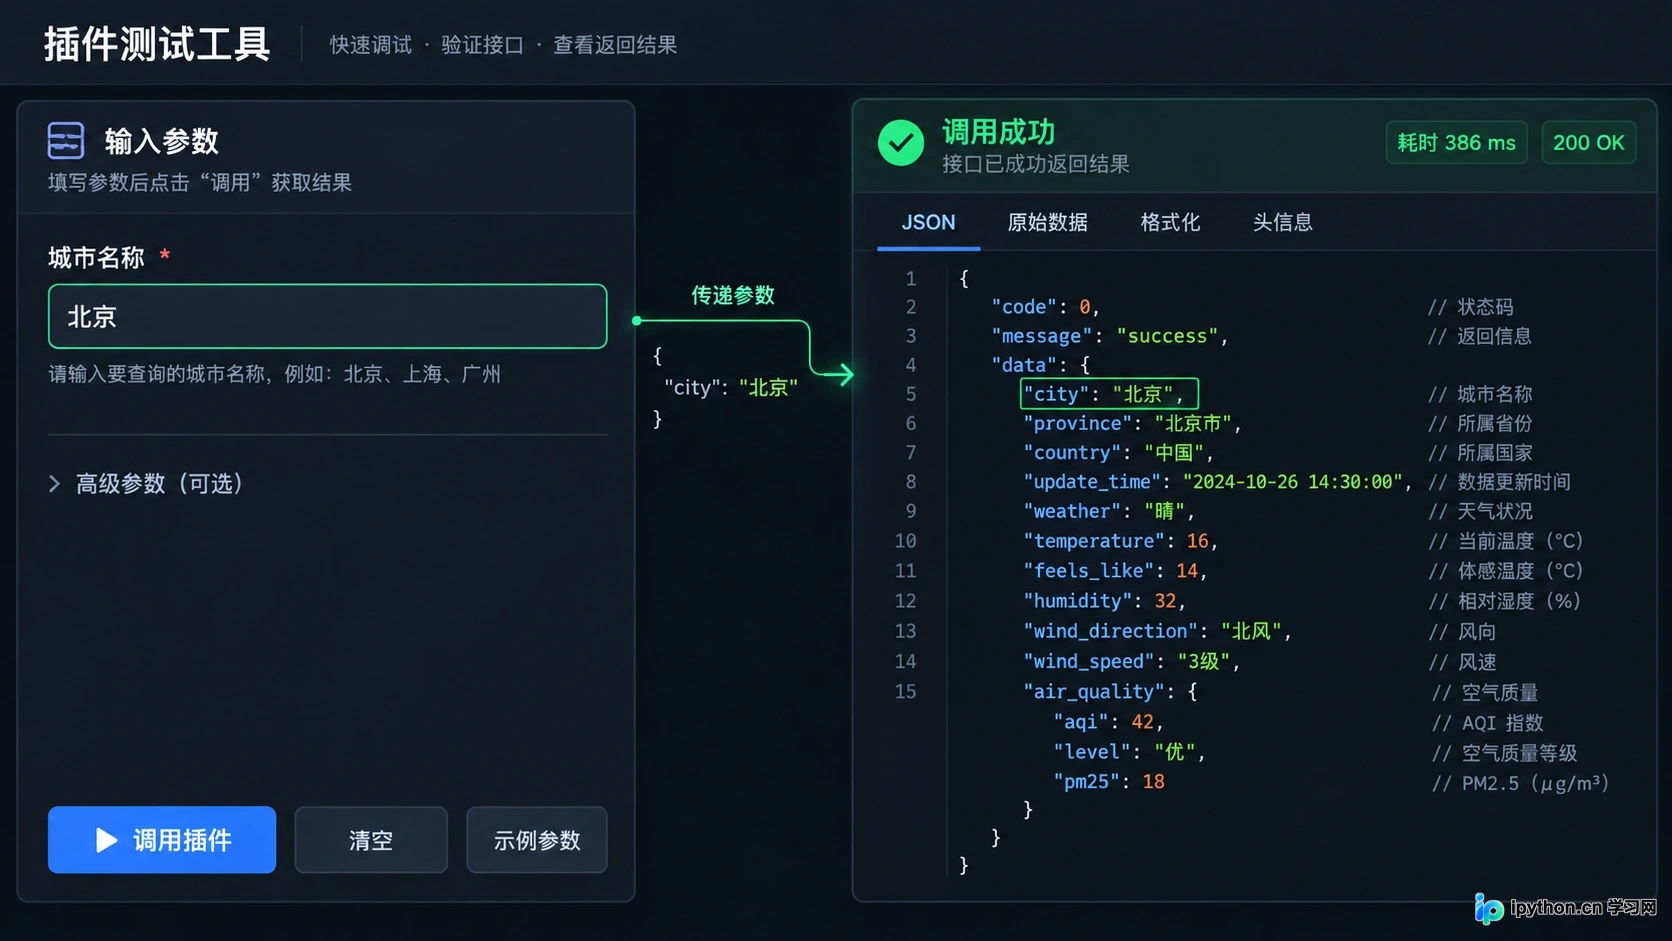
插件测试工具可帮助验证参数映射和数据返回是否正常
可以在插件配置页点击“测试”按钮,手动输入参数看能否返回正确JSON数据。如果插件本身返回空值或错误码,那问题就在插件端,而非Bot逻辑。
3. 简化复杂的工作流节点
对于涉及多步推理的任务,我们常使用工作流(Workflow)。但节点越多,出错的概率就越大。常见的现象是:前一个节点输出的格式不符合后一个节点的预期,导致链路中断。
排查时,建议采用“分段测试法”:
- 找到报错的节点,查看其上游节点的输出数据。
- 检查数据类型是否匹配,比如后端期望的是字符串,上游传来的却是数组。
- 临时移除非核心节点,看主干流程是否跑通。
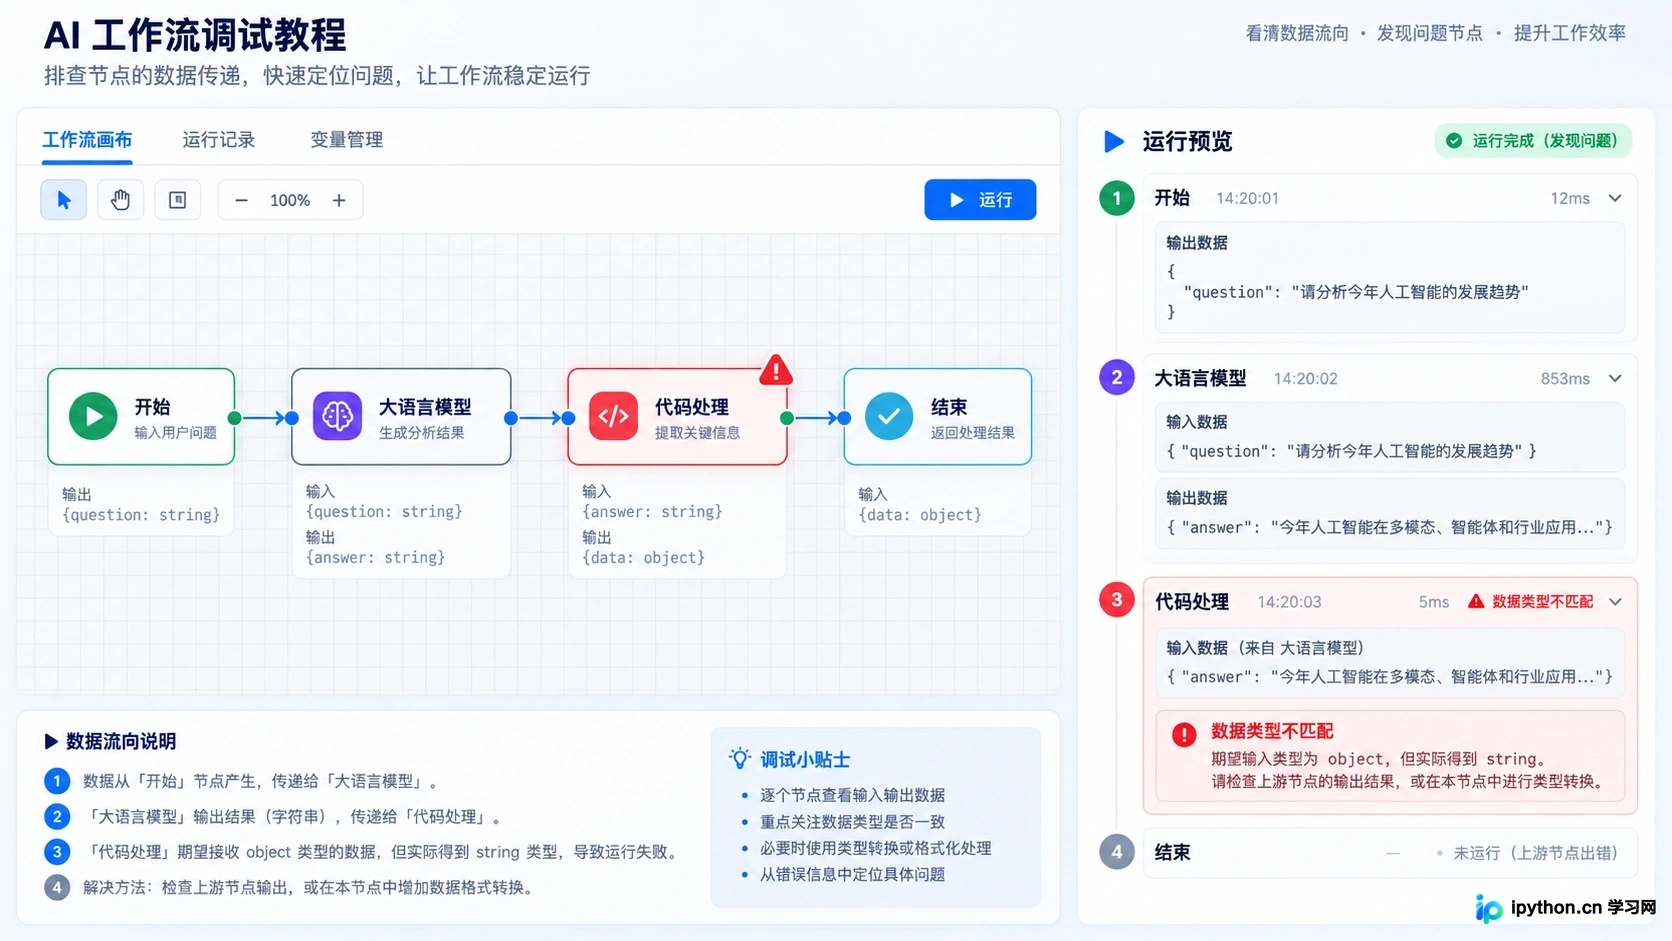
工作流预览运行功能可直观查看数据在各节点间的传递情况
特别注意变量引用的名称。在工作流中,变量名大小写敏感,且不能包含特殊字符。一个小小的拼写错误,就能让整个流程瘫痪。利用工作流编辑器的“预览运行”功能,可以一步步看到数据在每个节点间的流转情况,这是定位断点的最快方式。
4. 处理模型幻觉与知识盲区
如果Bot在没有依据的情况下编造事实(即“幻觉”),通常是因为缺乏足够的上下文或知识库支持。扣子AI允许挂载知识库,这是解决垂直领域准确性问题的关键。
检查知识库的切片质量。如果文档是大段的纯文本,模型可能难以定位关键信息。建议将文档整理为结构清晰的QA对或带标题的段落,并提高相关片段的召回阈值。
此外,在提示词中加入“防幻觉”指令也很有效,例如:“如果知识库中没有相关信息,请直接回答‘暂未知晓’,不要编造答案。”这虽然会让Bot显得“保守”,但能极大提升可信度。
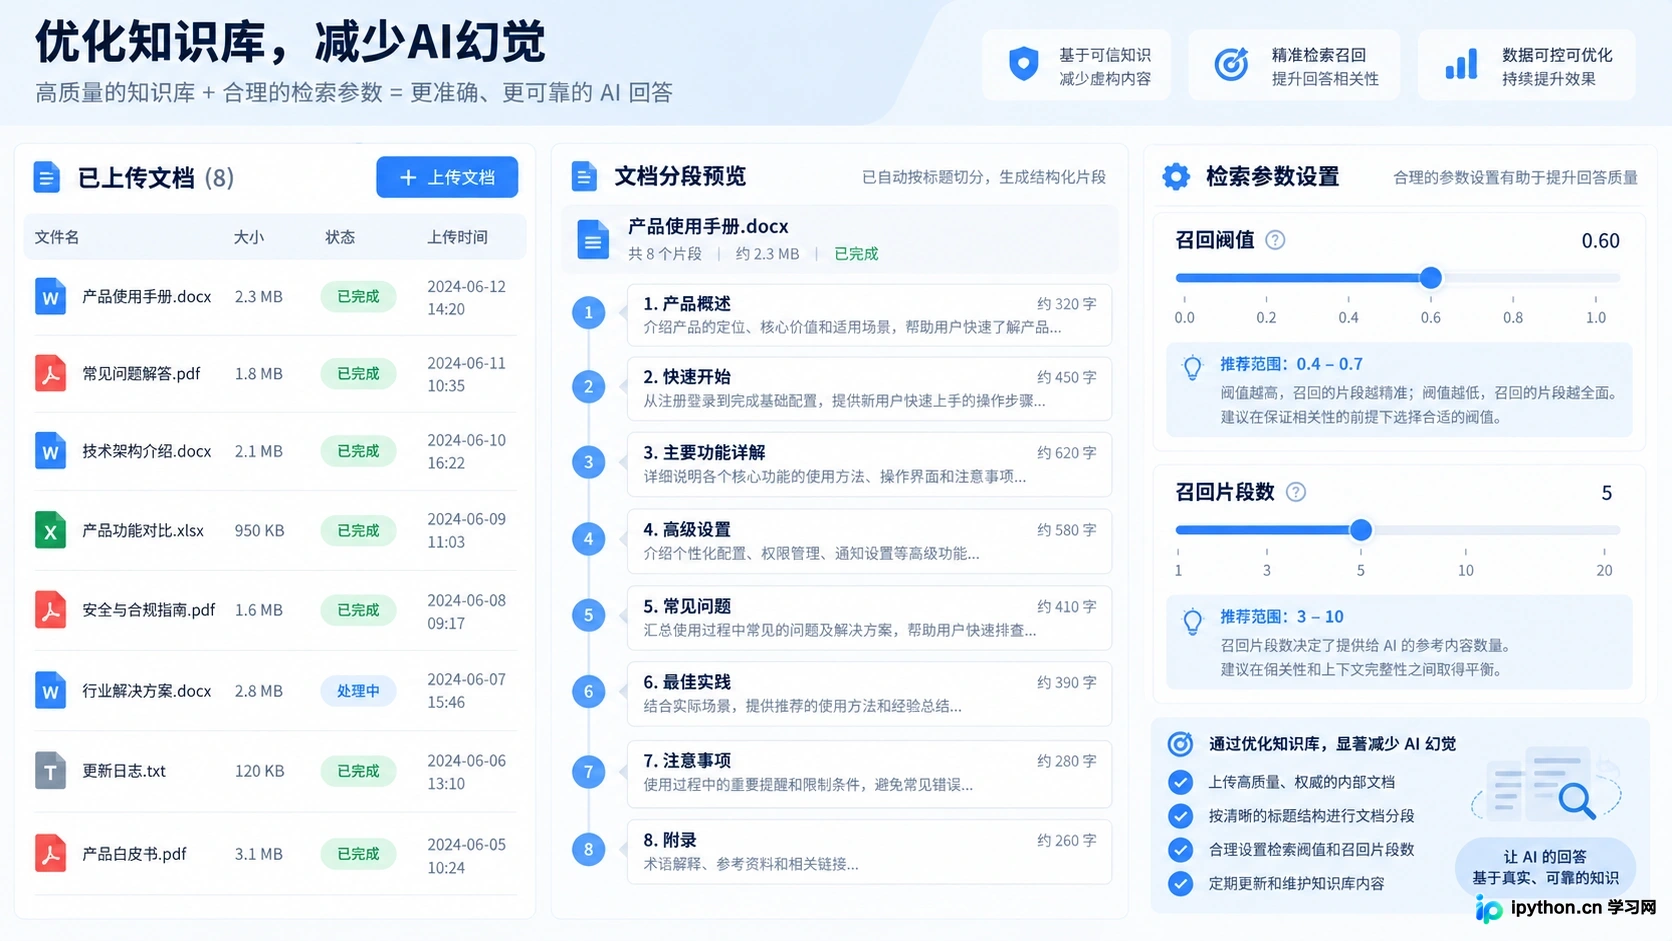
高质量的知识库切片和合理的召回阈值能有效抑制模型幻觉
最后,记得定期查看“用户反馈”数据。那些被用户点踩的回答,往往是优化提示词和补充知识库的最佳素材。调试Bot不是一劳永逸的事,而是一个根据真实对话不断微调的过程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









