

Python实现HTTP连接池:原理、线程安全与自动清理机制

本文详解Python中HTTP连接池的实现原理,基于TCP长连接复用资源。通过threading.Condition实现线程安全的获取与释放,利用上下文管理器简化使用流程,并引入定时任务与二分查找算法高效清理空闲连接,优化资源占用。
一. 连接池的原理
HTTP通信底层依赖于TCP连接。与服务器进行HTTP交互,本质上是建立TCP连接后传输HTTP协议数据包。若需频繁请求某服务器资源,可保持TCP连接持续存在,在需要时直接复用该连接,避免重复建立连接的开销。
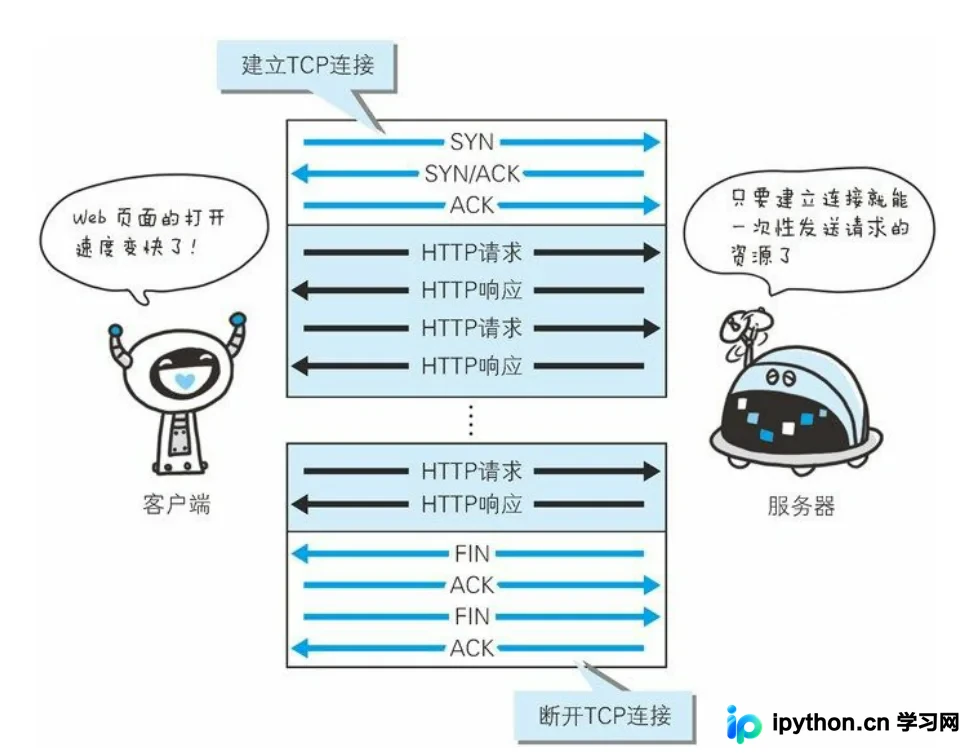
项目中常需同时维持多个连接,例如爬虫程序:部分线程请求网页资源,另一部分请求图片等资源。这些不同需求的请求均可复用同一条TCP连接,提高资源利用率。
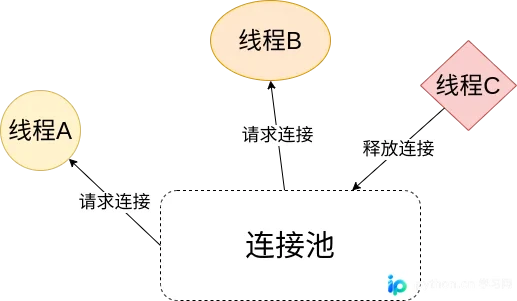
为此,引入连接池管理器统一管控连接。程序需使用时向管理器申请连接,使用完毕后归还,供其他程序复用。该管理器即连接池。
二. 实现代码
1. HTTPConnectionPool类
基于前述分析,连接池应作为容器收纳连接,并具备管理能力:
class HTTPConnectionPool:

 def __init__(self, host: str, port: int = None, max_size: int = None, idle_timeout: int = None) -> None:
  """
  :param host: pass
  :param port: pass
  :param max_size: 同时存在的最大连接数, 默认None->连接数无限,没了就创建
  :param idle_timeout: 单个连接单次最长空闲时间,超时自动关闭,默认None->不限时
  """
  self.host = host
  self.port = port
  self.max_size = max_size
  self.idle_timeout = idle_timeout
  self._lock = threading.Condition()
  self._pool = []
  # 这里的conn_num指的是总连接数,包括其它线程拿出去正在使用的连接
  self.conn_num = 0
  self.is_closed = False

 def acquire(self, blocking: bool = True, timeout: int = None) -> WrapperHTTPConnection:
  ...

 def release(self, conn: WrapperHTTPConnection) -> None:
  ...
定义HTTPConnectionPool类,使用列表存储可用连接。对外提供acquire(获取)和release(释放)方法,供外部程序调用以取得或归还连接。
2. 线程安全地管理连接
连接池内部需支持三种操作:从池中获取连接、将连接放回池、创建新连接。
def _get_connection(self) -> WrapperHTTPConnection:
 # 这个方法会把连接从_idle_conn移动到_used_conn列表中,并返回这个连接
 try:
  return self._pool.pop()
 except IndexError:
  raise EmptyPoolError


def _put_connection(self, conn: WrapperHTTPConnection) -> None:
 self._pool.append(conn)


def _create_connection(self) -> WrapperHTTPConnection:
 self.conn_num += 1
 return WrapperHTTPConnection(self, HTTPConnection(self.host, self.port))
对外主要提供申请和释放连接两个操作,本质为生产者-消费者模型。鉴于外部可能为多线程环境,使用threading.Condition保证线程安全。关于Condition的详细信息可参考相关文档。
def acquire(self, blocking: bool = True, timeout: int = None) -> WrapperHTTPConnection:
 if self.is_closed:
  raise ConnectionPoolClosed
 with self._lock:
  if self.max_size is None or not self.is_full():
   # 在还能创建新连接的情况下,如果没有空闲连接,直接创建一个就行了
   if self.is_pool_empty():
    self._put_connection(self._create_connection())
  else:
   # 不能创建新连接的情况下,如果设置了blocking=False,没连接就报错
   # 否则,就基于timeout进行阻塞,直到超时或者有可用连接为止
   if not blocking:
    if self.is_pool_empty():
     raise EmptyPoolError
   elif timeout is None:
    while self.is_pool_empty():
     self._lock.wait()
   elif timeout < 0:
    raise ValueError("'timeout' must be a non-negative number")
   else:
    end_time = time.time() + timeout
    while self.is_pool_empty():
     remaining = end_time - time.time()
     if remaining <= 0:
      raise EmptyPoolError
     self._lock.wait(remaining)
  # 走到这一步了,池子里一定有空闲连接
  return self._get_connection()


def release(self, conn: WrapperHTTPConnection) -> None:
 if self.is_closed:
  # 如果这个连接是在连接池关闭后才释放的,那就不用回连接池了,直接放生
  conn.close()
  return
 # 实际上,python列表的append操作是线程安全的,可以不加锁
 # 这里调用锁是为了通过notify方法通知其它正在wait的线程:现在有连接可用了
 with self._lock:
  if not conn.is_available:
   # 如果这个连接不可用了,就应该创建一个新连接放进去,因为可能还有其它线程在等着连接用       conn.close()       self.conn_num -= 1
   conn = self._create_connection()
  self._put_connection(conn)
  self._lock.notify()
首先分析acquire方法:该方法在获取锁后调用内部_get_connection方法获取连接,确保线程安全。若当前条件无法获取连接,则调用条件变量的wait方法,释放锁并阻塞当前线程。当其他线程作为生产者调用release释放连接时,触发notify方法,唤醒一个阻塞在wait阶段的线程(消费者)。该消费者从池中取出刚归还的连接,从而启动生产者-消费者模型。
3. 上下文管理器
程序使用连接池的典型流程为:获取连接 -> 使用连接 -> 释放连接。因此,应通过with语句管理连接,防止程序结束时遗漏释放步骤。
为此,定义WrapperHTTPConnection类封装HTTPConnection,实现上下文管理器功能。HTTPConnection的具体代码可参考《用python实现一个HTTP客户端》一文。
class WrapperHTTPConnection:

 def __init__(self, pool: 'HTTPConnectionPool', conn: HTTPConnection) -> None:
  self.pool = pool
  self.conn = conn
  self.response = None
  self.is_available = True

 def __enter__(self) -> 'WrapperHTTPConnection':
  return self

 def __exit__(self, *exit_info: Any) -> None:
  # 如果response没读完并且连接需要复用,就弃用这个连接
  if not self.response.will_close and not self.response.is_closed():
   self.close()
  self.pool.release(self)

 def request(self, *args: Any, **kwargs: Any) -> HTTPResponse:
  self.conn.request(*args, **kwargs)
  self.response = self.conn.get_response()
  return self.response

 def close(self) -> None:
  self.conn.close()
  self.is_available = False
连接池本身也需支持关闭操作,因此为其添加上下文管理器功能:
class HTTPConnectionPool:
 ...

 def close(self) -> None:
  if self.is_closed:
   return
  self.is_closed = True
  pool, self._pool = self._pool, None
  for conn in pool:
   conn.close()

 def __enter__(self) -> 'HTTPConnectionPool':
  return self

 def __exit__(self, *exit_info: Any) -> None:
  self.close()
如此,即可通过with语句优雅地管理连接池生命周期:
with HTTPConnectionPool(**kwargs) as pool:
 with pool.acquire() as conn:
  res = conn.request('GET', '/')
  ...
4. 定时清理连接
若连接池所需连接数随时间波动,可能出现高峰期创建大量连接、低谷期连接过剩且大量空闲的情况,造成资源浪费。因此,设置定时任务定期清理空闲时间过长的连接,降低连接池资源占用。
首先,为连接对象添加last_time属性。每当连接释放回连接池时,更新该属性为当前时间,从而明确每个空闲连接的闲置时长:
class WrapperHTTPConnection:
 ...

 def __init__(self, pool: 'HTTPConnectionPool', conn: HTTPConnection) -> None:
  ...
  self.last_time = None


class HTTPConnectionPool:
 ...

 def _put_connection(self, conn: WrapperHTTPConnection) -> None:
  conn.last_time = time.time()
  self._pool.append(conn)
接着,通过threading.Timer实现定时任务:
def start_clear_conn(self) -> None:
 if self.idle_timeout is None:
  # 如果空闲连接的超时时间为无限,那么就不应该清理连接
  return
 self.clear_idle_conn()
 self._clearer = threading.Timer(self.idle_timeout, self.start_clear_conn)
 self._clearer.start()


def stop_clear_conn(self) -> None:
 if self._clearer is not None:
  self._clearer.cancel()
threading.Timer仅执行一次定时任务,因此需在start_clear_conn中不断将自己设为新定时任务。这相当于新开线程执行start_clear_conn,不会导致递归过深。需注意,threading.Timer虽不阻塞当前线程,但会阻止其结束,即使设为守护线程亦无效。唯一可行方案是调用stop_clear_conn方法取消定时任务。
最后,定义clear_idle_conn方法清理闲置超时连接:
def clear_idle_conn(self) -> None:
 if self.is_closed:
  raise ConnectionPoolClosed
 # 这里开一个新线程来清理空闲连接,避免了阻塞主线程导致的定时精度出错
 threading.Thread(target=self._clear_idle_conn).start()


def _clear_idle_conn(self) -> None:
 if not self._lock.acquire(timeout=self.idle_timeout):
  # 因为是每隔self.idle_timeout秒检查一次
  # 如果过了self.idle_timeout秒还没申请到锁,下一次都开始了,本次也就不用继续了
  return
 current_time = time.time()
 if self.is_pool_empty():
  pass
 elif current_time - self._pool[-1].last_time >= self.idle_timeout:
  # 这里处理下面的二分法没法处理的边界情况,即所有连接都闲置超时的情况
  self.conn_num -= len(self._pool)
  self._pool.clear()
 else:
  # 通过二分法找出从左往右第一个不超时的连接的指针
  left, right = 0, len(self._pool) - 1
  while left < right:
   mid = (left + right) // 2
   if current_time - self._pool[mid].last_time >= self.idle_timeout:
    left = mid + 1
   else:
    right = mid
  self._pool = self._pool[left:]
  self.conn_num -= left
 self._lock.release()
由于获取和释放连接均从self._pool尾部操作,该容器为先进后出队列。队列中越靠近头部的连接闲置时间越长,从头到尾闲置时间递减。基于此,使用二分法找出列表中第一个未超时的连接,删除其之前的所有连接,实现O(logN)时间复杂度。需注意,若所有连接均超时,此方法无法完全清理,需单独处理边界情况。
三. 总结
1. 完整代码及分析
该连接池完整代码如下:
import threading
import time
from typing import Any

from client import HTTPConnection, HTTPResponse


class WrapperHTTPConnection:

 def __init__(self, pool: 'HTTPConnectionPool', conn: HTTPConnection) -> None:
  self.pool = pool
  self.conn = conn
  self.response = None
  self.last_time = time.time()
  self.is_available = True

 def __enter__(self) -> 'WrapperHTTPConnection':
  return self

 def __exit__(self, *exit_info: Any) -> None:
  # 如果response没读完并且连接需要复用,就弃用这个连接
  if not self.response.will_close and not self.response.is_closed():
   self.close()
  self.pool.release(self)

 def request(self, *args: Any, **kwargs: Any) -> HTTPResponse:
  self.conn.request(*args, **kwargs)
  self.response = self.conn.get_response()
  return self.response

 def close(self) -> None:
  self.conn.close()
  self.is_available = False


class HTTPConnectionPool:

 def __init__(self, host: str, port: int = None, max_size: int = None, idle_timeout: int = None) -> None:
  """
  :param host: pass
  :param port: pass
  :param max_size: 同时存在的最大连接数, 默认None->连接数无限,没了就创建
  :param idle_timeout: 单个连接单次最长空闲时间,超时自动关闭,默认None->不限时
  """
  self.host = host
  self.port = port
  self.max_size = max_size
  self.idle_timeout = idle_timeout
  self._lock = threading.Condition()
  self._pool = []
  # 这里的conn_num指的是总连接数,包括其它线程拿出去正在使用的连接
  self.conn_num = 0
  self.is_closed = False
  self._clearer = None
  self.start_clear_conn()

 def acquire(self, blocking: bool = True, timeout: int = None) -> WrapperHTTPConnection:
  if self.is_closed:
   raise ConnectionPoolClosed
  with self._lock:
   if self.max_size is None or not self.is_full():
    # 在还能创建新连接的情况下,如果没有空闲连接,直接创建一个就行了
    if self.is_pool_empty():
     self._put_connection(self._create_connection())
   else:
    # 不能创建新连接的情况下,如果设置了blocking=False,没连接就报错
    # 否则,就基于timeout进行阻塞,直到超时或者有可用连接为止
    if not blocking:
     if self.is_pool_empty():
      raise EmptyPoolError
    elif timeout is None:
     while self.is_pool_empty():
      self._lock.wait()
    elif timeout < 0:
     raise ValueError("'timeout' must be a non-negative number")
    else:
     end_time = time.time() + timeout
     while self.is_pool_empty():
      remaining = end_time - time.time()
      if remaining <= 0:
       raise EmptyPoolError
      self._lock.wait(remaining)
   # 走到这一步了,池子里一定有空闲连接
   return self._get_connection()

 def release(self, conn: WrapperHTTPConnection) -> None:
  if self.is_closed:
   # 如果这个连接是在连接池关闭后才释放的,那就不用回连接池了,直接放生
   conn.close()
   return
  # 实际上,python列表的append操作是线程安全的,可以不加锁
  # 这里调用锁是为了通过notify方法通知其它正在wait的线程:现在有连接可用了
  with self._lock:
   if not conn.is_available:
    # 如果这个连接不可用了,就应该创建一个新连接放进去,因为可能还有其它线程在等着连接用
    conn.close()
    self.conn_num -= 1
    conn = self._create_connection()
   self._put_connection(conn)
   self._lock.notify()

 def _get_connection(self) -> WrapperHTTPConnection:
  # 这个方法会把连接从_idle_conn移动到_used_conn列表中,并返回这个连接
  try:
   return self._pool.pop()
  except IndexError:
   raise EmptyPoolError

 def _put_connection(self, conn: WrapperHTTPConnection) -> None:
  conn.last_time = time.time()
  self._pool.append(conn)

 def _create_connection(self) -> WrapperHTTPConnection:
  self.conn_num += 1
  return WrapperHTTPConnection(self, HTTPConnection(self.host, self.port))

 def is_pool_empty(self) -> bool:
  # 这里指的是,空闲可用的连接是否为空
  return len(self._pool) == 0

 def is_full(self) -> bool:
  if self.max_size is None:
   return False
  return self.conn_num >= self.max_size

 def close(self) -> None:
  if self.is_closed:
   return
  self.is_closed = True
  self.stop_clear_conn()
  pool, self._pool = self._pool, None
  for conn in pool:
   conn.close()

 def clear_idle_conn(self) -> None:
  if self.is_closed:
   raise ConnectionPoolClosed
  # 这里开一个新线程来清理空闲连接,避免了阻塞主线程导致的定时精度出错
  threading.Thread(target=self._clear_idle_conn).start()

 def _clear_idle_conn(self) -> None:
  if not self._lock.acquire(timeout=self.idle_timeout):
   # 因为是每隔self.idle_timeout秒检查一次
   # 如果过了self.idle_timeout秒还没申请到锁,下一次都开始了,本次也就不用继续了
   return
  current_time = time.time()
  if self.is_pool_empty():
   pass
  elif current_time - self._pool[-1].last_time >= self.idle_timeout:
   # 这里处理下面的二分法没法处理的边界情况,即所有连接都闲置超时的情况
   self.conn_num -= len(self._pool)
   self._pool.clear()
  else:
   # 通过二分法找出从左往右第一个不超时的连接的指针
   left, right = 0, len(self._pool) - 1
   while left < right:
    mid = (left + right) // 2
    if current_time - self._pool[mid].last_time >= self.idle_timeout:
     left = mid + 1
    else:
     right = mid
   self._pool = self._pool[left:]
   self.conn_num -= left
  self._lock.release()

 def start_clear_conn(self) -> None:
  if self.idle_timeout is None:
   # 如果空闲连接的超时时间为无限,那么就不应该清理连接
   return
  self.clear_idle_conn()
  self._clearer = threading.Timer(self.idle_timeout, self.start_clear_conn)
  self._clearer.start()

 def stop_clear_conn(self) -> None:
  if self._clearer is not None:
   self._clearer.cancel()

 def __enter__(self) -> 'HTTPConnectionPool':
  return self

 def __exit__(self, *exit_info: Any) -> None:
  self.close()


class EmptyPoolError(Exception):
 pass


class ConnectionPoolClosed(Exception):
 pass
连接池核心在于管理连接,包含取出和释放两个过程。其本质为生产者-消费者模型:取出连接时为消费者,放入连接时为生产者。使用threading自带的Condition对象可完美解决线程安全问题,实现二者协同。
解决获取与释放连接后,连接池已具备基本功能。若需处理更多细节,如判断连接可用性、自动释放、清理闲置连接等,则需封装连接,添加更多属性和方法,由此引入WrapperHTTPConnection类。实现其__enter__和__exit__方法后,即可通过上下文管理器自动释放连接。至于清理闲置连接,通过last_time属性记录每个连接的最后释放时间,并在连接池中添加定时任务即可实现。
以上就是如何用python实现一个HTTP连接池的详细内容,更多关于python 实现一个HTTP连接池的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









