

零基础学Python能接外包单吗?新手常见的变现误区与现实分析

直接给出明确结论:零基础学习 Python 经过几个月基础训练后,几乎无法稳定承接具备商业价值的技术外包。市场上宣传的“掌握基础语法或简单爬虫即可月入兼职数千元”严重脱离实际交付标准。本文将剥离宣传滤镜,从商业交付的本质、新手高频认知误区、客户真实的验收需求,以及一条可衡量的能力成长路径,展开具体的现实分析。
外包市场的核心矛盾:语法认知与商业交付的鸿沟
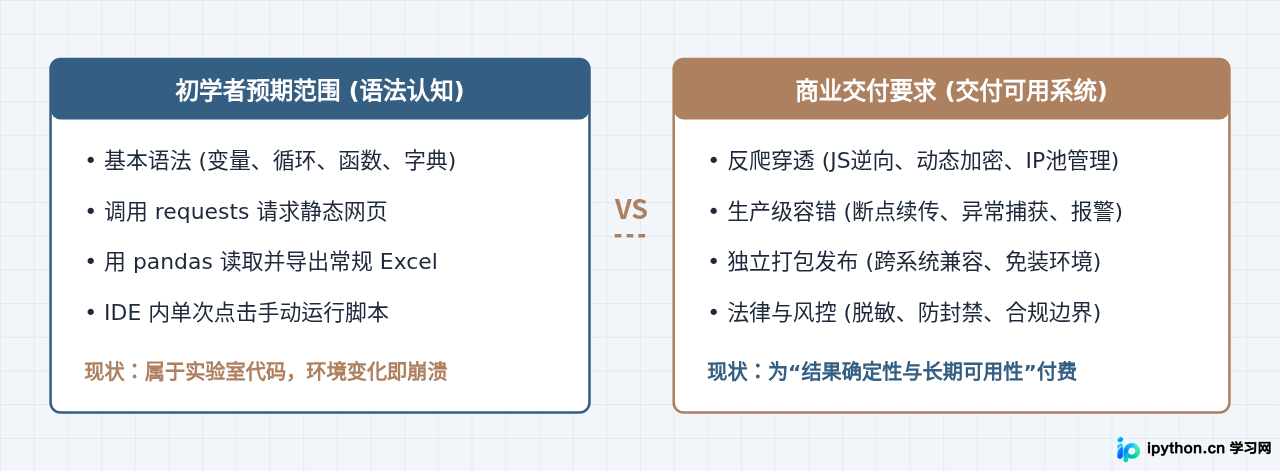
初学者的核心误区通常在于混淆了“能够看懂代码逻辑”与“具备工程交付能力”。完成教材里的练习题只要求程序在特定输入下打印出预想结果,而在外包市场中,客户购买的是“无故障运行的解决方案”。
外包项目需要处理运行环境不确定、网络异常中断、输入数据格式混乱、目标站点动态防护、业务逻辑变更等不可预见的问题。初学者往往只学到如何编写十几行核心调用脚本,却缺乏自动化部署、日志埋点、防崩容错与持续维护的工程积累。
新手常见的四大变现误区剖析
误区一:“学了爬虫就能到处抓数据卖钱”
网络爬虫是许多入门课程主推的方向,但新手往往忽略了其技术壁垒和法律边界。现代网络平台普遍部署了前端混淆加密、行为验证码和自动化风险控制机制。商业订单要求抓取的往往正是这些受保护的高价值数据,仅凭 requests 或 BeautifulSoup 连目标数据包都无法解析。
此外,商业抓取涉及显著的法律合规风险。违规采集包含用户隐私、付费壁垒或受知识产权保护的数据,或抓取频次过高影响对方服务器正常运行,均可能触犯《个人信息保护法》及相关网络安全法规。
误区二:“写几行办公自动化脚本就能卖几百元”
用几行代码操作 Excel、批量重命名文件或提取 PDF 文本,演示效果通常很直观,但在现实中很难转化为商业订单。客户通常不具备 Python 运行环境,无法直接接收一个 .py 文件并在终端配置 pip install。
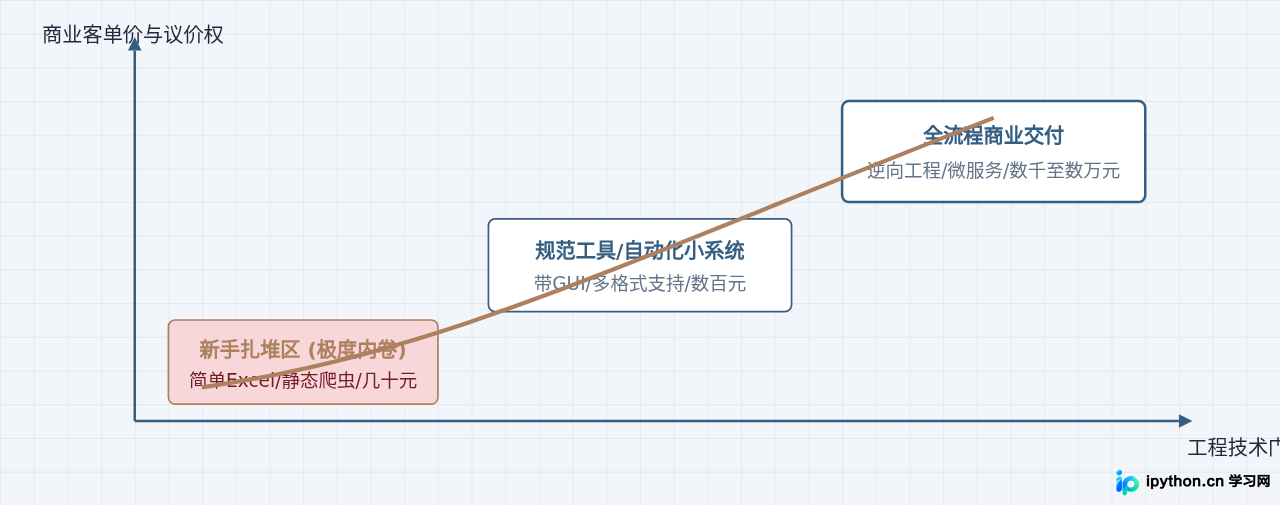
交付此类项目时,开发者需要处理复杂的依赖打包、制作跨平台界面(如 PyQt 或 Tkinter)、解决不同操作系统字符编码冲突,并应对各类非标准化表格格式。为几张表格花费数天调试,最终可能仅能收取几十元服务费,时间成本远高于收益。
误区三:“接单群里有大量新手友好型低价单”
社交群聊、贴吧或部分网赚平台常有大量二道贩子发布“几十元爬取指定数据”的简易需求。这类订单存在几类典型现实问题:
- 需求变更频繁:发包方往往没有确定接口文档,验收时临时要求增加数据字段或格式重构。
- 平台中间抽成高:中介层层转包,最终执行者承担全部编码和调试工作,却只能分得微薄报酬。
- 结算风险高:缺乏第三方资金托管,代码交付后被直接拉黑或拖欠尾款的情况并不鲜见。
误区四:“AI 工具普及后,零基础靠生成代码就能接单”
大语言模型确实可以快速生成结构良好的代码片段,但它无法替开发者完成业务意图沟通与现场联调排错。当模型生成的代码遇到第三方依赖冲突、特定反爬机制拦截或由于接口格式微调导致报错时,缺乏底层基础的初学者根本无法看懂错误日志,更无法进行断点跟踪与性能调优。
真实外包订单的技术要求到底包含什么?
为了具体说明商业交付与个人练习的差异,以最普遍的“电商价格监控与报表导出”需求为例:
| 项目环节 | 新手代码(练习水平) | 商业交付(外包验收标准) |
|---|---|---|
| 网络请求 | 直接 requests.get() 获取页面,遇 403 报错即中断退出。 |
维护代理 IP 池、动态更新 Headers/Cookies、自适应重试与指数退避机制。 |
| 数据清洗 | 直接解析固定字典键值,遇到数据缺失直接抛出异常崩溃。 | 严格的数据 Schema 验证、缺失值与脏数据兜底过滤、规范日志记录。 |
| 运行环境 | 仅在开发者个人电脑的终端手动运行:python test.py。 |
利用 Docker 容器化打包或使用 PyInstaller 编译为包含配置文件的无依赖可执行程序。 |
| 售后运维 | 交付后即算完成,目标网站改版导致脚本失效时无力解决。 | 提供版本更新预案、配置与业务逻辑解耦,约定维护窗口与变更支持。 |
以下是两者在代码实现结构上的直接差异:
新手常见代码示例(脆弱无防御):
import requests
from bs4 import BeautifulSoup

# 存在明显缺陷:未设超时、无异常捕获、无风控处理
res = requests.get("https://example.com/items")
soup = BeautifulSoup(res.text, "html.parser")
title = soup.find("h1").text
print("抓取成功:", title)
商业交付要求代码结构示例(健壮与容错):
import logging
import time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.INFO, format="%(asctime)s - [%(levelname)s] - %(message)s")

def fetch_data_robust(url: str, max_retries: int = 3) -> dict:
    session = requests.Session()
    # 配置指数退避重试机制
    retries = Retry(total=max_retries, backoff_factor=1, status_forcelist=[429, 500, 502, 503, 504])
    session.mount("https://", HTTPAdapter(max_retries=retries))

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
        "Accept": "application/json"
    }

    try:
        response = session.get(url, headers=headers, timeout=10)
        response.raise_for_status()
        payload = response.json()

        # 结构合法性校验
        if "data" not in payload:
            logging.error("响应格式异常:缺少 data 根字段")
            return {}
        return payload["data"]

    except requests.exceptions.RequestException as e:
        logging.critical(f"网络通信失败或达到最大重试次数: {e}")
        return {}
    finally:
        session.close()

# 模拟安全调用
result = fetch_data_robust("https://httpbin.org/json")
logging.info(f"结果状态: {'成功' if result else '失败'}")合格商业交付的全生命流程
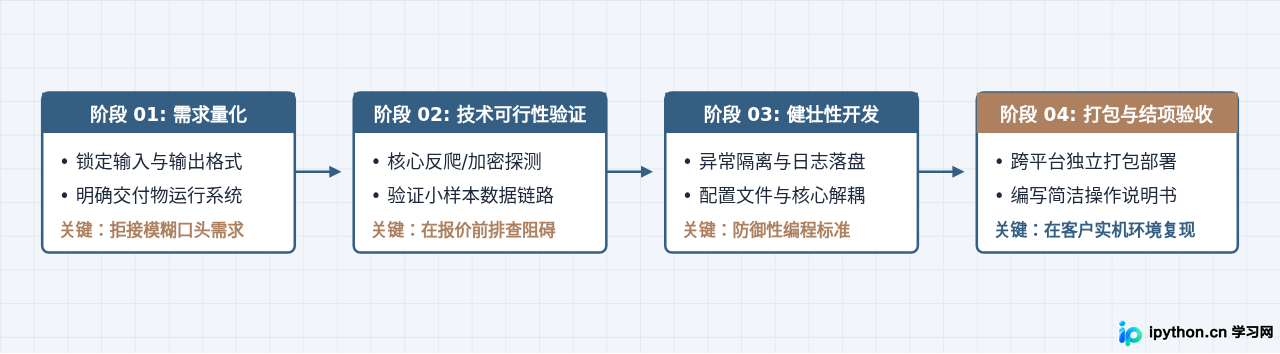
编写代码在外包项目中通常只占整体工作量的三分之一左右。一个标准的外包订单需要经历完整的工程闭环:
可落地的学习与能力演进路径
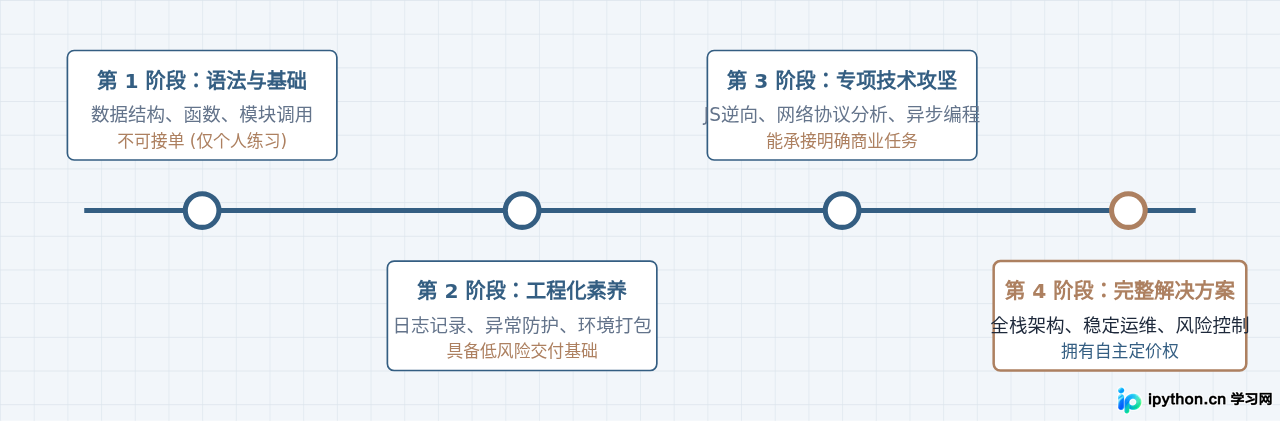
如果学习 Python 的最终目标是具备承接商业外包的能力,建议放弃“快速速成兼职”的幻想,将关注点从语法记忆转移到真正的软件工程实践上。
判断自身能力是否达到接单门槛,可以通过以下具体指标进行自测:
- 环境解耦能力:能否在不借助系统全局 Python 环境的前提下,熟练使用虚拟环境管理依赖,并将程序封装为在他人纯净电脑上双击即可运行的成品。
- 问题排错能力:脱离搜索引擎与教学辅助,能否直接读懂 Python Traceback 报错栈,并熟练使用断点调试定位逻辑错误。
- 逆向分析基础:面对使用了动态渲染、Token 加密或前端混淆的目标页面,能否熟练使用浏览器开发者工具分析网络链路,理清参数生成机制。
- 业务交互能力:能否把客户宽泛甚至自相矛盾的口头需求,转化为格式明确、包含边界条件与交付工期的技术需求文档。
总结与理性建议
学习编程是一项长期的工程技能投资。Python 是一门兼具简洁性与实用价值的优秀编程语言,非常适合用来解决日常工作中的重复劳动、自动化处理繁琐数据以及快速验证个人想法。
但对于零基础学习者而言,不宜将短期兼职接单设为核心学习驱动力。当脱离了“快速变现”带来的焦虑,把注意力放回计算机网络基础、系统交互原理与扎实的工程编码实践上,逐步建立解决复杂问题的综合能力,获得商业变现的能力才会水到渠成。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









