

Python导入文件数据至List的方法与路径错误解决

本文介绍在Python中将文件数据导入List的完整流程,涵盖按行读取、去除换行符及按分隔符拆分字符串的具体代码实现。重点解析Windows路径中反斜杠引发的UnicodeEscape编码错误,并提供使用原始字符串r前缀的标准解决方案,确保路径解析准确无误。
Python文件数据导入List的实现方法
在Python开发中,将外部文件数据导入到列表(List)结构是一项基础且常见的操作,具体实现步骤如下所示。
为了便于演示,我们可以生成包含随机数据的文件样例进行测试。
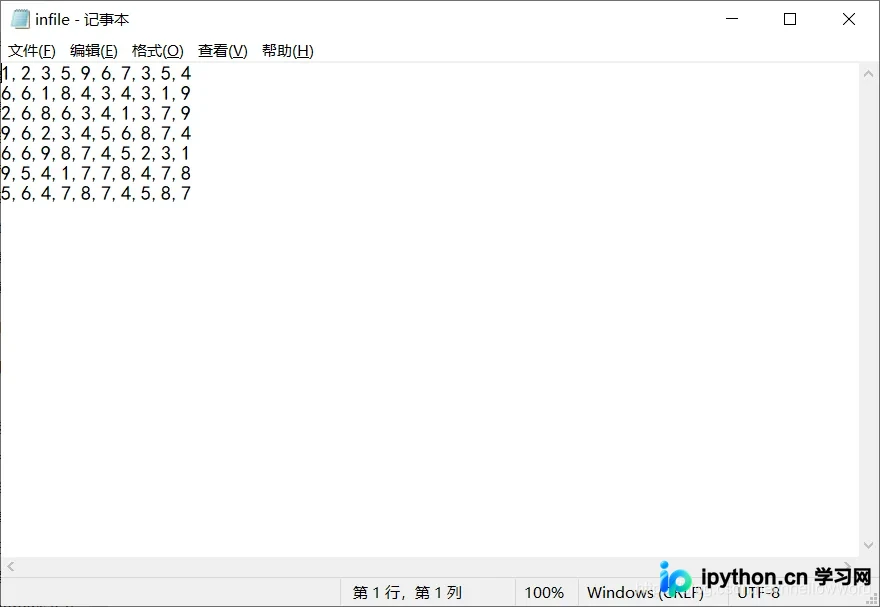
在读取过程中,变量temp1用于处理每一行的数据,通过去除行尾的分隔符(如回车符'\n')来清理数据。
变量temp2则定义行内数据的分隔方式,用户可根据实际需求自定义分隔符,例如使用逗号','或制表符'\t'(代表空格或Tab)。
核心代码解析
def loadDatadet(infile):
  f=open(infile,'r')
  sourceInLine=f.readlines()
  dataset=[]
  for line in sourceInLine:
    temp1=line.strip('\n')
    temp2=temp1.split(',')
    dataset.append(temp2)
  return dataset

infile=r'C:\Users\Clevo\Desktop\infile.txt'
infile=loadDatadet(infile)
print(infile)
最终,程序将处理后的数据组装并返回一个包含所有数据集的List对象dataset。

解决文件路径UnicodeEscape报错
如果在代码中直接写入包含反斜杠的文件路径,程序往往会抛出异常报错。
常见的错误提示为:(unicode error) 'unicodeescape' codec can't decode bytes in position 2-3: truncated \UXXXXXXXX escap。
该错误产生的原因是Python将字符串中的'\'识别为转义字符,而'\u'会被解释为Unicode编码的起始标志,导致后续路径解析失败。解决方法是在字符串常量前添加字母'r',将其声明为原始字符串(Raw String),从而忽略转义字符的特殊含义。
至此,关于Python中导入文件数据至List的操作方法及路径报错的解决方案已介绍完毕。如需了解更多相关技术细节,可查阅本站往期文章或继续关注后续更新,感谢大家的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









