

Python批量校验目标检测标签文件行数一致性

发布时间:2026-10-14| 4人浏览过
本文介绍利用Python脚本批量对比目标检测数据集中标注文件与训练后标签文件的行数。通过遍历指定目录下的TXT文件,统计每对文件的行数量并输出差异结果,从而快速识别漏检情况,避免逐张检查图片的低效操作。
Python批量校验目标检测标签文件行数一致性
在深度学习目标检测任务中,完成数据集测试后,可通过批量比对两个数据目录下的标签文件行数,快速判断是否存在漏检现象,从而免去逐张检查图片的繁琐工作。
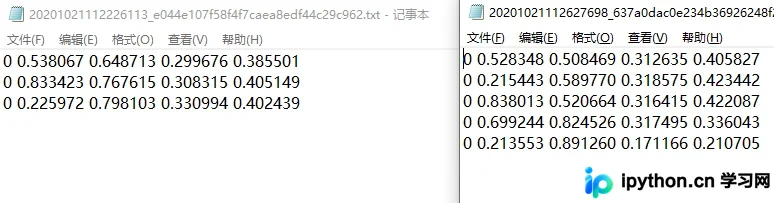
通过对比打标文件与训练后生成的标签文件行数,可以有效发现漏检问题。
具体实现代码如下:
Python批量校验代码实现
#coding=utf-8
import os, glob
import numpy as np

path1 = 'temp//1//'
path2 = 'temp//2//'

file_one_list = glob.glob(path1 + "*.txt")
file_two_list = glob.glob(path2 + "*.txt")
print(len(file_one_list))

for item in (file_one_list):
 base_name = os.path.basename(item)
 with open(item,'r') as f:
  lines_one=f.readlines()
 cur_file_path = os.path.join(path2, base_name)
 if os.path.exists(cur_file_path):
  with open(cur_file_path,'r') as f:
   lines_two=f.readlines()
  if len(lines_one)!=len(lines_two):
   print("检测框不对应:",base_name)
 else:
  print("不在在文件",base_name)
总结
至此,关于使用Python批量检查两个对应txt文件行数是否一致的方法介绍完毕。如需了解更多Python处理txt文件的相关内容,可搜索本站历史文章或继续浏览后续文章,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









