

Python统计建模实战:Statsmodels线性回归与时间序列分析

本文详细介绍如何利用Python的Statsmodels库进行统计建模。内容涵盖普通最小二乘(OLS)线性回归、ARMA时间序列模型及预测,并深入讲解回归诊断方法,包括残差正态性检验、异方差性检测及多重共线性检查,帮助读者掌握从建模到评估的完整流程。
前言
前言
在之前的系列文章中,我们已经系统讲解了Python数据处理的核心技能,包括数据读取、缺失值处理及数据降维等预处理步骤,同时也介绍了Matplotlib和pyecharts等主流数据可视化工具。在掌握这些基础能力后,若需进行更深层次的数据洞察,就必须引入统计建模方法。本文将聚焦于如何利用Python实现统计分析。与以往侧重理论推导不同,本文旨在通过代码实例展示建模过程,省略复杂的数学公式推导(因为常见模型的推导资料极易获取)。因此,读者需预先了解回归模型、时间序列等基本统计概念。
Statsmodels简介
Statsmodels简介
在Python生态中,进行统计计算与建模的首选工具是Statsmodels模块。这是一个专注于统计分析与建模的Python库,主要具备以下核心功能:
- 探索性数据分析:提供列联表分析、链式方程多重插补(MICE)等方法,并支持生成拟合图、箱线图、相关图及时间序列图等统计可视化图表。
- 回归模型支持:涵盖线性回归、非线性回归、广义线性模型(GLM)以及线性混合效应模型等多种模型类型。
- 其他统计功能:支持方差分析(ANOVA)、时间序列分析等模型的参数估计,以及针对估计参数的假设检验。
安装 brew install Statsmodels 文档 github.com/statsmodels/statsmodels
线性回归模型:普通最小二乘估计
线性回归模型:普通最小二乘估计
线性模型家族包括普通最小二乘(OLS)、广义最小二乘(GLS)和加权最小二乘(WLS)等。Statsmodels对这些模型提供了良好的支持。下面我们通过一个最简单的例子来演示普通最小二乘(OLS)的实现过程。
首先导入相关包
%matplotlib inline
import numpy as np
import statsmodels.api as sm
import matplotlib.pyplot as plt
from statsmodels.sandbox.regression.predstd import wls_prediction_std
np.random.seed(9876789)
然后创建数据,先设置样本量为100
nsample = 100 #样本数量然后设置x1和x2,x1是0到10等差排列,x2是x1的平方
x = np.linspace(0, 10, 100)
X = np.column_stack((x, x**2))
再设置beta、误差项与响应变量y
beta = np.array([1, 0.1, 10])
e = np.random.normal(size=nsample)
X = sm.add_constant(X)
y = np.dot(X, beta) + e
接着建立回归模型
model = sm.OLS(y, X)
results = model.fit()
print(results.summary())
查看模型结果
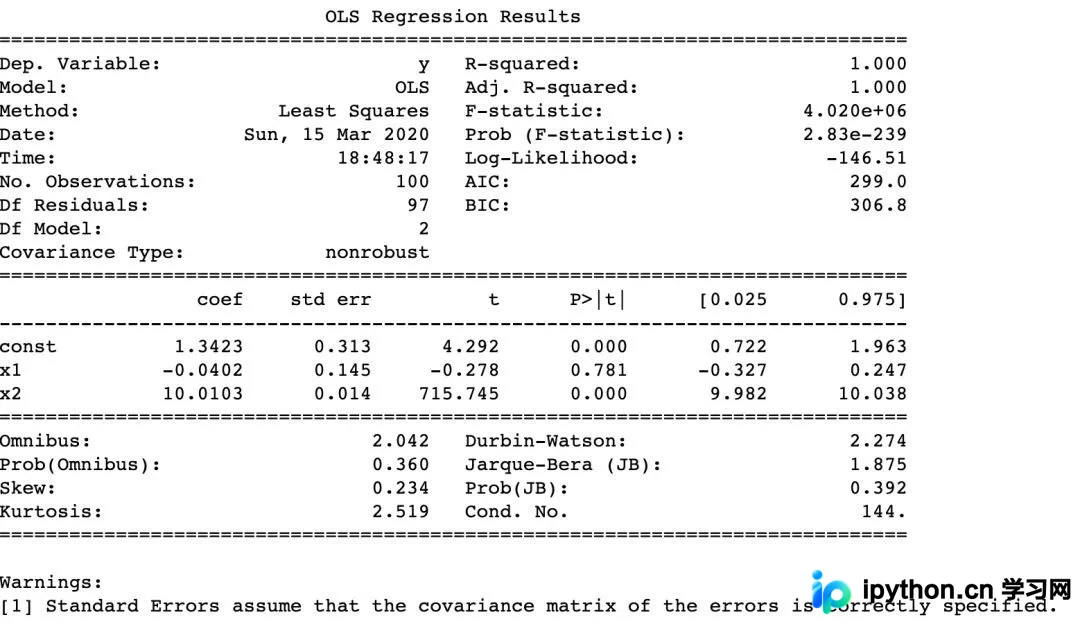
其输出格式与R语言非常相似,包含了回归系数、P值(P-value)、R平方(R-squared)等关键评估指标。此外,还可以使用dir(results)查看并调用结果对象中的所有变量。
print('Parameters: ', results.params)
print('R2: ', results.rsquared)
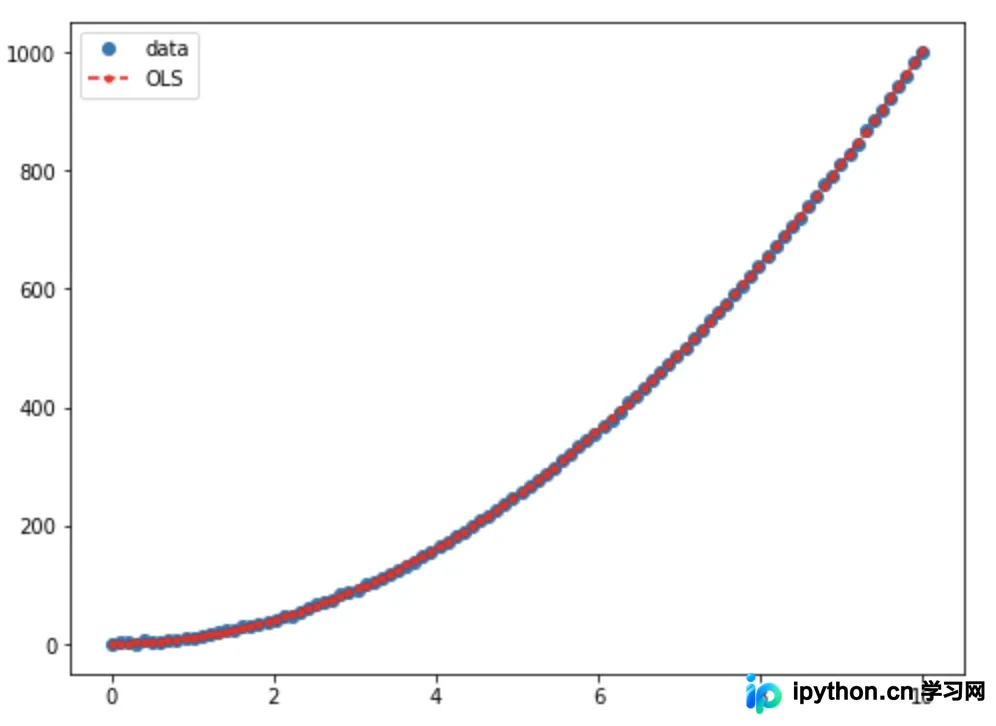
由此得到的回归方程为y=1.3423-0.0402x1+10.0103x2。当然,该模型仍有优化空间,具体优化工作留给读者完成。接下来,我们绘制样本点与回归曲线以直观展示拟合效果。
y_fitted = results.fittedvalues
fig, ax = plt.subplots(figsize=(8,6))
ax.plot(x, y, 'o', label='data')
ax.plot(x, y_fitted, 'r--.',label='OLS')
ax.legend(loc='best')
时间序列:ARMA
时间序列:ARMA
时间序列模型种类繁多,此处以ARMA模型为例进行演示。首先导入所需包并生成模拟数据。
%matplotlib inline
import numpy as np
import statsmodels.api as sm
import pandas as pd
from statsmodels.tsa.arima_process import arma_generate_sample
np.random.seed(12345)

arparams = np.array([.75, -.25])
maparams = np.array([.65, .35])

arparams = np.r_[1, -arparams]
maparams = np.r_[1, maparams]
nobs = 250
y = arma_generate_sample(arparams, maparams, nobs)
接着,我们可以添加日期信息。在本例中,我们将使用pandas的时间序列功能来构建模型。
dates = sm.tsa.datetools.dates_from_range('1980m1', length=nobs)
y = pd.Series(y, index=dates)
arma_mod = sm.tsa.ARMA(y, order=(2,2))
arma_res = arma_mod.fit(trend='nc', disp=-1)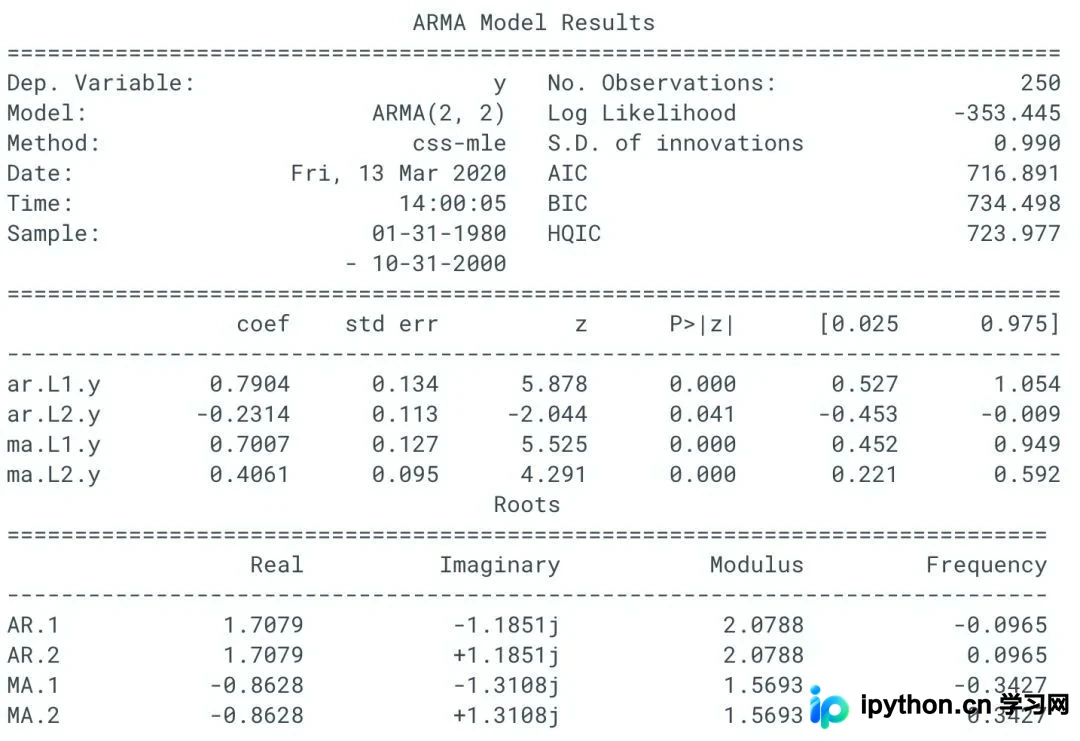
最后,进行模型预测。
import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(10,8))
fig = arma_res.plot_predict(start='1999-06-30', end='2001-05-31', ax=ax)
legend = ax.legend(loc='upper left')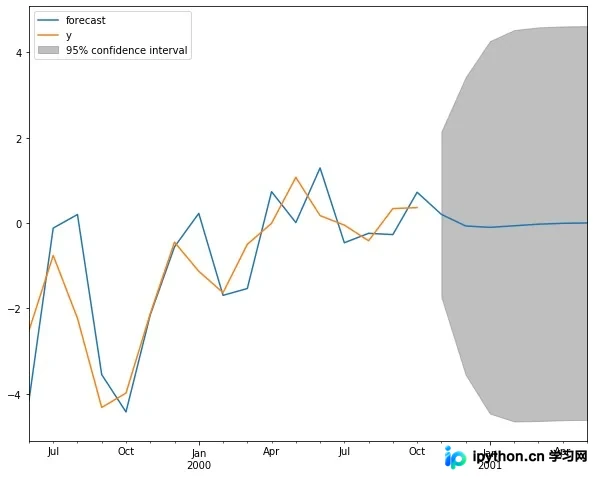
回归诊断:估计回归模型
回归诊断:估计回归模型
首先导入相关包
%matplotlib inline
from statsmodels.compat import lzip
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
import statsmodels.stats.api as sms
import matplotlib.pyplot as plt
然后加载数据
url = 'https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/HistData/Guerry.csv'
dat = pd.read_csv(url)
拟合模型
results = smf.ols('Lottery ~ Literacy + np.log(Pop1831)', data=dat).fit()查看结果
print(results.summary())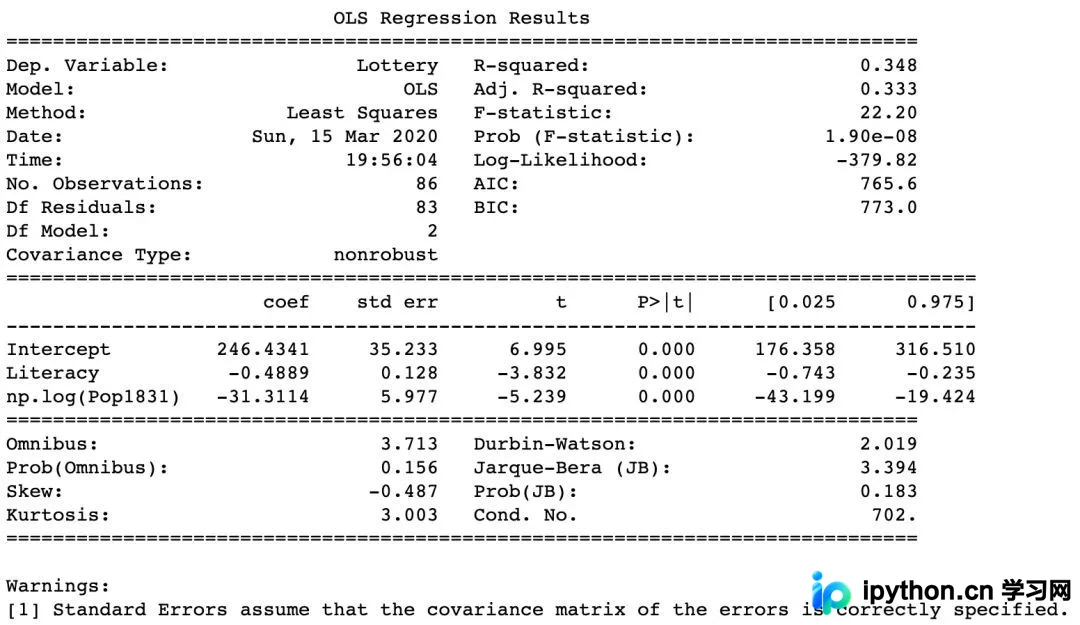
回归诊断:残差的正态性
回归诊断:残差的正态性
Jarque-Bera test:
name = ['Jarque-Bera', 'Chi^2 two-tail prob.', 'Skew', 'Kurtosis']
test = sms.jarque_bera(results.resid)
lzip(name, test)
####结果
[('Jarque-Bera', 3.3936080248431666),
('Chi^2 two-tail prob.', 0.1832683123166337),
('Skew', -0.48658034311223375),
('Kurtosis', 3.003417757881633)]
Omni test:
name = ['Chi^2', 'Two-tail probability']
test = sms.omni_normtest(results.resid)
lzip(name, test)
####结果
[('Chi^2', 3.713437811597181), ('Two-tail probability', 0.15618424580304824)]
回归诊断:异方差
回归诊断:异方差
Breush-Pagan test:
name = ['Lagrange multiplier statistic', 'p-value',
    'f-value', 'f p-value']
test = sms.het_breuschpagan(results.resid, results.model.exog)
lzip(name, test)
###结果
[('Lagrange multiplier statistic', 4.893213374093957),
('p-value', 0.08658690502352209),
('f-value', 2.503715946256434),
('f p-value', 0.08794028782673029)]
Goldfeld-Quandt test
name = ['F statistic', 'p-value'] test = sms.het_goldfeldquandt(results.resid, results.model.exog) lzip(name, test) ####结果 [('F statistic', 1.1002422436378152), ('p-value', 0.3820295068692507)]
回归诊断:多重共线性
回归诊断:多重共线性
检查多重共线性可以使用
np.linalg.cond(results.model.exog)结果是702.1792145490062,说明存在较强多重共线性。
结束语
结束语
以上介绍了Statsmodels的基本功能。熟悉R语言的读者会发现,许多命令与R非常相似。最后想补充一点:本文未深入展开模型的理论知识,因为模型推导过程通过搜索引擎即可找到详尽的优质解答。因此,在掌握计算机实现方法后,务必回过头来理解模型中每个参数的计算过程及其实际含义,这才是真正掌握统计建模的关键。
以上就是Python进行统计建模的详细内容,更多关于Python统计建模的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









