

Pandas中inplace参数的正确用法与常见陷阱解析

本文深入解析Pandas中inplace参数的核心机制,通过对比inplace=True与False的执行差异,阐明其如何直接修改原始数据对象。文章重点剖析了针对DataFrame切片使用inplace时引发的警告原因,并提供了使用subset参数修正的正确方案,帮助开发者避免将None赋值给变量的常见错误,提升代码效率与规范性。
Pandas中inplace参数的正确用法与常见陷阱解析
介绍
在处理数据帧时,无论是初学者还是经验丰富的数据科学家,往往对如何在Pandas中正确使用inplace参数感到困惑。
令人意外的是,网络上深入解释这一概念的教程并不多,它常被默认为不言自明的基础知识。然而,这对许多用户来说并不直观,因此本文旨在清晰阐述inplace参数的含义及其正确使用方法。
支持inplace参数的常用函数
以下是一些支持inplace参数的常见函数示例:
- fillna()
- dropna()
- sort_values()
- reset_index()
- sort_index()
- rename()
上述列表可能并未涵盖所有使用inplace参数的函数,但Pandas中绝大多数DataFrame方法都遵循类似的逻辑。掌握本文介绍的原理后,您将能够灵活应用于其他相关函数。
示例数据框构建与基础操作演示
创建一个示例DataFrame
为了直观展示inplace的用法,我们首先构建一个示例数据框。
import pandas as pd
import numpy as np
client_dictionary = {'name': ['Michael', 'Ana', 'Sean', 'Carl', 'Bob'],
           'second name': [None, 'Angel', 'Ben', 'Frank', 'Daniel'],
           'birth place': ['New York', 'New York', 'Los Angeles', 'New York', 'New York'],
           'age': [10, 35, 56, None, 28],
           'number of children': [0, None, 2, 1, 1]}
df = pd.DataFrame(client_dictionary)
df.head()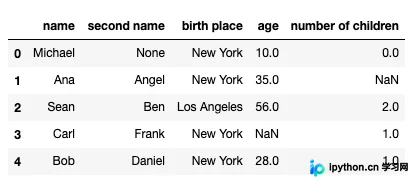
该数据框包含5行数据,列名分别为:name、second name、birthplace、age和number of children。需要注意的是,age、second name和children列中包含缺失值(nan)。
接下来,我们将演示dropna()函数如何配合inplace参数工作。为了对比两种不同模式的效果,我们创建原始数据框的两个副本。
df_1 = df.copy()
df_2 = df.copy()
以下代码将删除所有包含缺失值的行。
df_1.dropna(inplace=True)
如果在Jupyter Notebook中执行此代码,单元格将不会显示任何输出。这是因为当inplace=True时,函数不返回任何值,而是直接在原始数据帧上执行修改操作(即“就地”修改)。
此时,若调用head()函数查看数据框,您会发现有两行数据已被删除。
df_1.dropna(inplace=True)
现在,我们使用inplace=False执行相同的代码。请注意,这次操作针对的是df_2副本。
df_2.dropna(inplace=False)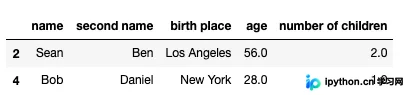
在Jupyter Notebook中运行此代码时,您将看到输出结果(见上方截图)。当inplace=False时,函数会返回一个包含删除行后数据的新数据框。
关键点在于:当inplace设置为True时,函数不返回任何内容,但原始数据已被修改。
那么,原始数据究竟发生了什么变化?让我们通过调用head()函数进行检查。
df_2.head()
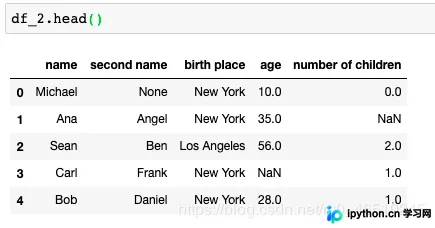
原始数据保持不变!这引发了一个问题:究竟发生了什么?
当使用inplace=True时,系统会创建并修改一个新的对象,而非直接改变原始数据。如果您希望原始数据反映删除行后的状态,必须将结果重新赋值给原始变量,如下方代码所示。
df_2 = df_2.dropna(inplace=False)
这正是我们在未使用inplace时的操作方式。事实上,最后一行代码等价于:
df_2.dropna(inplace=True)
相比之下,使用inplace=True的代码更为优雅,因为它避免了创建中间对象再重新赋值的步骤,直接改变原始数据框。因此,在需要修改原始数据时,推荐优先使用inplace=True。
那么,为什么在使用inplace=True时有时会报错或产生警告?这通常源于对该参数使用方式的不熟悉。让我们分析一些常见错误。
常见错误与修正方案
常见错误
对inplace = True处理数据片段
假设我们只想去除second name和age列中的NaN值,而保留number of children列不变,该如何操作?
常见的一种错误写法如下:
df[['second name', 'age']].dropna(inplace=True)
这将触发以下警告信息。
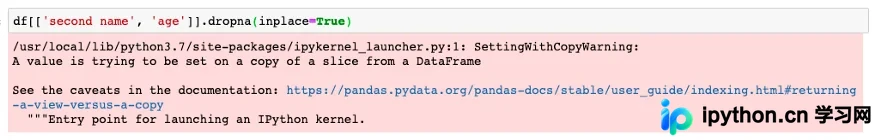
出现该警告是因为Pandas设计者出于谨慎考虑,提醒用户避免执行可能不符合预期的操作。上述代码实际上是在修改一个仅包含两列的数据框片段,而非原始数据框。这是因为您选择了数据框的一个子集,并将dropna()应用到了这个子集上,而非原始数据框。
正确的修正方法如下:
df.dropna(inplace=True, subset=['second name', 'age'])
df.head()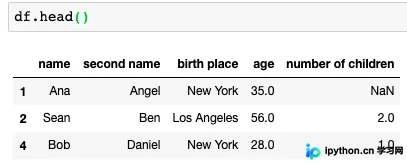
这将导致从数据框中删除second name和age列中值为空的行,同时保留其他列数据。
将变量值赋给inplace=True的结果
df = df.dropna(inplace=True)
这是另一种绝对应避免的做法!您实际上是将None重新赋值给了df。请记住,当使用inplace=True时,函数不返回任何值。因此,上述代码的执行结果是将None赋值给df,导致数据丢失。
总结
希望本文能帮助您彻底理解inplace参数,从而在代码中正确、高效地使用它。
到此这篇关于快速解释如何使用pandas的inplace参数的使用的文章就介绍到这了,更多相关pandas inplace参数内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









