

大模型结构化输出:稳定生成JSON数据的方法

先定义可靠的JSON结构与输出契约
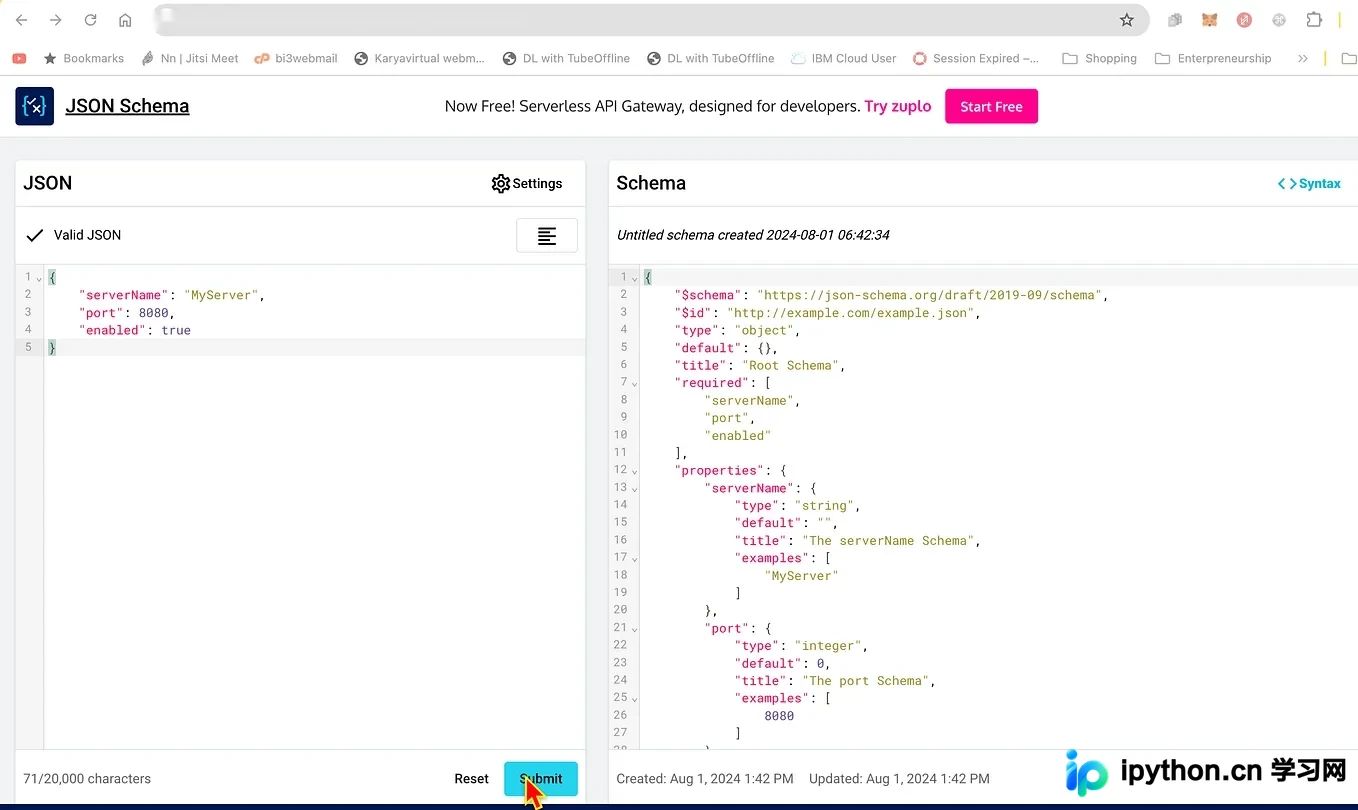
设计可靠的JSON输出契约是稳定生成的第一步。必须使用标准JSON Schema明确定义数据结构,包括每个字段的类型(如string、integer、boolean)、是否必填(required数组)、枚举值(enum)以及嵌套对象的层级关系。例如,定义一个用户信息对象时,应明确age为整数且大于0,role限定为["admin", "user"],并设置required包含id与name。模糊的提示词(如“请返回用户信息”)极易导致模型自由发挥,产生字段缺失、类型错乱(如将数字返回为字符串)或附加无关文本。通过契约化设计,模型在生成前已具备明确的填空框架,大幅降低随机性,确保下游系统能按预期解析。
用结构化输出能力约束大模型生成
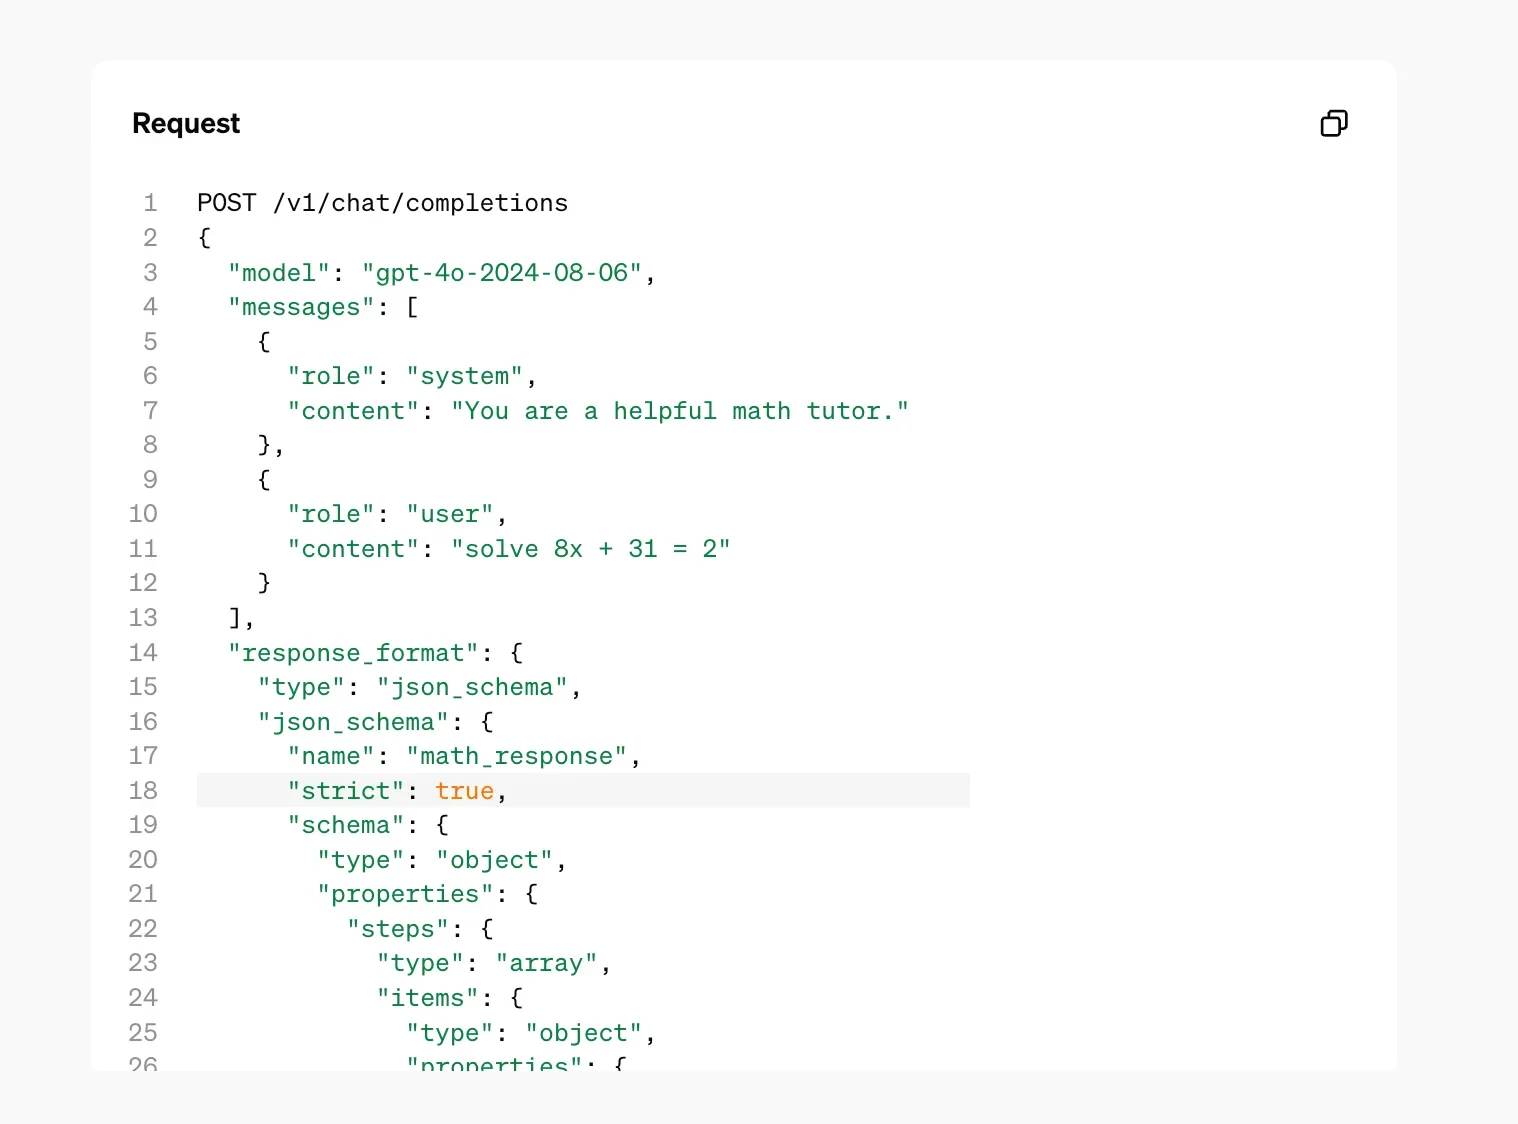
仅依赖提示词约束无法保证结构稳定,必须结合大模型原生的结构化输出能力。主流平台已提供response_format或tool_use机制,强制模型在底层解码阶段遵循Schema规则。对于支持Structured Outputs的模型,开启strict模式可彻底拦截非法字段与类型偏差;若使用函数调用,则需将参数定义映射为JSON Schema。适用场景上,简单键值对可用基础JSON模式,复杂业务逻辑推荐函数调用或工具定义。关键配置包括关闭自由文本生成、设置合理的temperature(建议0.1至0.3)以及明确指定输出格式参数,从而在推理源头实现硬性约束。
生成后验证、解析与自动修复
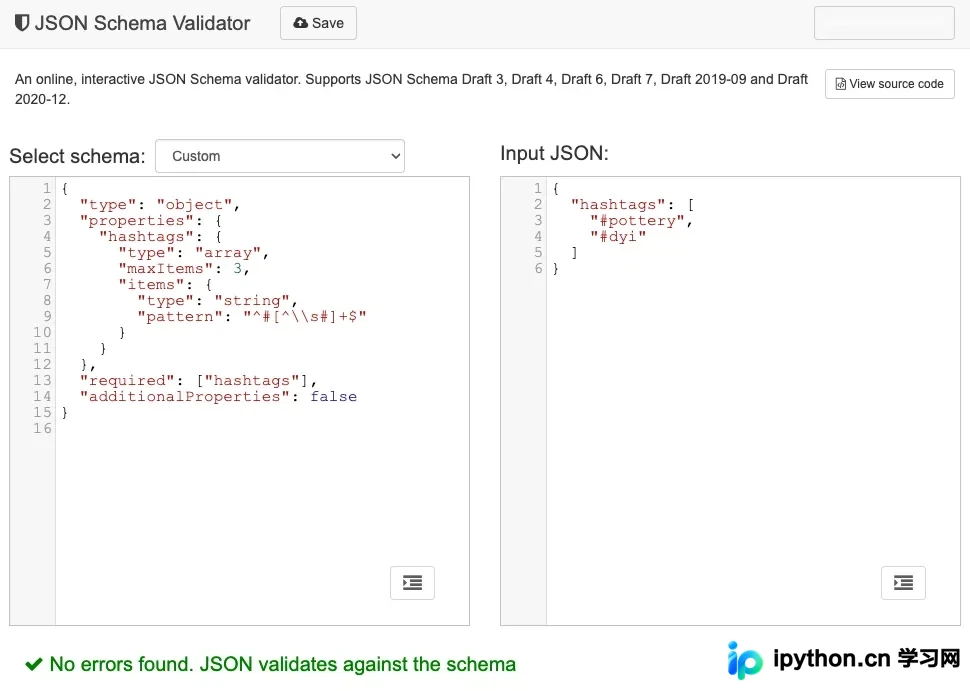
模型输出后需建立完整的解析与验证链路。首先使用标准JSON解析器捕获语法错误;随后通过校验库对照预定义Schema进行字段完整性与类型检查。若校验失败,不应直接丢弃,而应触发自动修复机制:例如利用正则表达式剥离首尾非JSON字符,或调用轻量级修复Prompt让模型自我纠正。对于关键业务,可设置降级策略,如返回默认空对象或缓存历史有效数据。完整链路应包含原始输出捕获、语法清洗、Schema强校验、失败重试(最多两次)与降级兜底,确保数据流不断裂且可追溯。
常见失败场景与稳定性避坑
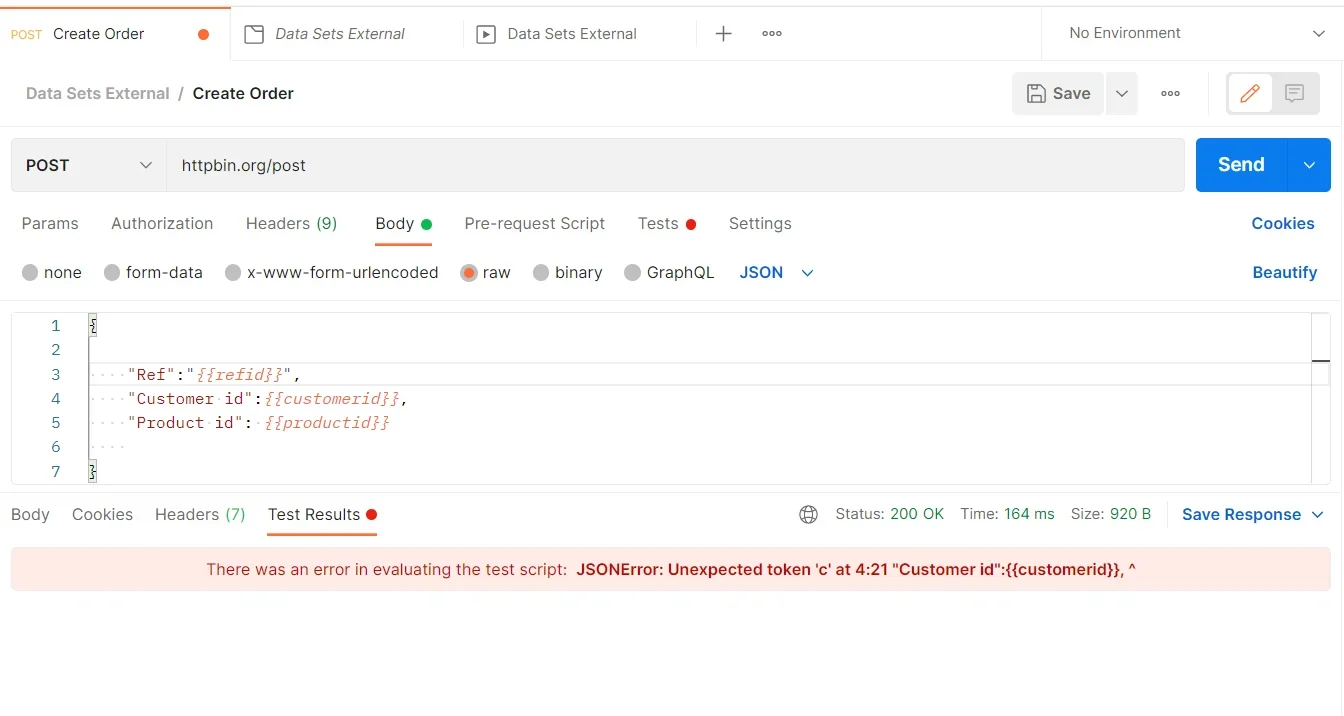
实际应用中常遇多种格式陷阱。模型常将JSON包裹在Markdown代码块中,需通过正则或字符串切片剥离;附加解释性文字会破坏纯JSON结构,应在提示词末尾强调仅输出JSON且禁止任何额外说明。截断问题多因最大令牌数设置过小,需根据Schema预估长度并预留余量。字段漂移可通过严格Schema与大小写锁定规避。嵌套层级过深易引发括号不匹配,建议扁平化设计或限制最大深度。超长输出会导致解析超时,应拆分任务或启用流式校验。针对空值与缺失字段,需在Schema中定义默认值或明确允许空值,并在代码层做防御性判空。
建立可上线的JSON输出验证方案
上线前必须构建自动化验证体系。首先收集覆盖常规、边界与异常场景的测试样本集,通过持续集成流水线自动运行Schema校验脚本,统计通过率与字段覆盖率。引入失败率监控面板,实时追踪解析异常、类型不匹配与重试次数,设置阈值告警。Schema应实施版本化管理,任何字段增删需同步更新校验规则并回归测试。生产环境落地检查清单包括:核心接口强制开启严格模式、部署解析中间件并记录原始响应日志、配置熔断与降级开关、定期抽样人工复核模型输出质量。通过测试驱动与持续监控,确保JSON输出在迭代中保持高可用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









