

Python使用openpyxl实现Excel数据匹配与Vlookup功能

发布时间:2026-10-14| 4人浏览过
本文介绍如何使用Python的openpyxl库实现类似Excel Vlookup的数据匹配功能。通过自定义脚本,自动处理大小写、空格等数据清洗问题,并将源工作表指定列的数据精准复制到目标工作表的对应列中,提升批量数据处理效率。
函数参数规范与数据清洗机制
注意调用函数时,参数之间必须使用英文逗号分隔,且逗号前后不能包含空格。
函数参数依次指定为:源文件名、可选的工作表名称(若不填写则默认使用当前激活的工作表)、数据起始行号(若不填写则默认为第二行,因为通常第一行为标题行),以及需要匹配的列名列表(第一列为查找键,后续列名无需连续,例如可指定为“ade”)。
脚本在读取数据时,会自动对查找列的第一列数据进行标准化处理,包括转换为小写和去除首尾空格。在后续示例中,尽管第一列数据存在大小写混用及前后空格的情况,脚本仍能将其视为相同值进行匹配。
Excel数据匹配操作示例
假设存在名为Sheet1的工作表,其内容如下所示。
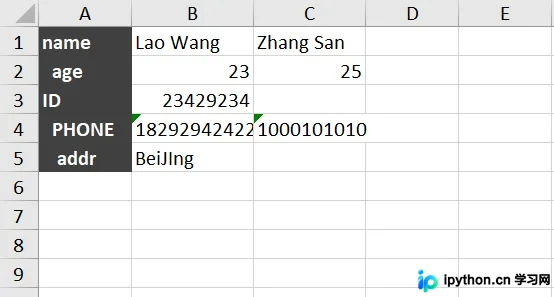
目标工作表Sheet2的初始内容如下所示。
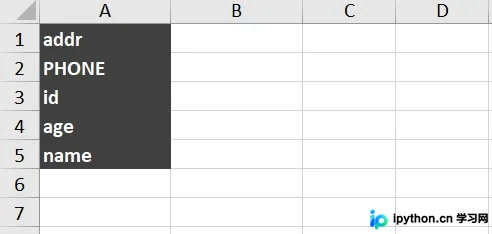
若需将Sheet1中的B列和C列数据复制到Sheet2的对应B列和C列,可执行以下脚本。
Source fileName,[sheetName],[row],columns:
vlookup.xlsx,Sheet1,1,abc
Target fileName,[sheetName],[row],columns:
vlookup.xlsx,Sheet2,1,abc
{'name': ['Lao Wang', 'Zhang San'], 'age': [23, 25], 'id': [23429234, None], 'phone': ['18292942422', '1000101010'], 'addr': ['BeiJIng', None]}
{'addr': [None, None], 'phone': [None, None], 'id': [None, None], 'age': [None, None], 'name': [None, None]}
Processing...
Done.
执行脚本后,Sheet2的内容将更新为匹配后的结果。
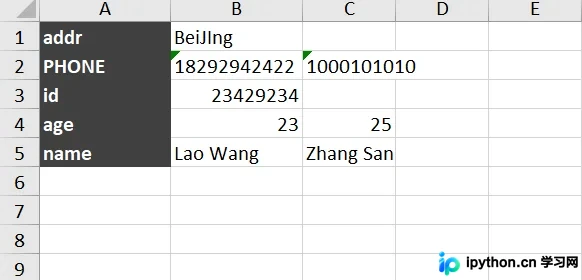
核心代码实现与执行流程
import openpyxl

def read_Excel(path,sheetName,row,*col):
  # 默认从第二行开始,因为很多表都有表头
  if row == '':
    row = 2
  else:
    row = int(row)
  workbook = openpyxl.load_workbook(path)
  # 默认打开当前激活的工作表
  if sheetName == "":
    sheet0 = workbook.active # 获取当前激活的工作表
  else:
    sheet0 = workbook[sheetName] # 如果制定了工作表,就打开指定的工作表
  highest = sheet0.max_row
  case_list = {}
  # title 所在列,对比的那一列,假设A列
  title = col[0]
  for i in range(row,highest+1): # 遍历行
    value_list = []
    if sheet0[title+str(i)].value == None: # 如果A5是空的,pass
      pass
    else:
      v1 = sheet0[title+str(i)].value.lower().strip() # 忽略大小写和前后空格
      # 除去 title的其他列
      for j in range(1,len(col)):
        v2 = sheet0[col[j]+str(i)].value
        value_list.append(v2)
      case_list[v1] = value_list
  print(case_list)
  return case_list

def write_Excel(dict,path,sheetName,row,*col):
  # 将处理好的数据再次写入excel
  if row == "":
    row = 2
  else:
    row = int(row)
  workbook = openpyxl.load_workbook(path)
  if sheetName == "":
    sheet0 = workbook.active # 获取当前激活的工作表
  else:
    sheet0 = workbook[sheetName]
  highest = sheet0.max_row
  # case title 所在列
  title = col[0]
  for i in range(row,highest+1):
    if sheet0[title + str(i)].value != None:
      v1 = sheet0[title + str(i)].value.lower().strip() # 忽略大小写和前后空格
      for key in dict:
        if key == v1:
          for j in range(1,len(col)):
            v2 = sheet0[col[j]+str(i)]
            v2.value = dict[key][j-1]
  workbook.save(path)

def process(r1,r2):
  # 对比处理两次读取的内容,然后更新r2的内容
  print('Processing...')
  for key in r1:
    if key in r2:
      length = len(r1[key])
      if length > 0:
        for i in range(0, len(r1[key])):
          # 如果想要不想覆盖原有的数值,可以取消注释,然后删除下面那行
          # if r2[key][i] == None:
            # r2[key][i] = r1[key][i]
          r2[key][i] = r1[key][i]
    else:
      pass

  return r2

def manual():
  info1 = input('Read from fileName,[sheetName],[row],columns:\n')
  file1,sheetName1,row1,list1 = info1.split(',')

  info2 = input('Write into fileName,[sheetName],[row],columns:\n')
  file2,sheetName2,row2,list2 = info2.split(',')

  r1 = read_Excel(file1,sheetName1,row1,*list1)
  r2 = read_Excel(file2,sheetName2,row2,*list2)

  r3 = process(r1,r2)
  write_Excel(r3,file2,sheetName2,row2,*list2)

  print('Done.')

if __name__ == "__main__":
  manual()
以上内容涵盖了利用Python实现Excel数据匹配的核心步骤,希望能为读者的学习提供有益参考,也欢迎继续支持本站获取更多技术分享。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









