

Python计算信息熵与相关指标实现

发布时间:2026-10-14| 5人浏览过
本文介绍如何使用Python计算数据集的信息熵,涵盖基于概率对数计算的实现方法,以及利用Pandas和NumPy进行批量统计的进阶技巧。内容包含信息熵、条件熵、信息增益、增益率及离散值相关性的完整代码示例,适用于机器学习特征选择场景。
信息熵计算公式
信息熵的计算公式涉及类别数量n以及第i类的概率p(xi)。
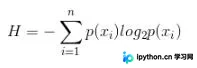
基础信息熵计算代码
假设数据集包含m行,即m个样本,其中每行的最后一列为该样本的标签。计算该数据集信息熵的代码实现如下:
from math import log

def calcShannonEnt(dataSet):
  numEntries = len(dataSet) # 样本数
  labelCounts = {} # 该数据集每个类别的频数
  for featVec in dataSet: # 对每一行样本
    currentLabel = featVec[-1] # 该样本的标签
    if currentLabel not in labelCounts.keys(): labelCounts[currentLabel] = 0
    labelCounts[currentLabel] += 1
  shannonEnt = 0.0
  for key in labelCounts:
    prob = float(labelCounts[key])/numEntries # 计算p(xi)
    shannonEnt -= prob * log(prob, 2) # log base 2
  return shannonEnt
高级统计指标实现
补充知识:使用Python实现信息熵、条件熵、信息增益及基尼系数的计算方法。
以下直接展示相关代码实现。
import pandas as pd
import numpy as np
import math
## 计算信息熵
def getEntropy(s):
  # 找到各个不同取值出现的次数
  if not isinstance(s, pd.core.series.Series):
    s = pd.Series(s)
  prt_ary = pd.groupby(s , by = s).count().values / float(len(s))
  return -(np.log2(prt_ary) * prt_ary).sum()
## 计算条件熵: 条件s1下s2的条件熵
def getCondEntropy(s1 , s2):
  d = dict()
  for i in list(range(len(s1))):
    d[s1[i]] = d.get(s1[i] , []) + [s2[i]]
  return sum([getEntropy(d[k]) * len(d[k]) / float(len(s1)) for k in d])

## 计算信息增益
def getEntropyGain(s1, s2):
  return getEntropy(s2) - getCondEntropy(s1, s2)

## 计算增益率
def getEntropyGainRadio(s1, s2):
  return getEntropyGain(s1, s2) / getEntropy(s2)

## 衡量离散值的相关性
import math
def getDiscreteCorr(s1, s2):
  return getEntropyGain(s1,s2) / math.sqrt(getEntropy(s1) * getEntropy(s2))

# ######## 计算概率平方和
def getProbSS(s):
  if not isinstance(s, pd.core.series.Series):
    s = pd.Series(s)
  prt_ary = pd.groupby(s, by = s).count().values / float(len(s))
  return sum(prt_ary ** 2)
######## 计算基尼系数
def getGini(s1, s2):
  d = dict()
  for i in list(range(len(s1))):
    d[s1[i]] = d.get(s1[i] , []) + [s2[i]]
  return 1-sum([getProbSS(d[k]) * len(d[k]) / float(len(s1)) for k in d])
## 对离散型变量计算相关系数,并画出热力图, 返回相关性矩阵
def DiscreteCorr(C_data):
  ## 对离散型变量(C_data)进行相关系数的计算
  C_data_column_names = C_data.columns.tolist()
  ## 存储C_data相关系数的矩阵
  import numpy as np
  dp_corr_mat = np.zeros([len(C_data_column_names) , len(C_data_column_names)])
  for i in range(len(C_data_column_names)):
    for j in range(len(C_data_column_names)):
      # 计算两个属性之间的相关系数
      temp_corr = getDiscreteCorr(C_data.iloc[:,i] , C_data.iloc[:,j])
      dp_corr_mat[i][j] = temp_corr
  # 画出相关系数图
  fig = plt.figure()
  fig.add_subplot(2,2,1)
  sns.heatmap(dp_corr_mat ,vmin= - 1, vmax= 1, cmap= sns.color_palette('RdBu' , n_colors= 128) , xticklabels= C_data_column_names , yticklabels= C_data_column_names)
  return pd.DataFrame(dp_corr_mat)

if __name__ == "__main__":
  s1 = pd.Series(['X1' , 'X1' , 'X2' , 'X2' , 'X2' , 'X2'])
  s2 = pd.Series(['Y1' , 'Y1' , 'Y1' , 'Y2' , 'Y2' , 'Y2'])
  print('CondEntropy:',getCondEntropy(s1, s2))
  print('EntropyGain:' , getEntropyGain(s1, s2))
  print('EntropyGainRadio' , getEntropyGainRadio(s1 , s2))
  print('DiscreteCorr:' , getDiscreteCorr(s1, s1))
  print('Gini' , getGini(s1, s2))
以上Python计算信息熵的实例内容分享完毕,供参考使用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









