

Python 多线程与多进程详解:GIL限制、进程间通信及进程池应用

本文深入解析 Python 多线程受 GIL 限制的本质,阐明其适用于 I/O 密集型任务。重点介绍利用多进程突破 GIL 限制实现多核计算的方法,详细对比 Queue、Pipe 和 Manager 三种进程间通信机制,并讲解进程锁与进程池(apply/apply_async)的使用场景及性能优化策略。
Python 多线程与 GIL 的本质
在 Python 中,多线程并非真正的并行执行。无论系统拥有多少 CPU 核心,同一时刻只能有一个线程在单个核心上运行。Python 多线程主要利用 CPU 上下文切换的优势,营造出并发的假象,实际上它仍受限于全局解释器锁(GIL),因此常被称为“伪多线程”。
那么,在什么场景下应当使用多线程呢?
首先需要明确以下概念:
- I/O 操作不占用 CPU 资源。
- 计算操作占用 CPU 资源,例如执行 2+5=7 等算术运算。
由于上述原因,Python 的多线程不适合 CPU 密集型任务,而更适合 I/O 密集型任务,例如 SocketServer 网络服务处理。
利用多进程突破 GIL 限制
如果必须处理 CPU 密集型任务,该如何解决?
首先,多进程之间是相互独立的。需要注意的是,Python 的线程和进程均调用操作系统的原生线程和进程接口。Python 仅通过 C 原生代码库接口创建进程,真正的进程管理由操作系统负责。操作系统本身没有 GIL(全局解释器锁),且不同进程间的数据完全独立,无法直接互相访问,因此不存在 GIL 的概念。在这种情况下,每个进程至少包含一个线程。如果操作系统是八核的,启动八个进程,每个进程内包含一个线程,这就相当于实现了八线程在八核上的并行运行,从而解决了多核利用的问题。
这种方法的唯一缺点是各进程间的数据无法直接共享,彼此独立。利用这种方法可以在一定程度上折中解决多核运算的问题。
先来看一段简单的多进程程序示例:
import multiprocessing
import time

def run(name):
 time.sleep(2)
 print('hello', name)

if __name__ == '__main__':
 for i in range(10):
  p = multiprocessing.Process(target=run, args=('bob%s'%i,))
  p.start()
程序的执行结果为:
hello bob0 hello bob1 hello bob3 hello bob2 hello bob5 hello bob9 hello bob7 hello bob8 hello bob4 hello bob6
那么,如果想获取进程号,该怎么做呢?
from multiprocessing import Process
import os

def info(title):
 print(title)
 print('module name:', __name__)
 print('parent process:', os.getppid()) # 父进程ID
 print('process id:', os.getpid()) # 自己进程的ID
 print("\n\n")

def f(name):
 info('\033[31;1mfunction f\033[0m')
 print('hello', name)

if __name__ == '__main__':
 info('\033[32;1mmain process line\033[0m')
 p = Process(target=f, args=('bob',))
 p.start()
 p.join()
程序执行的结果为:
main process line module name: __main__ parent process: 5252 process id: 6576
function f module name: __mp_main__ parent process: 6576 process id: 2232
hello bob
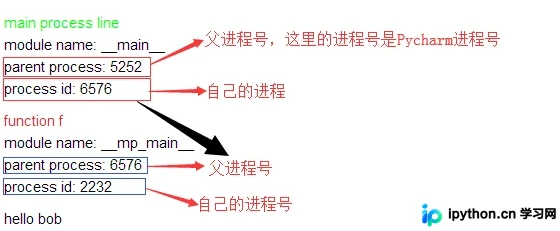
其实这幅图片的意思是,每一个子进程都是由他父进程启动的。
进程间通信机制详解
进程间通讯
我们说两个进程之间的内存之间是相互独立的,那么这两个进程能够进行通信吗?说A进程向访问B进程的数据,能访问吗?肯定是不可以访问的!但是,我就是想访问,也就是两个独立的内存想互相访问,那该怎么办呢?
有那么几种方式,但是呢!万变不离其宗,也即是说你必须找到一个中间件,有那么几种中间件,那么先来看看是哪几种
使用 Queue 进行通信
第一种Queues
使用方法跟threading里的queue差不多
from multiprocessing import Process, Queue

def f(q):
 q.put([42, None, 'hello'])

if __name__ == '__main__':
 q = Queue()
 p = Process(target=f, args=(q,))
 p.start()
 print(q.get()) # prints "[42, None, 'hello']"
 p.join()
我们看这两个进程,父进程的q是怎么传给子进程的?我们来讨论一下
现在我们是不是认为数据共享了,两个进程共享了一个q,其实不是的,其实是相当于克隆了一个q,然后在父进程里创建个子进程,也就是父进程把自己的q克隆了一份交给了子进程,子进程这个时候往这个q里面放了一份数据,父进程能够获取到 。那么这么说就不对了,那克隆了一个q,也就是两个q了,B往q里放了一个数据,那么与另一个q,也就是A的q也就没关系了,嗳,按说是这个样子的,但是实际上呢,它是不是想实现个数据的共享啊,就相当于把A这个q里的数据序列化了,序列化到了一个中间的位置,而中间位置有一个翻译,他把这个数据反序列化给A,放在了A的q里,那么也就是实现了所谓的数据共享了。
程序执行的结果为:
[42, None, 'hello']
使用 Pipe 管道通信
第二种Pipes
Pipe()函数返回一个由管道连接的连接对象,默认情况下是双工(双向)。 例如:
from multiprocessing import Process, Pipe

def f(conn):
 conn.send("父亲,安好?") # 儿子发
 print("son receive:",conn.recv())
 conn.close()


if __name__ == '__main__':
 parent_conn, child_conn = Pipe()
 p = Process(target=f, args=(child_conn,))
 p.start()
 print("father receive:",parent_conn.recv()) # 父亲收
 parent_conn.send("儿子,安好?")
 p.join()
程序执行后的结果为:
father receive: 父亲,安好? son receive: 儿子,安好?
Pipe()返回的两个连接对象代表管道的两端。 每个连接对象都有send()和recv()方法(以及其他方法)。 请注意,如果两个进程(或线程)同时尝试读取或写入管道的同一端,则管道中的数据可能会损坏。 当然,同时使用管道的不同端部的过程不存在损坏的风险。
使用 Manager 管理器
第三种Managers
Manager()返回的管理器对象控制一个服务器进程,该进程保存Python对象并允许其他进程使用代理操作它们。
Manager()返回的管理器将支持类型列表,dict,Namespace,Lock,RLock,Semaphore,BoundedSemaphore,Condition,Event,Barrier,Queue,Value和Array。 例如,
from multiprocessing import Process, Manager
import os

def f(d, l):
 d[1] = '1'
 d['2'] = 2
 d[0.25] = None
 l.append(os.getpid())
 print(l)

if __name__ == '__main__':
 with Manager() as manager:
  d = manager.dict() # 用专门的语法生成一个可在多个进程之间进行传递和共享的一个字典

  l = manager.list(range(5)) # # 用专门的语法生成一个可在多个进程之间进行传递和共享的一个列表,默认里有5个数据
  p_list = []
  for i in range(10):
   p = Process(target=f, args=(d, l))
   p.start()
   p_list.append(p)
  for res in p_list:
   res.join()
  print(d)
  print(l)
程序执行的结果为:
[0, 1, 2, 3, 4, 2100] [0, 1, 2, 3, 4, 2100, 7632] [0, 1, 2, 3, 4, 2100, 7632, 5788] [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340] [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340, 5760] [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340, 5760, 7072] [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340, 5760, 7072, 7540] [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340, 5760, 7072, 7540, 3904] [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340, 5760, 7072, 7540, 3904, 7888] [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340, 5760, 7072, 7540, 3904, 7888, 7612] {1: '1', '2': 2, 0.25: None} [0, 1, 2, 3, 4, 2100, 7632, 5788, 6340, 5760, 7072, 7540, 3904, 7888, 7612]
进程锁与进程池应用
进程锁与进程池
进程锁
进程也有一个锁,what?进程不都独立了吗?不涉及同时修改同一个数据,怎么还会有锁呢?
闲了来看看它的表现形式,几乎和线程是一模一样的
from multiprocessing import Process, Lock

def f(l, i):
 l.acquire()
 try:
  print('hello world', i)
 finally:
  l.release()

if __name__ == '__main__':
 lock = Lock()
 for num in range(10):
  Process(target=f, args=(lock, num)).start()
程序执行的结果为:
hello world 3 hello world 1 hello world 2 hello world 5 hello world 7 hello world 4 hello world 0 hello world 6 hello world 8 hello world 9
那这种锁有什么作用呢?
作用其实就是防止打印在屏幕上的信息发生错乱现象!
进程池
在上面的程序中,启动100个进程会发现变慢了,因为起一个进程就相当克隆了一份父进程的内存数据,如果父进程占一个G的内存空间,那我起100个进程,就相当于101G了,在这种情况下,开销是非常大的,就像起一个进程咵嚓又克隆了一个屋子,一会就把哈尔滨占满了,所以开销特别大,为了避免咵嚓起那么多的进程,把系统打趴下,所以这里有个进程池的限制。
进程池就是同一时间有多少进程在CPU运行。
进程池中有两个方法:
- apply(同步执行,串行)
- apply_async(异步执行、并行)
from multiprocessing import Process,Pool,freeze_support
import time
import os

def Foo(i):
 time.sleep(2)
 print("in process",os.getpid())
 return i+100

def Bar(arg):
 print('-->exec done:',arg)

if __name__ == '__main__':
 freeze_support()
 pool = Pool(5) # 允许进程池里同时放入5个进程

 for i in range(10):
  # pool.apply_async(func=Foo, args=(i,),callback=Bar) # callback 回调
  pool.apply(func=Foo, args=(i,)) # 串行
  # pool.apply_async(func=Foo, args=(i,)) # 并行

 print('end')

 pool.close()
 pool.join() # 进程池中进程执行完毕后再关闭,如果注释,那么程序直接关闭。
程序的执行结果为:
in process 7824 in process 6540 in process 7724 in process 8924 in process 9108 in process 7824 in process 6540
__name__ == '__main__' 的作用
知识点扩充:
__name__ == '__main__'的作用是:
手动执行关于这段代码的程序,那么他下面的程序就会执行,如果是调用这段代码的程序时,那么它下面的程序就不会执行
以上就是深入理解Python 多线程的详细内容,更多关于Python 多线程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









