

Nginx健康检查:upstream被动与主动检测

理解upstream被动健康检查机制
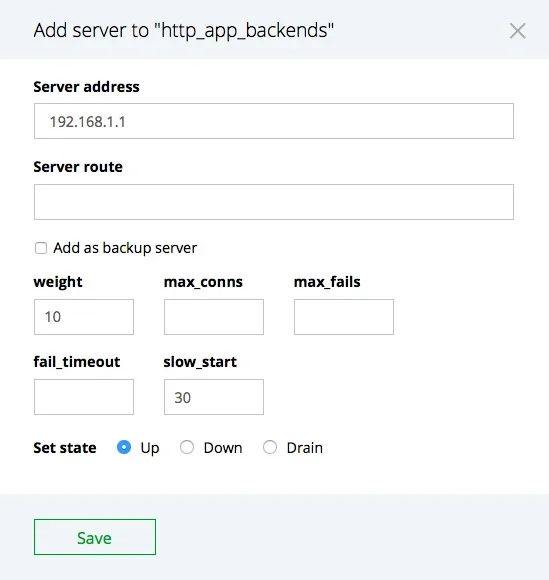
Nginx默认的upstream健康检查属于被动模式,其核心逻辑是以真实业务请求的成败作为判定依据。当客户端请求被代理到某台后端服务器时,若该请求在连接、读取或响应阶段发生错误,例如连接超时、拒绝连接或返回特定错误状态码,Nginx会记录一次失败。upstream块中的max_fails参数定义了允许的最大连续失败次数,fail_timeout则定义了统计失败次数的时间窗口以及后端被临时摘除的冷却期。例如配置server 192.168.1.10:8080 max_fails=3 fail_timeout=30s,表示在30秒内若该节点连续失败3次,Nginx将在接下来的30秒内停止向其转发流量,直到超时后重新尝试。必须明确的是,被动检查绝不等同于定时探活,它完全依赖业务流量触发。若无真实请求到达,即使后端已宕机,Nginx也不会主动感知,直到下一次请求失败才会触发摘除逻辑。这种机制轻量且零额外开销,但在低流量或冷启动场景下存在明显的滞后性。
配置主动健康检查与选择实现方案
主动健康检查与被动检查的根本区别在于探测发起方与触发时机。主动检查由Nginx自身按固定周期向后端发送专用探测请求,不依赖真实业务流量,从而能提前发现故障。原生开源版Nginx并不内置主动健康检查功能,企业需依赖Nginx Plus的商业模块或第三方开源方案,例如淘宝的nginx_upstream_check_module或OpenResty的balancer_by_lua结合定时任务。以Nginx Plus为例,配置主动HTTP探活需在upstream块中声明health_check指令,并指定interval探测间隔、fails判定失败次数、passes判定恢复次数及match块定义成功状态码。例如health_check interval=5s fails=3 passes=2 match=health配合match health { status 200; },表示每5秒发送一次GET请求,连续3次非200响应则标记宕机,连续2次200则恢复上线。该方案适用于对可用性要求极高、需秒级故障切换的核心业务,但需注意探测请求本身会消耗少量网络与计算资源,且必须确保后端提供轻量、无副作用的专用健康接口,避免探测逻辑与业务逻辑耦合。
验证健康检查是否真正生效
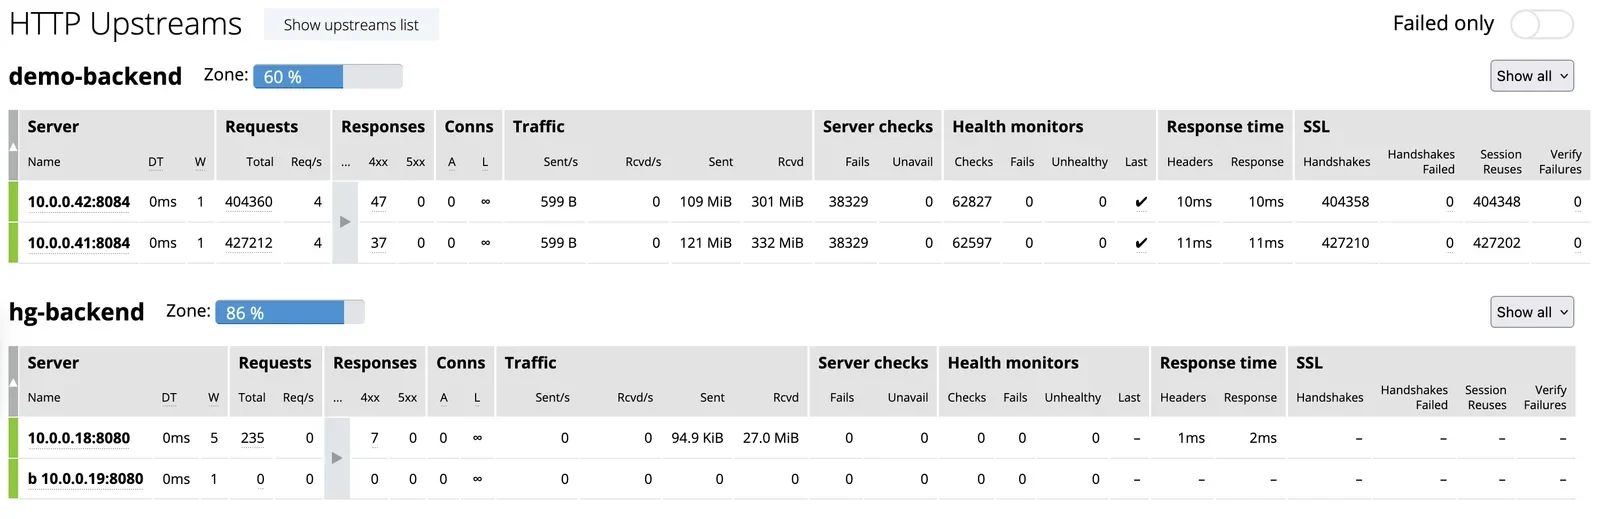
验证健康检查机制是否按预期工作,必须结合故障注入与多维度观测手段。首先通过curl -v http://your-nginx-ip/持续发起请求,同时使用tail -f /var/log/nginx/access.log和error.log观察流量分发与错误记录。验证被动检查时,可手动停止某台后端应用服务,持续发送请求直至触发max_fails阈值,此时error.log应出现upstream server temporarily disabled日志,且后续请求将不再路由至该节点。验证主动检查时,可通过修改后端健康接口返回503状态码模拟故障,观察Nginx是否在设定的interval与fails周期内将其摘除。恢复服务后,重新返回200状态码,观察Nginx是否在passes次成功探测后恢复流量转发。此外,可借助stub_status模块或Prometheus的nginx-exporter抓取upstream状态指标,量化查看各节点up、down状态切换时间戳。通过停服、观测摘除、启服、观测恢复的闭环测试,可精准验证参数配置与实际行为的一致性,避免配置仅停留在纸面。
生产环境避坑与配置建议
生产环境中健康检查配置极易因认知偏差引发雪崩或误判。首要误区是将被动检查当作主动探活,导致低峰期故障无法及时隔离;其次,若健康检查接口深度依赖数据库或外部中间件,一旦依赖项抖动,健康接口返回5xx将导致Nginx误摘除正常应用节点,形成假死现象。此外,探测频率设置过高会显著增加后端负载与网络开销,而忽略Nginx版本差异,例如误在开源版配置Plus专属指令,会导致配置重载失败。更严重的是,仅依赖Nginx摘除机制却未接入独立监控告警,故障发生时运维团队无法第一时间感知。建议按业务场景分级选型:对非核心、流量平稳的内部服务,采用原生被动检查配合合理的max_fails与fail_timeout即可;对核心网关或交易链路,务必引入主动健康检查,并采用独立于业务逻辑的轻量级探针;同时,所有健康检查状态必须同步至监控系统,配置阈值告警,实现自动隔离与人工兜底的双重保障体系。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









