

Python中defaultdict的使用与自定义默认值详解

发布时间:2026-10-13| 6人浏览过
本文解析Python中collections.defaultdict的使用场景。通过统计字母频率的示例,对比普通字典、setdefault方法与defaultdict的性能差异,展示defaultdict如何自动处理缺失键以避免KeyError。同时介绍如何通过自定义可调用对象实现复杂数据结构的默认初始化,提升代码简洁性与执行效率。
Python字典统计需求示例
首先明确一个具体的编程需求。
from collections import defaultdict

"""
需求: 统计user_list中字母出现的次数
"""

user_dict = {}
user_list = ['A', 'B', 'C', 'A', 'C', 'C']

# 第一种方式

for item in user_list:
  if item not in user_dict:
    user_dict[item] = 1
  else:
    user_dict[item] += 1

print(user_dict) # {'A': 2, 'B': 1, 'C': 3}

# 第二种方式
user_dict = {}
user_list = ['A', 'B', 'C', 'A', 'C', 'C']
for item in user_list:
  user_dict.setdefault(item, 0) # 如果user_dict无item这个key,添加{item:0} , 如果有,不管. 而且这个方法性能比第一种方式好
  user_dict[item] += 1 # item的value值累加1

print(user_dict) # {'A': 2, 'B': 1, 'C': 3}

# 第三种方式.使用defaultdict
default_dict = defaultdict(int)
user_list = ['A', 'B', 'C', 'A', 'C', 'C']
for item in user_list:
  default_dict[item] += 1 # 使用这种方式,代码更简单,性能也更好
print(default_dict) # defaultdict(<class 'int'>, {'A': 2, 'B': 1, 'C': 3})
defaultdict基础用法解析
接下来探讨defaultdict的具体用法。
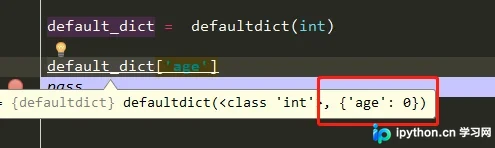
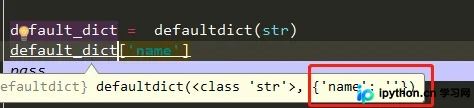
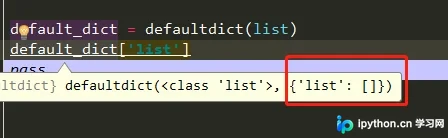
从上述示例可以看出,defaultdict会根据创建实例时传入的参数类型,自动生成对应类型的默认值。
对于dict类型的数据结构而言,这种机制能够有效避免KeyError类型的错误。
自定义默认值工厂函数
此外,我们还可以自定义defaultdict调用对象的数据结构,以满足实际开发中的特定需求。
def person():
  '''自定义一个可调用对象'''
  return {
    'name': '',
    'age': 0
  }
default_dict = defaultdict(person)
default_dict['p']
pass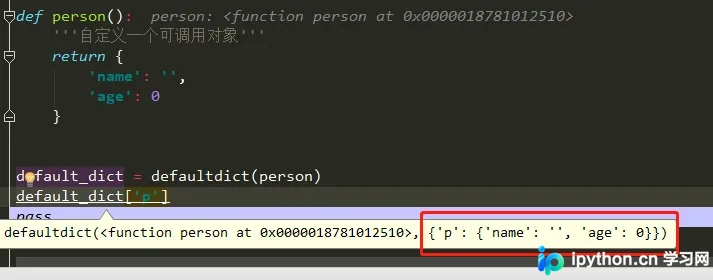
这种实现方式是否非常实用?
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









