

Python实现堆排序算法详解与代码示例

本文详细讲解Python中堆排序算法的实现原理。从最大堆的定义与构建方法入手,分析算法的时间复杂度,并提供基于列表操作的完整Python代码示例。内容涵盖堆节点索引计算、建堆过程及排序逻辑,帮助开发者理解并应用这一高效排序算法。
堆排序概述
堆排序
最大堆的定义与构建
堆是一种完全二叉树结构,即除了最后一层外,其他各层都被完全填充,且所有节点都尽可能向左对齐。在理解堆排序之前,需要掌握最大堆的概念:最大堆是指根节点的值大于或等于其子节点的值,且这一性质对堆中所有根节点均成立。反之,若根节点值小于或等于子节点值,则称为最小堆。
堆排序执行流程
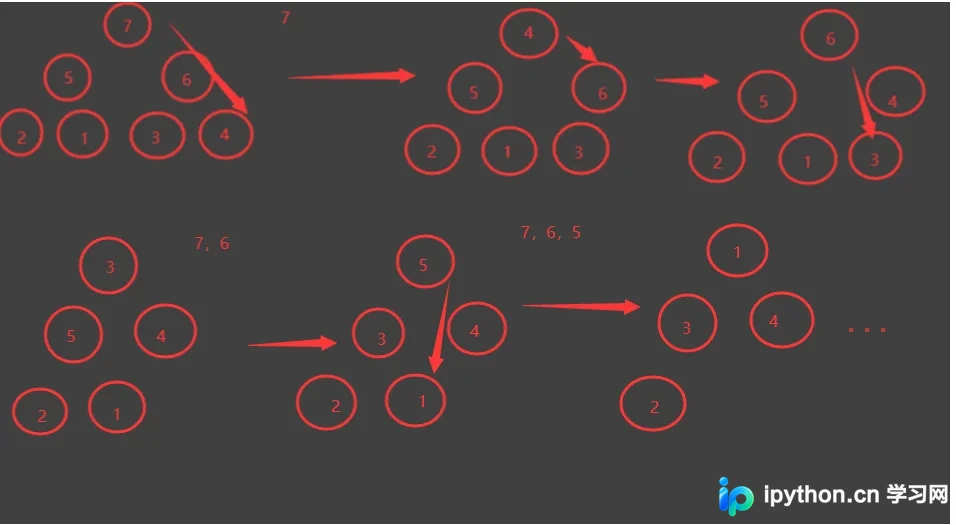
当已构建好最大堆后,排序过程如下:首先提取堆顶元素(最大值7),然后将堆中最后一个元素移至堆顶。此时堆不再满足最大堆性质,需重新调整。通过比较并交换当前堆中的最大元素,使其重新符合最大堆定义(此时最大值为6)。提取6后,再次将最后一个元素移至顶部并调整,重复此过程。最终提取出的数值序列为7, 6, 5, 4, 3, 2, 1。
算法复杂度分析
在维护最大堆的过程中,交换操作的次数决定了算法的复杂度。而交换次数与树的高度密切相关:
h=log2(n+1)
最大堆生成原理
生成最大堆的核心依据是其特性:任意根节点的值必须大于其叶子节点的值。若不满足该条件,则进行节点交换操作。
Python代码实现
以下是具体的代码实现:
from collections import deque


def swap_param(L, i, j):
 # 堆顶与最后元素交换
 L[i], L[j] = L[j], L[i]
 return L

def heap_adjust(L, start, end):
 #构造成大根堆
 temp = L[start]
 i = start
 j = 2 * i
 while j <= end:
 # 判断左右子节点,取两个子节点最大索引
 if (j < end) and (L[j] < L[j + 1]):
  j += 1
 # 判断根节点与子节点比较,如果子节点大于根节点,子节点赋值给根节点
 if temp < L[j]:
  L[i] = L[j]
  i = j
  j = 2 * i
 else:
  break
 # 再把 原来根节点值赋值给子节点上
 L[i] = temp

def heap_sort(L):
 L_length = len(L) - 1

 first_sort_count = L_length // 2
 for i in range(first_sort_count):
 heap_adjust(L, first_sort_count - i, L_length)

 for i in range(L_length - 1):
 L = swap_param(L, 1, L_length - i)
 heap_adjust(L, 1, L_length - i - 1)

 return [L[i] for i in range(1, len(L))]

def main():
 L = deque([50, 16, 30, 10, 60, 90, 2, 80, 70])
 L.appendleft(0)
 print(heap_sort(L))

main()
基础概念扩展
基础知识点扩展:
堆排序
堆
堆栈是计算机中两种最基本的数据结构。堆的特点遵循FIFO(First In First Out,先进先出)原则,从结构上看可理解为树形结构。在堆中,先接收的数据会被先弹出。
堆排序涉及节点的访问与操作定义。
堆节点访问规则
关于堆节点的访问方式,
此处引用Wiki的定义进行说明:
通常,堆通过一维数组来实现。假设阵列起始位置为0,则节点索引关系如下:
- 父节点i的左子节点位于位置(2*i+1);
- 父节点i的右子节点位于位置(2*i+2);
- 子节点i的父节点位于位置floor((i-1)/2);
至此,关于Python实现堆排序的实例讲解已完成。如需了解更多堆排序的Python实现内容,建议搜索本站往期文章或参考下方相关文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









