

Python实现非正太分布的异常值检测方式

针对不符合正态分布的数据,传统西格玛法失效。本文介绍利用Python箱线图进行异常值检测的方法,通过计算下四分位数Q1、中位数Q2和上四分位数Q3,结合四分位距IQR设定上下限(如1.5倍IQR)。通过历史数据建立参考模型,对新数据进行循环判断,输出异常标识,适用于浏览量、交易量等突增猛降场景。
非正态分布异常值检测背景
在实际工作中,数据异常现象频发,例如浏览量或交易量出现剧烈波动。然而,这类数据往往不符合正态分布,此时若采用基于标准差的几倍西格玛法则进行判断并不适用。那么,如何科学地判定这些变化是否处于合理区间呢?
经过查阅相关资料,发现箱形图是解决此类问题的有效工具,其具体原理如下:
箱形图(Box plot),亦称盒须图、盒式图或箱线图,是一种用于展示数据分散情况的统计图表。因其形状类似箱子而得名。箱形图的最大优势在于不受极端异常值的影响,能够稳定且准确地描绘数据的离散分布状态,同时有助于数据清洗工作。
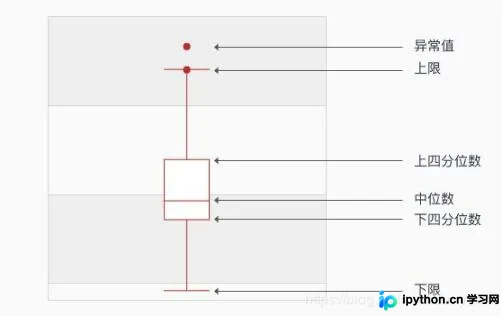
箱线图原理与四分位数计算
关于异常值的判定界限,可以设定为上四分位数的1.25倍,也可以设定为1.5倍,具体倍数需通过实际实验确定。
1、下四分位数Q1的计算
(1)确定四分位数的位置。Qi所在位置=i(n+1)/4,其中i=1,2,3。n表示序列中包含的项数。
(2)根据计算出的位置,求解相应的四分位数数值。
例如:Q1所在的位置=(14+1)/4=3.75,Q1=0.25×第三项+0.75×第四项=0.25×17+0.75×19=18.5;
2、中位数(第二个四分位数)Q2。中位数是指一组数据由小到大排列后处于中间位置的数值。若序列项数为偶数,则中位数为中间两个数的平均值。
例如:Q2所在的位置=2(14+1)/4=7.5,Q2=0.5×第七项+0.5×第八项=0.5×25+0.5×28=26.5
3、上四分位数Q3的计算方法与下四分位数相同。
例如:Q3所在的位置=3(14+1)/4=11.25,Q3=0.75×第十一项+0.25×第十二项=0.75×34+0.25×35=34.25。
4、上限的定义。上限是指非异常范围内的最大值。
首先需要明确四分位距(IQR)的概念及其计算方法:四分位距IQR=Q3-Q1。据此,上限=Q3+1.5IQR。5、下限的定义。下限是指非异常范围内的最小值,计算公式为:下限=Q1-1.5IQR。
上下限设定与Python实现
在本例中,采用上四分位数的1.5倍作为上限,下四分位数的1.5倍作为下限。
具体应用中,选取历史一个月每天的产量和间夜量作为参考数据,统计出历史箱线图的各个指标。随后,将待比较的数据进行循环判断,若数据超过上限或低于下限,则分别抛出1和0作为异常标识。
# -*- coding: utf-8 -*-
"""
Created on Tue Apr 30 10:52:37 2019
@author: chen_lib
"""

import pandas as pd
catering_sale = 'D:/Users/chen_lib/Desktop/ceshi.csv' #读取历史数据
datax = pd.read_csv(catering_sale) #读取数据
#取出不是昨天的数据
data = datax.loc[datax['orderdate'] != datetime][:]
'''
import time
## yyyy-mm-dd格式
print (time.strftime("%Y-%m-%d"))
'''
#时间减一天
import datetime
datetime = (datetime.datetime.now()+datetime.timedelta(days=-1)).strftime("%Y-%m-%d")


#保存基本统计量,将常见的统计信息保存为数据框
statistics = data.describe()
#添加行标签 计算出每个指标的上线下线和四分位间距
statistics.loc['IQR'] = statistics.loc['75%']-statistics.loc['25%'] #四分位数间距
statistics.loc['UP'] = statistics.loc['75%'] + 1.5*statistics.loc['IQR'] #上限
statistics.loc['DAWN'] = statistics.loc['25%'] - 1.5*statistics.loc['IQR']#下限
#取出data的列名
columns = data.columns.values.tolist()


'''取出要比较的数值,放在统计信息表'''
a = data.loc[data['orderdate'] == datetime][columns[1]]#取出第一列
b = data.loc[data['orderdate'] == datetime][columns[2]]#取出第二列
statistics.loc['res'] = [a[1],b[1]]#取出需要比较的当天的数据 放入统计信息中


'''循环取出结果是否满足要求'''
ret = []
for i in range(2):
  res = statistics.loc['res'][i]
  max = statistics.loc['UP'][columns[i+1]]#最大值
  min = statistics.loc['DAWN'][columns[i+1]]#最小值
  '''
  #重建三个值的索引,以便比较大小
  res.index = ['ordernum']
  max.index = max['ordernum']
  min.index = min['ordernum']
  #判断异常值,若大于最大值或者小于最小值则抛出结果为1
  '''
  result1 = res>max
  result2 = res<min
  if result1 =='False' or result2 == 'False':
    ret.append([columns[i+1],1])
  else:
    ret.append([columns[i+1],0])
  df = pd.DataFrame(ret)

	#将文件写入excel表中
df.to_excel("d:/Users/chen_lib/Desktop/ceshi.xlsx",sheet_name="total",index=False,header=False)
以上即为Python实现非正太分布异常值检测的完整方法,希望能为大家提供有价值的参考,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









