

Python数据处理:检测与删除重复观测值的方法

本文介绍在Python数据分析中处理重复观测值的标准流程。通过Pandas库的duplicated()方法结合any()函数快速判断数据是否存在重复,并使用drop_duplicates()函数执行删除操作。文章包含具体代码示例,演示如何从Excel读取数据、检测重复项以及生成去重后的结果集,适用于爬虫数据清洗等场景。
数据清洗中的重复观测问题
在数据处理流程中,数据清洗是不可或缺的一环。这包括检查数据集是否存在重复记录、缺失值、数据的一致性与完整性,以及识别异常值等。针对发现的各类问题,需要采取相应的处理措施。本文将重点讲解数据清洗中常用的重复项处理方法。
重复观测处理
所谓重复观测,是指数据集中存在完全相同的行记录。这些重复数据会干扰数据分析的准确性,进而影响挖掘结果和模型效果。因此,在进行正式的数据分析和建模之前,必须对数据进行重复性检验。
若检验发现存在重复观测,则必须执行删除重复项的操作。
在数据采集阶段,重复观测往往难以避免。例如,通过网络爬虫抓取数据时,极易产生重复条目。以下表格展示了通过爬虫获取的某APP市场中部分电商类APP的下载量数据。
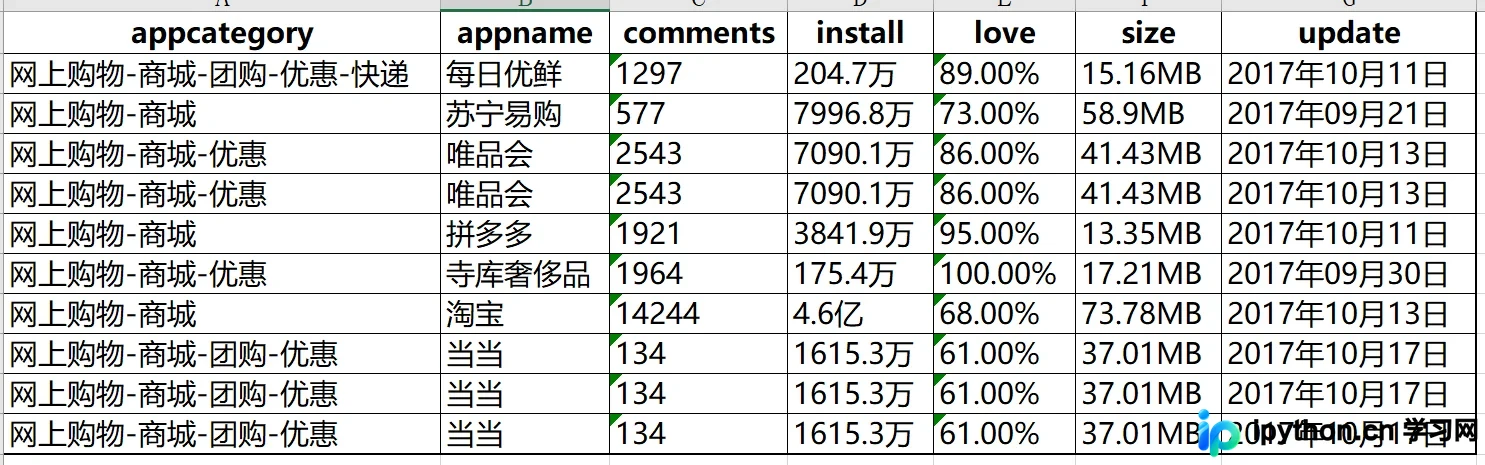
观察该表格可见,唯品会和当当网的数据各出现了三次。如果数据量仅为10行,或许还能通过肉眼识别重复项;但当数据量达到10万行甚至更多时,依靠人工肉眼检测重复项变得完全不现实。
使用Python检测重复观测
接下来,我们将展示如何使用Python来检查数据集中是否存在重复项,以及如何执行删除操作。
具体代码实现如下:
import pandas as pd
df = pd.read_excel(r'D:\data_test04.xlsx')
print('数据集是否存在重复观测: \n',any(df.duplicated()))
运行输出结果如下:
关于数据集是否存在重复观测的判断结果:
True
上述检测逻辑仅需两行代码即可完成。
从结果可以看出,检测数据记录是否重复主要使用duplicated()方法(英文意为重复、复制)。该方法返回的是数据集中每一行的布尔值检测结果。为了获得最直接的总体判断,可以结合any()函数使用。any()函数的逻辑是:只要多个条件中有一个为True,则返回True。正如上述输出所示,any()函数返回True,表明
该数据集中确实存在重复观测记录。
执行重复项删除操作
删除数据集中的重复观测记录:
df.drop_duplicates(inplace = True)
df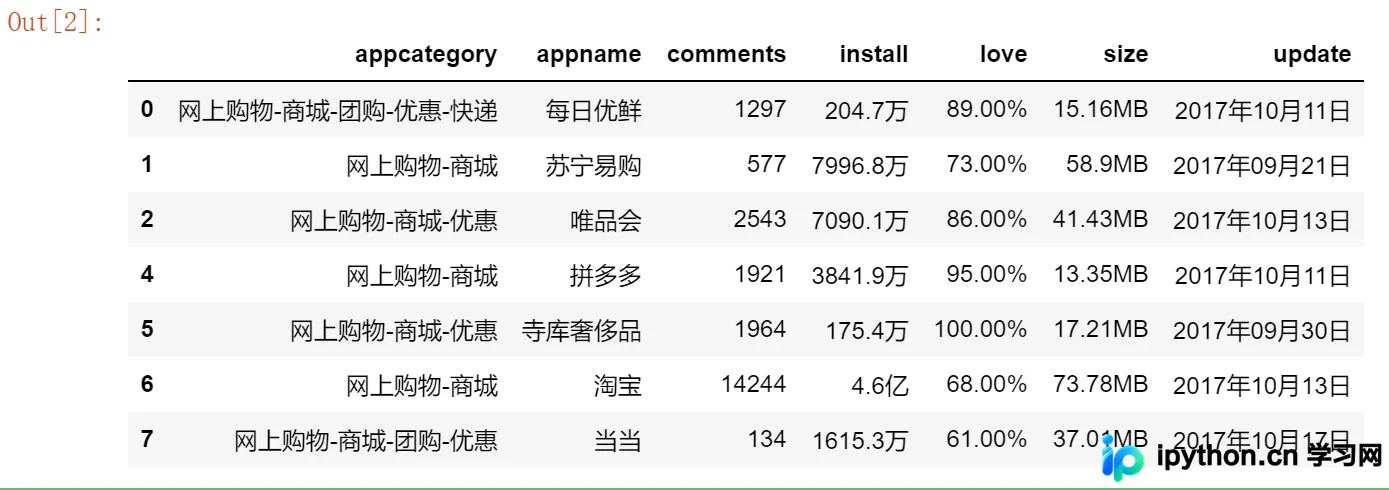
执行去重后的结果如上图所示。原始数据共10行,去除重复项后剩余7行。被删除的行索引号为3、8和9。该方法支持inplace参数,将其设置为True表示直接在原始数据集对象上进行修改,无需重新赋值。
以上即为Python中处理数据重复项的核心知识点,感谢阅读与支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









