

大数据分析师Linux环境教程:安装Hadoop并验证版本与进程状态

准备Linux与Java运行环境:检查依赖并配置环境变量
在部署Hadoop前,必须确保Linux系统已安装兼容的JDK(推荐JDK 8或11)。首先通过终端执行`java -version`与`javac -version`确认Java环境可用。若未安装,可使用`yum install java-1.8.0-openjdk-devel`或`apt install openjdk-8-jdk`进行安装。随后配置环境变量,编辑`~/.bashrc`文件,追加`export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk`、`export HADOOP_HOME=/opt/hadoop-3.3.6`以及`export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin`。保存后执行`source ~/.bashrc`使配置立即生效。最后再次运行`echo $JAVA_HOME`与`hadoop version`验证路径是否正确解析,确保后续Hadoop脚本能准确调用Java运行库。
下载并安装Hadoop:解压程序并完成核心配置
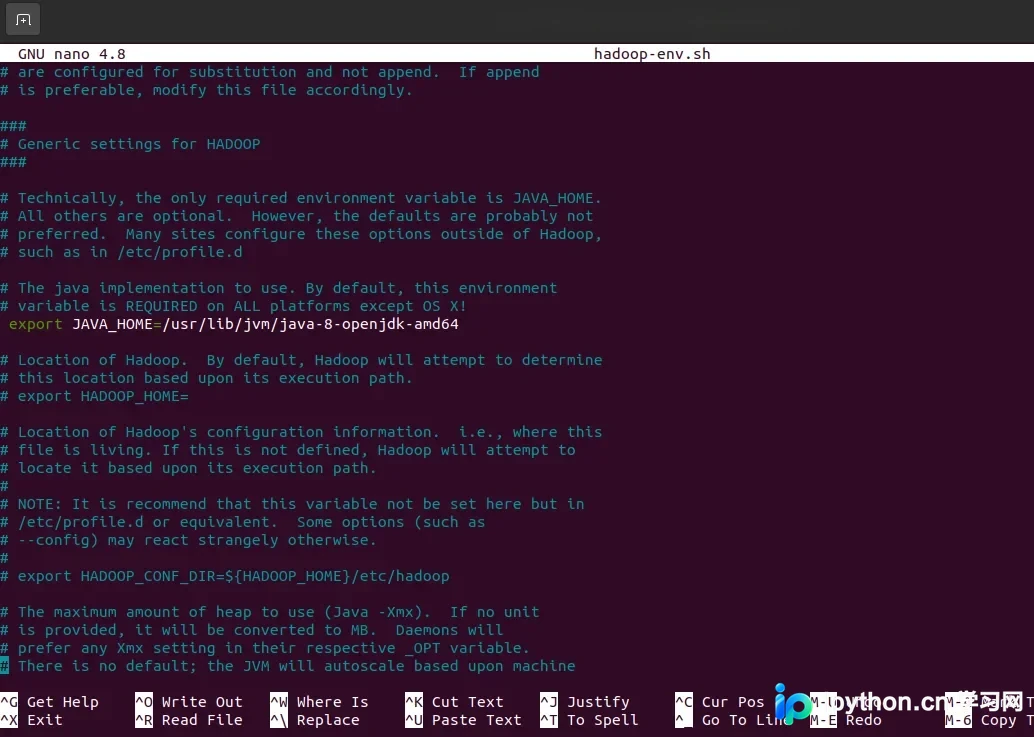
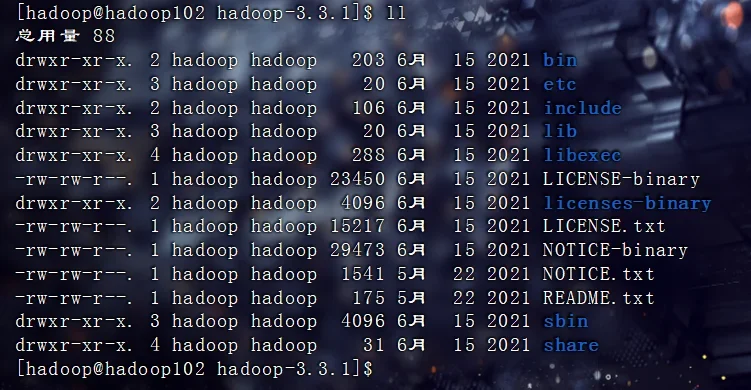
访问Apache Hadoop官网下载稳定版二进制包(如3.3.6),使用`tar -zxvf hadoop-3.3.6.tar.gz -C /opt/`解压至指定目录。进入`$HADOOP_HOME/etc/hadoop/`目录进行核心配置。单节点学习环境通常采用伪分布式模式,即所有守护进程运行在同一台机器但独立JVM中,区别于完全分布式集群。重点修改`hadoop-env.sh`,显式指定`export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk`,避免因系统多版本Java导致路径识别失败。接着配置`core-site.xml`设置`fs.defaultFS`为`hdfs://localhost:9000`,并在`hdfs-site.xml`中设置副本数为1。注意配置文件路径必须严格对应,XML标签闭合错误将直接导致服务启动崩溃。
启动Hadoop并验证版本与进程状态
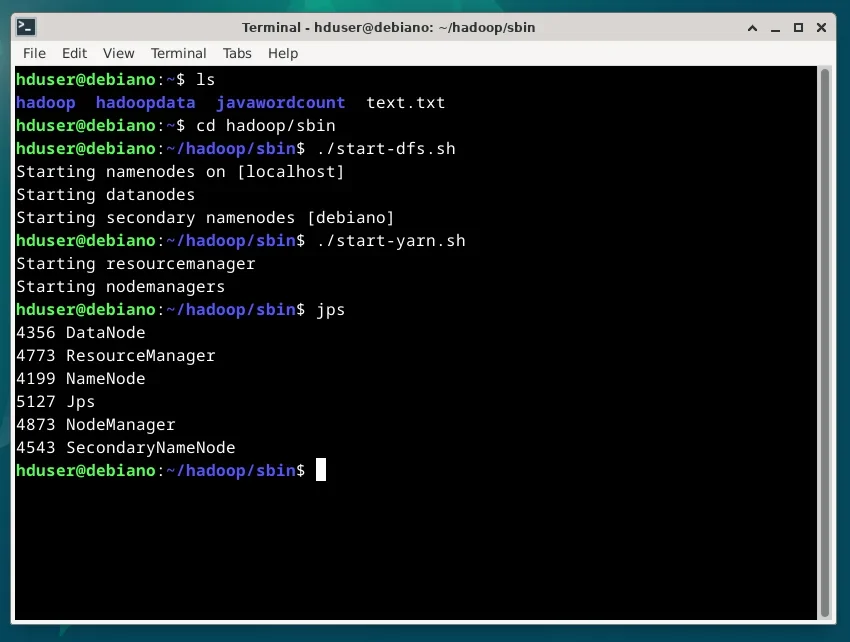
安装配置完成后,首先执行`hadoop version`确认输出包含正确的Hadoop版本、编译信息及Java版本。在首次启动前,必须执行`hdfs namenode -format`对NameNode元数据进行初始化,该操作仅需执行一次,重复格式化会导致集群ID不一致。随后依次运行`start-dfs.sh`与`start-yarn.sh`启动分布式文件系统与资源管理器。启动完毕后,立即使用`jps`命令检查Java进程列表。在伪分布式环境下,正常输出应包含`NameNode`、`DataNode`、`SecondaryNameNode`、`ResourceManager`与`NodeManager`五个核心进程。若全部显示且无报错,说明Hadoop基础环境已成功运行,可通过浏览器访问`http://localhost:9870`与`http://localhost:8088`查看Web UI状态。
排查常见安装问题:从版本异常到进程缺失
Hadoop启动失败多由环境配置遗漏或权限问题引起。若`jps`缺失NameNode或DataNode,首先检查`$HADOOP_HOME/logs/`目录下的对应日志文件(如`hadoop-*-namenode-*.log`),搜索`ERROR`或`Exception`关键字定位根因。常见故障包括:`JAVA_HOME`未正确导出导致脚本中断,需在`hadoop-env.sh`中硬编码绝对路径;SSH免密登录未配置导致`start-dfs.sh`无法远程启动进程,需执行`ssh-keygen -t rsa`并`cat id_rsa.pub >> authorized_keys`;重复格式化NameNode引发`Incompatible clusterIDs`,此时需清空`hdfs-site.xml`中配置的`dfs.namenode.name.dir`与`dfs.datanode.data.dir`目录后重新格式化。通过逐层核对环境变量、日志输出与网络端口,可高效恢复服务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









