

Python3 实现无重复字符的最长子串:从暴力法到滑动窗口优化

本文详细解析如何使用 Python3 求解无重复字符的最长子串问题。首先介绍直观的暴力解法及其超时原因,随后重点阐述基于滑动窗口思想的优化方案。通过维护字符字典和动态调整窗口起始位置,有效避免了重复遍历,显著提升了执行效率,并提供了完整的代码实现与关键细节说明。
题目描述与示例
题目要求:
给定一个字符串,请找出其中不含有重复字符的最长子串的长度。
示例如下:
示例 1: 输入: “abcabcbb” 输出: 3 解释: 因为无重复字符的最长子串是 “abc”,所以其长度为 3。
示例 2: 输入: “bbbbb” 输出: 1 解释: 因为无重复字符的最长子串是 “b”,所以其长度为 1。
示例 3: 输入: “pwwkew” 输出: 3 解释: 因为无重复字符的最长子串是 “wke”,所以其长度为 3。 请注意,你的答案必须是 子串 的长度,“pwke” 是一个子序列,不是子串。
暴力解法思路
解题思路:
面对这道题,最直接的思路是采用暴力解法。即按位递增依次检查子串是否包含重复字符,并记录目前发现的最大子串长度。一旦发现重复,便从下一位索引处的字符开始重新进行检查。具体的代码实现如下:
class Solution:
 def lengthOfLongestSubstring(self, s: str) -> int:
 # 最长子串的长度
 max_len = 0
 # 存放字符的字典
 char_dict = {}
 index = 0
 while s[index:].__len__() >= max_len:
  # 当前最长子串长度
  current_len = 0
  for item in s[index:]:
  old_index = char_dict.get(item)
  if old_index is not None:
   index = old_index + 1
   char_dict.clear()
   break
  char_dict[item] = index
  index += 1
  current_len += 1
  if current_len > max_len:
  max_len = current_len
 return max_len
起初尝试运行该代码,结果却超出了时间限制。虽然代码逻辑看似有些冗长,但核心思路是正确的。我们可以从遍历的角度对算法进行进一步优化。
滑动窗口优化方案
优化策略:
在之前的代码中,当遇到重复字符时,遍历的起始点仅仅往后挪一位。然而,两个重复字符之间的部分实际上是不可能再出现重复的。例如字符串 “fbacdadfeed”,在第一次从 ‘f’ 开始遍历并遇到重复字符(即第二个 ‘a’)时,下一次遍历的起始点不应从 ‘b’ 开始,而应该直接跳转到前一个重复字符的后一个字符,即 ‘c’ 开始。
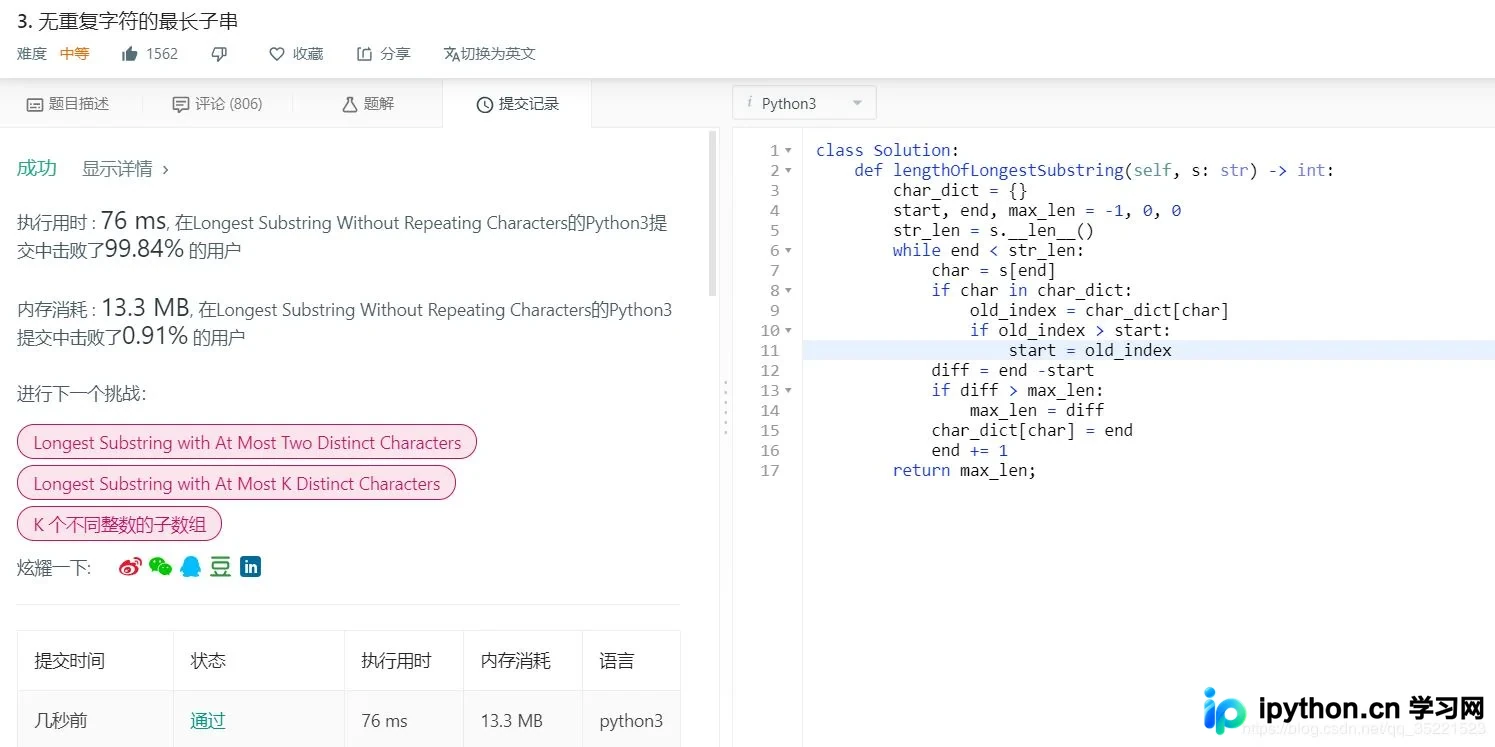
确定上述思想并经过多次优化后的代码如下:
class Solution:
  def lengthOfLongestSubstring(self, s: str) -> int:
    char_dict = {}
    start, end, max_len = -1, 0, 0
    str_len = s.__len__()
    while end < str_len:
      char = s[end]
      if char in char_dict:
        old_index = char_dict[char]
        if old_index > start:
         start = old_index
      diff = end -start
      if diff > max_len:
        max_len = diff
      char_dict[char] = end
      end += 1
    return max_len;
这里使用了内置的 .__len__() 方法来获取字符串长度,而不是使用 len() 函数。此外,代码中使用了多个看似多余的临时变量来存储值,例如 char 和 diff,这些设计旨在节省运行时间,毕竟积少成多。
最终运行结果也是符合预期的:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









