


很多人知道 Generator 能“一个个产出值”,但一到要把多步处理串起来时,代码就容易退回到数组中间变量或一次性展开。更实用的思路,是把每个生成器都写成“接收 iterable、返回新 iterable”的转换节点,这样就能像 Unix 管道一样逐层传递数据,同时保留惰性求值。下面从基础写法、链式组合到异步扩展,梳理出一套可以直接复用的组织方式,也方便判断什么时候该用它、什么时候不该提前把数据吃完。
用 Generator 拆出可组合的数据处理步骤
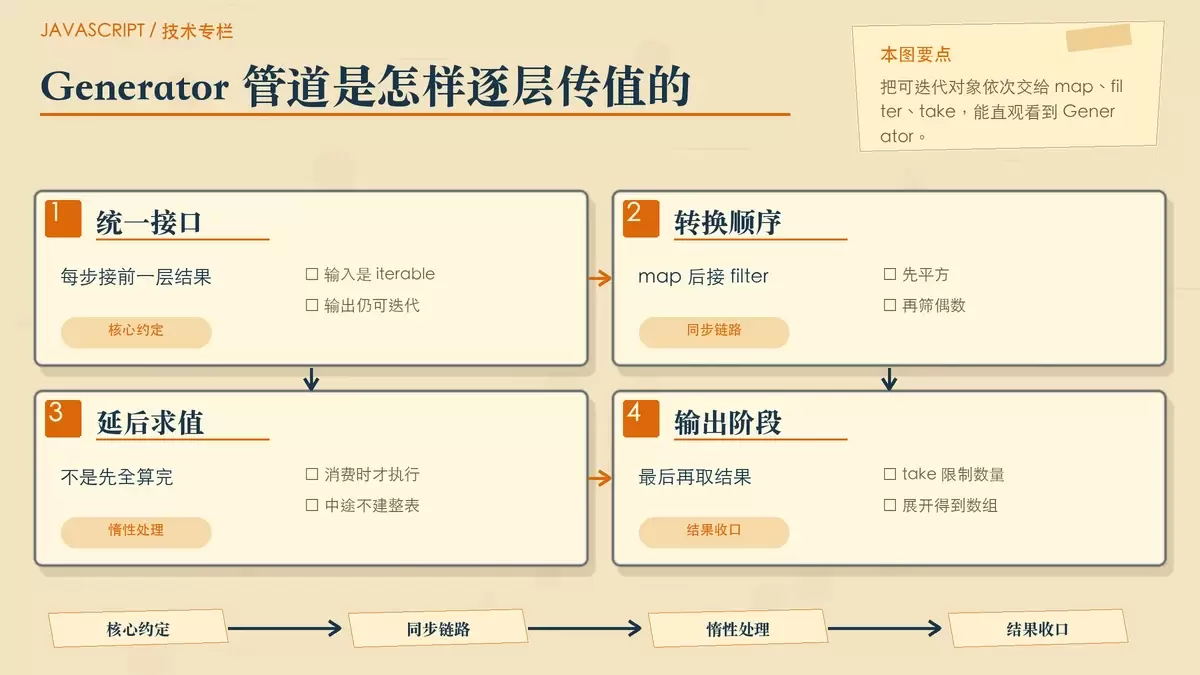
要让 Generator 具备“管道化”能力,前提是每一步都遵守同一个接口:接收一个可迭代对象 source,处理后再把结果 yield 出去。这样,上一个生成器的输出就能直接作为下一个生成器的输入。
像 map、filter、take 这样的常见操作,都可以写成单独的 generator function:
function* map(iterable, fn) {
for (const item of iterable) yield fn(item);
}

function* filter(iterable, predicate) {
for (const item of iterable) if (predicate(item)) yield item;
}

function* take(iterable, n) {
let count = 0;
for (const item of iterable) {
if (count >= n) break;
yield item;
count++;
}
}
这类写法的关键不在“语法用了 Generator”,而在于它们都没有绑定具体数据源。只要输入是任意可迭代对象,步骤之间就能自由拼接。数组可以接,另一个 generator 返回的对象也可以接。
这样做还有一个直接好处:处理过程是惰性的。只有真正消费结果时,前面的每一步才会依次执行,而不是一开始就把所有数据完整算完。
如何把多个生成器串成一条处理管道
generator 函数调用后返回的是一个 Generator 对象,本身就是可迭代对象,因此可以直接嵌套调用,把前一步的返回值交给下一步,形成连续的数据管道。
const numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];

// 管道:取前 5 个 → 过滤偶数 → 平方
const result = [...take(filter(map(numbers, x => x * x), x => x % 2 === 0), 5)];
// → [4, 16, 36, 64, 100]
这段代码本质上就是把多个小步骤叠起来:先平方,再过滤偶数,最后取前 5 个。由于每一步都只处理上游传来的值,因此流程既紧凑,又不会在中途制造多份完整数组。
不过,这种嵌套形式是从右往左读的,类似函数组合 f ∘ g ∘ h。如果团队里有人不习惯这种阅读顺序,可以改成逐步赋值,让数据流更直观:
const squared = map(numbers, x => x * x);
const evens = filter(squared, x => x % 2 === 0);
const firstFive = take(evens, 5);
const result = [...firstFive];
两种写法在行为上没有本质区别,主要差别在可读性。嵌套更紧凑,分步变量更适合调试,也更方便在中间插入日志、统计或额外转换。
涉及异步步骤时,改用 Async Generator
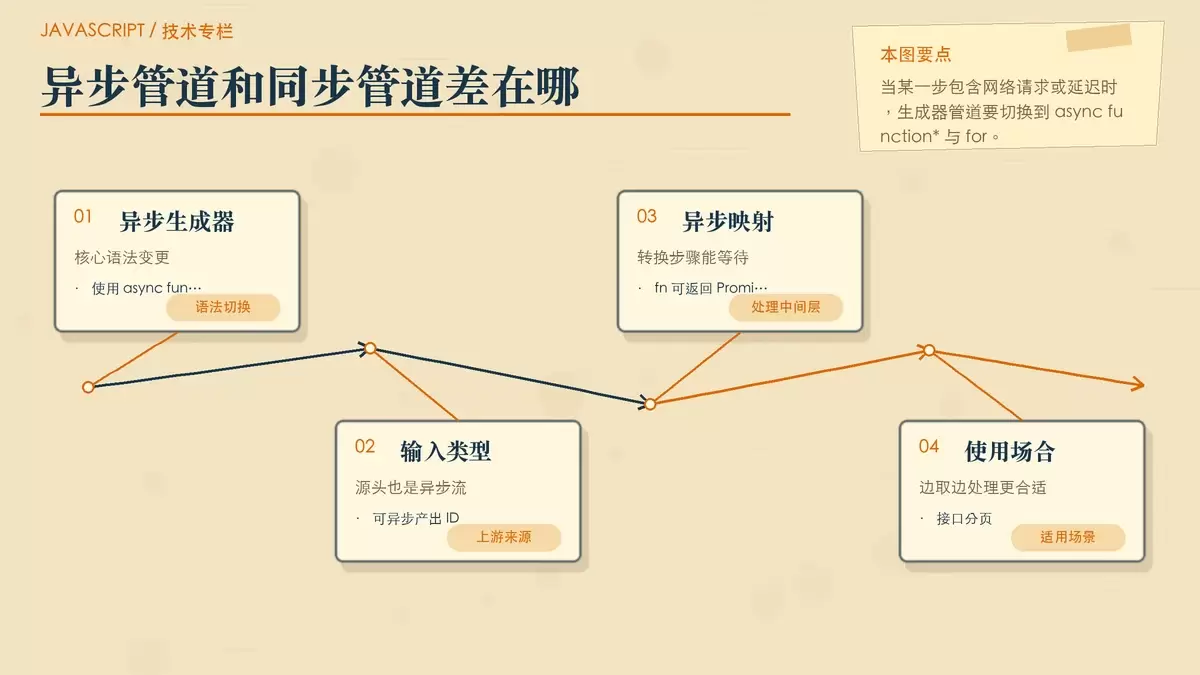
如果某个处理环节不再是同步计算,而是包含 fetch、延迟、数据库访问等异步操作,就需要把整条链条切换到异步可迭代模型。对应做法是使用 async function*,并在消费上游时改用 for await...of。
async function* asyncMap(asyncIterable, fn) {
for await (const item of asyncIterable) {
yield await fn(item);
}
}

// 示例:模拟异步获取用户姓名长度
async function* fetchUserIds() {
yield 1; yield 2; yield 3;
}

async function getUserLength(id) {
await new Promise(r => setTimeout(r, 10)); // 模拟网络延迟
return `user${id}`.length;
}

// 异步管道
const lengths = asyncMap(fetchUserIds(), getUserLength);
// 使用时:for await (const len of lengths) { ... }
这里的思路和同步版完全一致,只是“源头”“中间步骤”“消费方式”都换成了异步版本。只要上游是异步可迭代对象,下游就应该用 for await...of 去接。
这类结构特别适合边拉取、边处理、边输出的场景。比如接口分页数据处理、日志流消费、消息流过滤等,都可以避免先等待全部结果返回,再统一做二次处理。
实用技巧与使用边界
想把这套模式写得稳定,下面几个点很关键:
1. 每一步都要显式接收 iterable
Generator 想要可组合,不能把数据源硬编码在函数内部。只有把 iterable 作为参数传入,步骤之间才是可替换、可复用的。
2. 不要提前把数据整体展开
像 [...iterable] 这种操作会一次性消耗整个数据源,等于主动放弃了惰性求值优势。只要流程还希望保留“按需处理”,就应避免在中途做完整展开。
3. 错误处理通常放在最外层消费侧
如果 generator 内部抛错,异常会沿调用链冒泡到消费位置。实践中更常见的做法,是在最外层的 for...of 或结果展开位置用 try...catch 统一兜底,这样更容易看清是哪条管道在消费时出错。
4. 可以再封一层 pipe(...fns)
当转换步骤越来越多时,可以继续抽象一个 pipe(...fns) 工具,让前一个输出自动交给后一个输入。这样能减少嵌套层级,但前提仍然不变:每个步骤都必须遵守“接收 iterable,返回可迭代结果”的约定。
总的来说,Generator 管道适合处理需要逐步转换、希望保留惰性执行、并且数据天然可流式消费的场景。若你的目标只是对一个很小的数组做一次性处理,直接用数组方法通常更直白;但一旦流程开始变长、数据源开始变大,Generator 的组合方式就会更有组织性。









