

Python实现Solr Collection数据在线迁移方案

本文介绍使用Python脚本将Solr中单个Collection的数据迁移至另一个Collection的方法。通过分段查询(每次1000条)并转换为JSON格式,利用Solr HTTP接口进行批量提交。脚本支持多线程处理以优化性能,并提供了跨网络环境下的离线迁移及数据清除的补充方案。
Solr数据迁移概述
前言
在项目开发过程中,遇到一项需求:需要将在线环境中某个Collection内的数据迁移至另一个Collection。经过搜索发现,多数文章仅介绍导入方法,缺乏在线迁移的具体方案。因此,编写了此Python脚本并分享出来。
核心思路:由于Collection数据量较大,一次性处理所有数据会导致压力过大,因此采用分段执行策略。
具体步骤:首先按每1000条数据的规模进行分段查询,并将结果处理为JSON数据格式。
随后,将处理好的JSON数据发送至目标Collection即可完成迁移。
数据迁移实现步骤
具体实现过程如下:
第一步,通过HTTP接口执行查询操作。
查询请求需遵循以下格式规范:
其中,collection_name代表你要查询的Collection名称。
rows参数指定每次查询的行数,此处设置为1000。
start参数指定查询的起始行号,脚本中将通过控制该参数实现循环查询。
完整的查询URL示例为:http://host:port/solr/collection_name/select?q=*:*&rows=1000&start=0
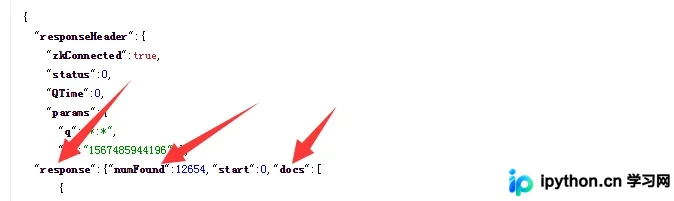
查询处理后,返回的数据格式如图片所示。
在返回的response字段中,我们需要关注两个键值:numFound(表示总数据条数)和docs(包含所有JSON数据)。
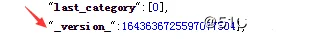
注意,在docs内的每条数据中均包含version键值,该字段需要被移除。
第二步,通过HTTP接口提交数据至目标Collection。
提交时指定wt参数为json格式。
提交数据的URL格式为:http://host:port/solr/collection_name/update?wt=json
请求Header需设置为 {"Content-Type": "application/json"}。
提交参数方面,Solr在索引时若文档已存在则进行替换(此参数也可直接附加在URL中)。
{"overwrite":"true","commit":"true"}
data_dict变量即为我们处理后的docs数据。
提交数据的代码逻辑为:data={"add":{ "doc":data_dict}}。
Python迁移脚本与注意事项
完整的实现脚本如下:
#coding=utf-8
import requests as r
import json
import threading
import time
#发送数据到目的url des_url,data_dict 参数为去掉version键值后的一条字典数据
def send_data(des_url,data_dict):
 data={"add":{ "doc":data_dict}}
 headers = {"Content-Type": "application/json"}
 params = {"boost":1.0,"overwrite":"true","&commitWithin":1000,"commit":"true"}
 url = "%s/update?wt=json"%(des_url)
 re = r.post(url,json = data,params=params,headers=headers)
 if re.status_code != 200:
  print("导入出错",data)

#获取数据,调用send_data 发送数据到目的url
def get_data(des_url,src_url):
  #定义起始行
 start = 0
 #先获取到总的数据条数
 se_data=r.get("%s/select?q=*:*&rows=0&start=%s"%(src_url,start)).text
 se_dict = json.loads(se_data)
 numFound = int(se_dict["response"]["numFound"])
 #while循环,1000条数据为一个循环
 while start < numFound:
  #定义存放多线程的列表
  th_li = []
    #获取1000条数据
  se_data=r.get("%s/select?q=*:*&rows=1000&start=%s"%(src_url,start)).text
    #把获取的数据转换成字典
  se_dict = json.loads(se_data)
    #获取数据里的docs数据
  s_data = (se_dict["response"]["docs"])

  #循环得到的数据,删除 version键值,并使用多线程调用send_data 方法发送数据
  for i in s_data:
   del i["_version_"]
   th = threading.Thread(target=send_data,args=(des_url,i))
   th_li.append(th)

  for t in th_li:
   t.start()
   t.join()

  start += 1000
  print(start)

if __name__ == "__main__":
 #源数据,查询数据的collection地址
 src_url = "http://ip:port/solr/src_connection"
 #导入数据导目的collection 的地址
 des_url = "http://ip:port/solr/des_connection"
 start_time = time.time()
 get_data(des_url,src_url)
 end_time = time.time()
 print("耗时:",end_time-start_time,"秒")
备注说明:
一、若源Collection与目标Collection不在同一网络,无法直接在线传输,可采取以下替代方案:先执行for循环去除version键值,将数据写入文件,然后拷贝至目标网络服务器,再循环读取文件进行上传。写入文件的代码示例如下(具体实现可根据个人喜好调整),但读取后需将每条数据转换为字典格式再行上传。
file = open("solr.json","a+")
for i in s_data:
del i["version"]
file.write(str(i)+"\n")
file.close()
二、数据清除可使用以下方法,经自测较为便捷。
在需要清除数据的Collection界面操作。
选择documents选项。
将document type设置为xml。
将以下内容复制到如图所示位置,最后点击submit document按钮即可执行清除。
#控制web界面删除数据
<delete><query>:</query></delete>
<commit/>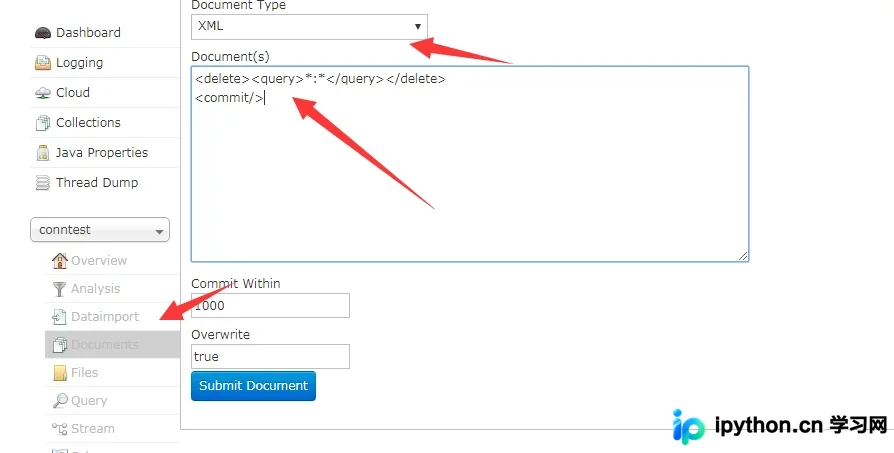
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









