

Python单链表实现详解:从原理到代码实战

本文深入解析线性表结构,对比顺序表与链表的存储差异。重点讲解Python中变量标识与指针机制,并基于类实现单链表、单向循环链表及双向链表的核心功能,包含插入、删除、查找等操作的代码示例与原理说明。
前言
线性表基础:顺序表与链式表
线性表作为最基础且简单的数据结构,其本质是一种一维的数据存储结构。
线性表主要包含两种形式:顺序表和链式表。
- 顺序表采用地址连续的存储单元依次存放数据元素,这种结构被称为线性表的顺序存储或顺序映像。
- 链式表则使用任意存储单元存放数据元素,称为链式存储结构。其存储单元可以是连续的,也可以是不连续的,主要依靠节点间的连接信息(指针)来构建逻辑关系。
*顺序表(非本文重点,仅作简要介绍)
顺序表通过连续存储单元存放数据,查找元素十分便捷。然而,插入和删除操作相对复杂。因为顺序表依赖地址连续性,删除元素后需将后续所有元素向前移动以填补空缺;插入元素时,则需先将该位置后的元素向后移动,腾出空间后再添加新元素。
以C语言为例,顺序表通常通过数组实现,创建数组即分配一块内存。除了静态空间分配,还支持动态扩展。后续操作涉及大量数组元素移动,导致时间复杂度较高。
在Python中,顺序表主要有两种表现形式:
- 一体式结构
- 分离式结构
这里的“一体”与“分离”指的是数据元素集合与维持正确操作所需的元信息(如长度、容量等)是存储在同一块内存空间中,还是分布在相邻的另一块独立空间中。
Python中的tuple和list均采用了顺序表的实现技术。其中,tuple是不可变的,不支持内部元素的修改操作;而list是元素个数可变的线性表,支持添加、删除等操作。list的实现思想与C语言类似,主要是对底层功能进行了封装,体现了list的各项属性特性。
*链式表
Python变量机制与链表指针实现
链表通过“链”连接相邻节点。在C语言中,指针通过地址定位目标对象。因此,链表节点不仅包含数据元素,还需包含指向下一个节点的地址信息。
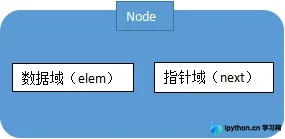
这里涉及指针和地址的概念。在Python中,指针的表现形式有所不同。我们需要先理解Python变量标识的本质,再探讨指针域的实现方式。
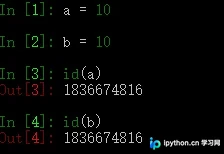
首先观察为何变量a和b的id相同?进一步思考:在Python中交换两个变量的值是如何实现的?
1 a = 10
2 b = 20
3 a,b = b,a
为什么Python支持这种赋值方式?下面通过图示进一步解析。
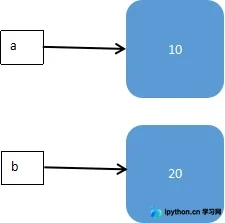
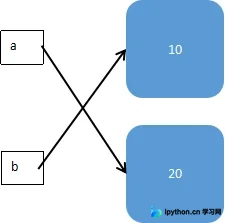
现在是否理解了变量本质上是存储地址的标识?交换变量的值,实质上是修改变量的指向。明确了标识的含义后,链表中的指针域实现变得简单:只需将变量指向下一个节点即可。接下来的内容与常规链表无异,此处阐述旨在厘清Python建立链接的机制。
Python单链表代码实现
一、单链表
接下来通过类来实现一个节点,节点包含数据域和链接域。代码中实现了插入、查找等常用功能。本文重点在于展示单链表在Python中的具体运用。基于已有知识,可以方便地应用链表结构。后续代码不再赘述解释,建议读者仔细研读。如有疑惑欢迎留言,我将尽力详细回复。
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Date  : 2018-06-12 11:23:21
# @Author : yudanqu (943775910@qq.com)
# @Link  : https://www.cnblogs.com/yudanqu/
# @Version : $Id$


class Node(object):
  """节点"""

  def __init__(self, elem):
    self.elem = elem
    self.next = None # 初始设置下一节点为空

'''
上面定义了一个节点的类,当然也可以直接使用python的一些结构。比如通过元组(elem, None)
'''


# 下面创建单链表,并实现其应有的功能


class SingleLinkList(object):
  """单链表"""

  def __init__(self, node=None): # 使用一个默认参数,在传入头结点时则接收,在没有传入时,就默认头结点为空
    self.__head = node

  def is_empty(self):
    '''链表是否为空'''
    return self.__head == None

  def length(self):
    '''链表长度'''
    # cur游标,用来移动遍历节点
    cur = self.__head
    # count记录数量
    count = 0
    while cur != None:
      count += 1
      cur = cur.next
    return count

  def travel(self):
    '''遍历整个列表'''
    cur = self.__head
    while cur != None:
      print(cur.elem, end=' ')
      cur = cur.next
    print("\n")

  def add(self, item):
    '''链表头部添加元素'''
    node = Node(item)
    node.next = self.__head
    self.__head = node

  def append(self, item):
    '''链表尾部添加元素'''
    node = Node(item)
    # 由于特殊情况当链表为空时没有next,所以在前面要做个判断
    if self.is_empty():
      self.__head = node
    else:
      cur = self.__head
      while cur.next != None:
        cur = cur.next
      cur.next = node

  def insert(self, pos, item):
    '''指定位置添加元素'''
    if pos <= 0:
        # 如果pos位置在0或者以前,那么都当做头插法来做
      self.add(item)
    elif pos > self.length() - 1:
      # 如果pos位置比原链表长,那么都当做尾插法来做
      self.append(item)
    else:
      per = self.__head
      count = 0
      while count < pos - 1:
        count += 1
        per = per.next
      # 当循环退出后,pre指向pos-1位置
      node = Node(item)
      node.next = per.next
      per.next = node

  def remove(self, item):
    '''删除节点'''
    cur = self.__head
    pre = None
    while cur != None:
      if cur.elem == item:
        # 先判断该节点是否是头结点
        if cur == self.__head:
          self.__head = cur.next
        else:
          pre.next = cur.next
        break
      else:
        pre = cur
        cur = cur.next

  def search(self, item):
    '''查找节点是否存在'''
    cur = self.__head
    while not cur:
      if cur.elem == item:
        return True
      else:
        cur = cur.next
    return False


if __name__ == "__main__":

    # node = Node(100) # 先创建一个节点传进去

  ll = SingleLinkList()
  print(ll.is_empty())
  print(ll.length())

  ll.append(3)
  ll.add(999)
  ll.insert(-3, 110)
  ll.insert(99, 111)
  print(ll.is_empty())
  print(ll.length())
  ll.travel()
  ll.remove(111)
  ll.travel()
单向循环链表与双向链表解析
二、单向循环链表和双向链表
与单链表相关的还有单向循环链表和双向链表:
单向循环链表:在单链表基础上,增加由尾节点指向首节点的链接。需注意区分“首节点”(第一个存储数据的节点)和“头结点”(仅含链接域、指向首节点的节点,不存储实际数据)。循环链表的某些功能(如判空、判满)与单链表不同,需根据循环特性调整判断逻辑。这些修改可基于前文单链表实现进行尝试。
双向链表:相比单链表,双向链表具备“双向”特性,既可从前往后遍历,也可从后往前遍历。方向由定义决定,一端为正向,另一端为反向。其实现与单链表基本一致。单链表在数据域外增加一个指向后继节点的链接域;双向链表则在此基础上,再增加一个指向前驱节点的链接域。创建链表时,需建立每个节点与前驱及后继节点的连接。
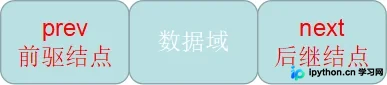
双向链表的插入和删除等操作需格外小心,避免丢失存储的地址信息。务必仔细考虑前后指向关系,明确先链接谁,再链接谁。
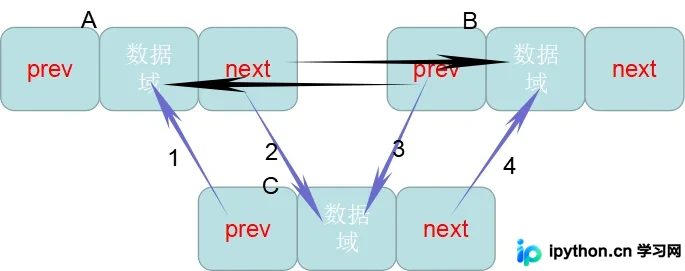
本文初衷仅讨论前述内容,但写作过程中觉得有必要补充后续部分,尽管尚未完全展开。读者可挑选有用部分阅读。
总结
以上为本文全部内容,希望这些内容对您的学习或工作具有参考价值。感谢对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









