

基于Python的泰坦尼克号船票抽样分布分析与实践

本文利用Python对泰坦尼克号乘客数据进行分析,重点探讨船票价格的统计特征及分布形态。通过按登船港口分类,计算年龄与票价的均值、方差等统计量,并运用K-S检验、Shapiro检验等方法验证船票数据是否符合正态、T或卡方分布。研究结果表明船票数据不服从常见标准分布,同时分析了不同港口间票价差的抽样分布特性。
引言与数据说明
本次分析选取泰坦尼克号数据集,使用Python语言进行抽样分布的描述与相关实践操作。
说明:使用的数据集源自泰坦尼克号历史数据,此处仅截取部分样本用于教学演示。主要涉及字段包括:Age(乘客年龄)、Fare(船票价格)以及Embarked(登船港口)。
按港口分类的统计量计算
第一步,按登船港口进行分组,利用Python计算各港口样本中年龄和船票价格的统计量,包括均值、方差、标准差及变异系数等指标。
import pandas as pd
df = pd.read_excel('/Users/Downloads/data.xlsx',usecols = [1,2,3] )
#拿到港口'Embarked'、年龄'Age'、价格'Fare'的数据
df2 = df.groupby(['Embarked'])
#按照港口'Embarked'分类后,查看 年龄、车票价格的统计量。
# 变异系数 = 标准差/平均值
def cv(data):
  return data.std()/data.var()

df2 = df.groupby(['Embarked']).agg(['count','min','max','median','mean','var','std',cv])
df2 = df2.apply(lambda x:round(x,2))
df2_age = df2['Age']
df2_fare = df2['Fare']
分组统计后的年龄与价格描述性统计数据如下图所示:
年龄统计量详情
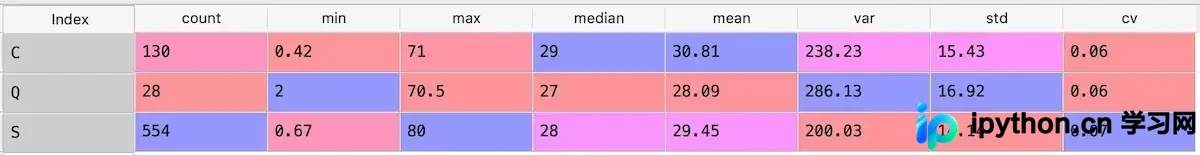
价格统计量详情
船票价格分布形态验证
第二步,绘制船票价格的分布图像,以验证数据具体服从何种概率分布(例如正态分布、卡方分布或T分布)。
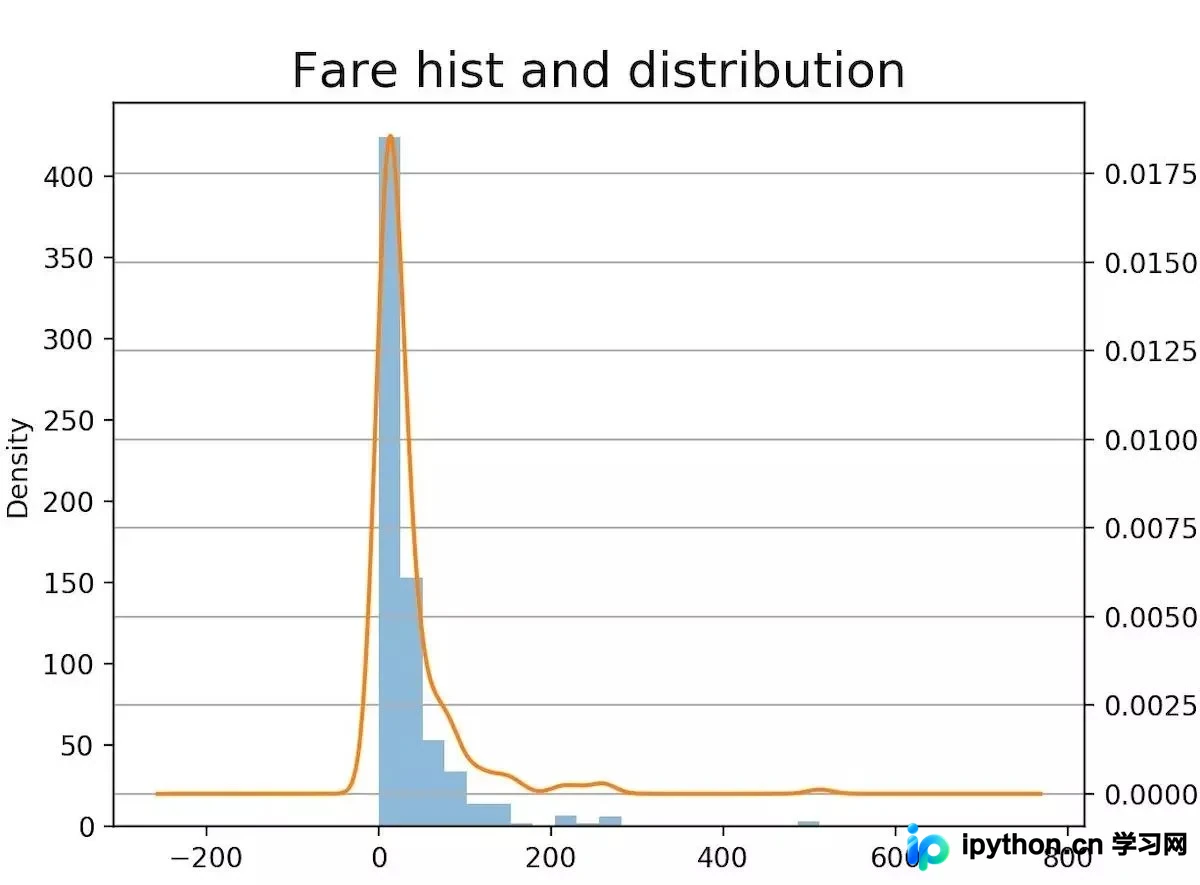
2.1 首先绘制船票价格的直方图:
plt.hist(df['Fare'],20,normed=1, alpha=0.75)
plt.title('Fare')
plt.grid(True)
船票价格直方图及其概率分布情况
2.2 接下来验证数据是否符合正态分布假设:
#分别用kstest、shapiro、normaltest来验证分布系数
ks_test = kstest(df['Fare'], 'norm')
#KstestResult(statistic=0.99013849978633, pvalue=0.0)

shapiro_test = shapiro(df['Fare'])
#shapiroResult(0.5256513357162476, 7.001769945799311e-40)

normaltest_test = normaltest(df['Fare'],axis=0)
#NormaltestResult(statistic=715.0752414548335, pvalue=5.289130045259168e-156)
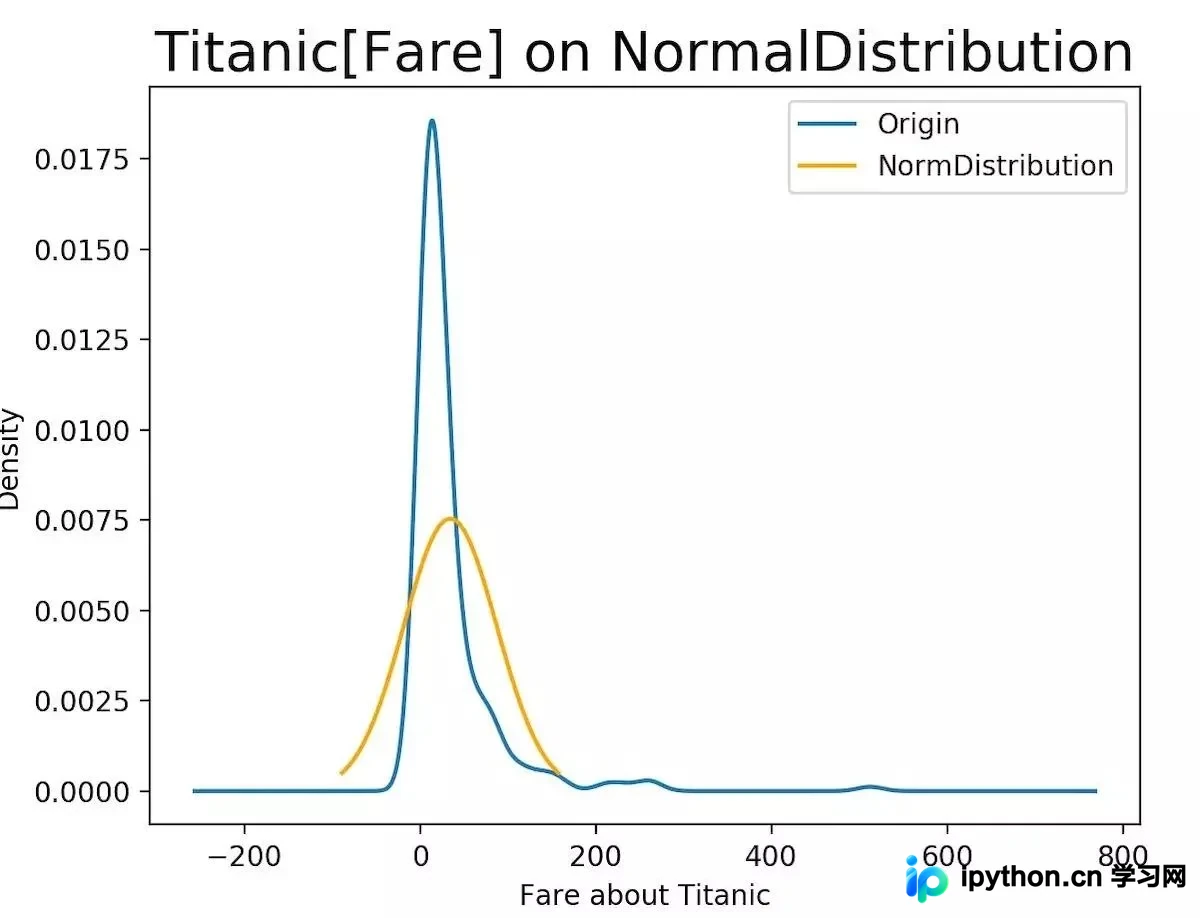
上述三种统计检验的结果均显示 p值小于5%,因此可以判定船票数据不符合正态分布。
随后绘制拟合的正态分布曲线进行对比:
fare = df['Fare']

plt.figure()
fare.plot(kind = 'kde')   #原始数据的正态分布

M_S = stats.norm.fit(fare)  #正态分布拟合的平均值loc,标准差 scale
normalDistribution = stats.norm(M_S[0], M_S[1])  # 绘制拟合的正态分布图
x = np.linspace(normalDistribution.ppf(0.01), normalDistribution.ppf(0.99), 100)
plt.plot(x, normalDistribution.pdf(x), c='orange')
plt.xlabel('Fare about Titanic')
plt.title('Titanic[Fare] on NormalDistribution', size=20)
plt.legend(['Origin', 'NormDistribution'])
船票数据拟合正态分布曲线展示
2.3 进一步验证数据是否符合T分布:
T_S = stats.t.fit(fare)
df = T_S[0]
loc = T_S[1]
scale = T_S[2]
x2 = stats.t.rvs(df=df, loc=loc, scale=scale, size=len(fare))
D, p = stats.ks_2samp(fare, x2) # (0.25842696629213485 2.6844476044528504e-21)
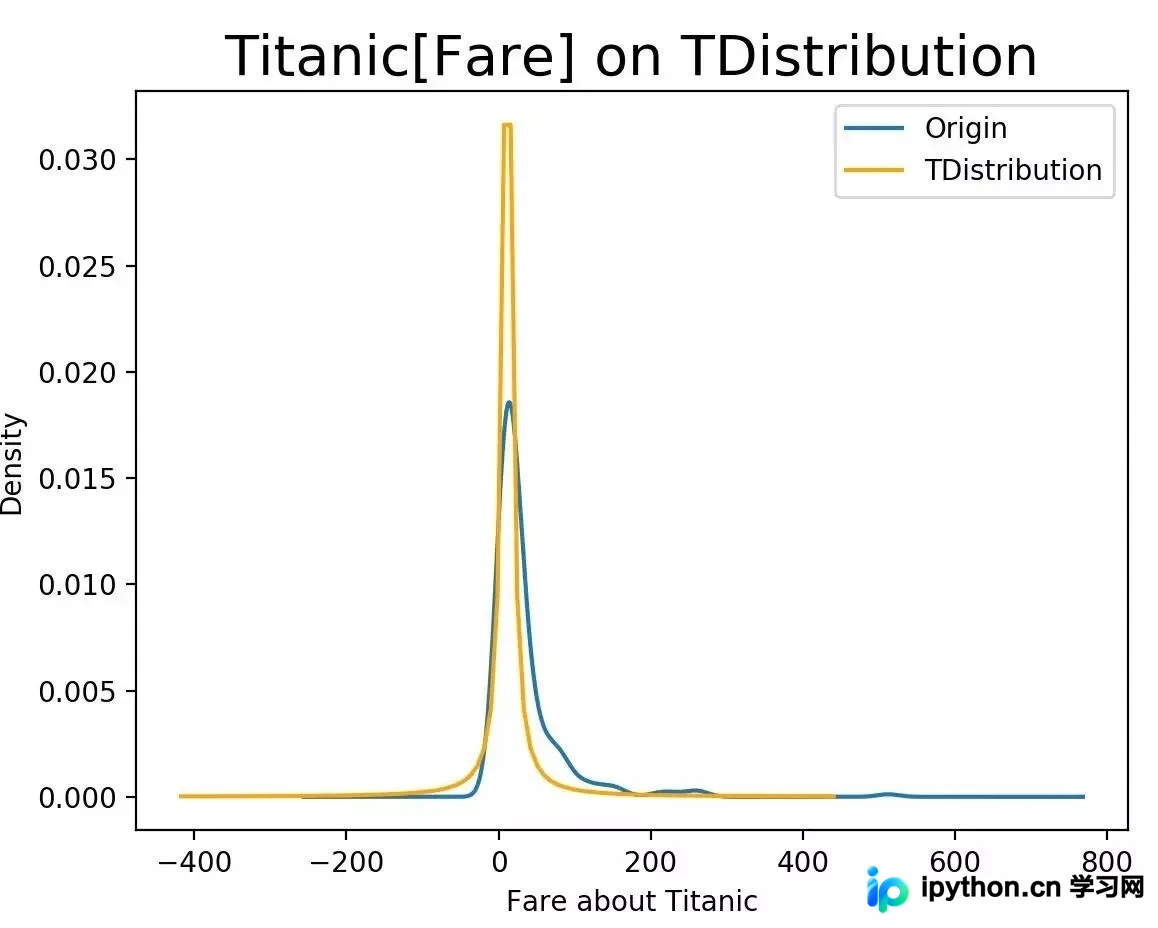
计算得到 p = 2.6844476044528504e-21,由于 p < alpha,故拒绝原假设,结论为价格数据不符合T分布。
对票价数据进行T分布拟合处理:
plt.figure()
fare.plot(kind = 'kde')
TDistribution = stats.t(T_S[0], T_S[1],T_S[2])  # 绘制拟合的T分布图
x = np.linspace(TDistribution.ppf(0.01), TDistribution.ppf(0.99), 100)
plt.plot(x, TDistribution.pdf(x), c='orange')
plt.xlabel('Fare about Titanic')
plt.title('Titanic[Fare] on TDistribution', size=20)
plt.legend(['Origin', 'TDistribution'])
票价数据拟合T分布结果图
2.4 最后验证数据是否符合卡方分布:
chi_S = stats.chi2.fit(fare)
df_chi = chi_S[0]
loc_chi = chi_S[1]
scale_chi = chi_S[2]
x2 = stats.chi2.rvs(df=df_chi, loc=loc_chi, scale=scale_chi, size=len(fare))
Df, pf = stats.ks_2samp(fare, x2) # (0.16292134831460675, 1.154755913291936e-08)
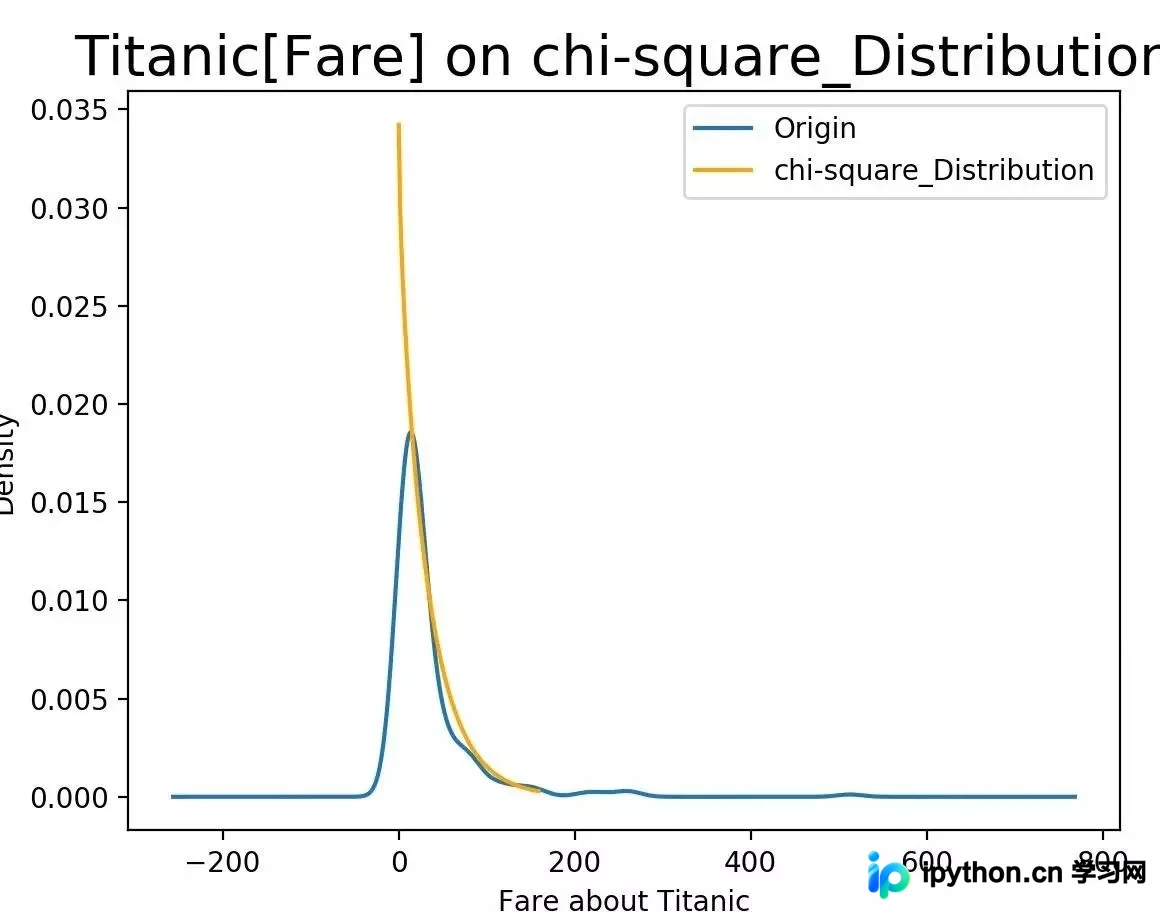
计算得到 p = 1.154755913291936e-08,同样满足 p < alpha,拒绝原假设,结论为价格数据不符合卡方分布。
对票价数据进行卡方分布拟合:
plt.figure()
fare.plot(kind = 'kde')
chiDistribution = stats.chi2(chi_S[0], chi_S[1],chi_S[2])  # 绘制拟合的正态分布图
x = np.linspace(chiDistribution.ppf(0.01), chiDistribution.ppf(0.99), 100)
plt.plot(x, chiDistribution.pdf(x), c='orange')
plt.xlabel('Fare about Titanic')
plt.title('Titanic[Fare] on chi-square_Distribution', size=20)
plt.legend(['Origin', 'chi-square_Distribution'])
票价数据拟合卡方分布结果图
港口间价格差的抽样分布分析
第三步,按港口分类后,验证S港口与Q港口两个港口间的价格之差是否服从某种特定分布。
S_fare = df[df['Embarked'] =='S']['Fare']
Q_fare = df[df['Embarked'] =='Q']['Fare']
C_fare = df[df['Embarked'] =='C']['Fare']
S_fare.describe()
count  554.000000
mean   27.476284
std    36.546362
min    0.000000
25%    8.050000
50%    13.000000
75%    27.862500
max   263.000000
Q_fare.describe()
count  28.000000
mean   18.265775
std   21.843582
min    6.750000
25%    7.750000
50%    7.750000
75%   18.906250
max   90.000000
C_fare.describe()
count  130.000000
mean   68.296767
std    90.557822
min    4.012500
25%    14.454200
50%    36.252100
75%    81.428100
max   512.329200
按港口分类后的样本数量统计如下:S港口样本数不超过554,Q港口样本数不超过28,C港口样本数不超过130。
由于总体数据不服从正态分布,根据中心极限定理,当样本量n较大(通常要求n≥30)时,两个样本均值之差的抽样分布可近似为正态分布。然而,Q港口的总体容量仅为28,其样本容量不可能超过30,因此S港口和Q港口两个样本均值之差(E(X1)-E(X2))的抽样分布不服从正态分布。
相比之下,S港口和C港口的两个样本均值之差(E(X1)-E(X3))的抽样分布近似服从正态分布。其均值和方差分别为 E(E(X1) - E(X3)) = E(E(X1)) - E(E(X3)) = μ1 - μ3;D(E(X1) + E(X3)) = D(E(X1)) + D(E(X3)) = σ1²/n1 + σ3²/n3。具体绘图如下所示:
miu = np.mean(S_fare) - np.mean(C_fare)
sig = np.sqrt(np.var(S_fare, ddof=1)/len(S_fare) + np.var(C_fare, ddof=1)/len(C_fare))

x = np.arange(- 110, 50)
y = stats.norm.pdf(x, miu, sig)
plt.plot(x, y)
plt.xlabel("S_Fare - C_Fare")
plt.ylabel("Density")
plt.title('Fare difference between S and C')
plt.show()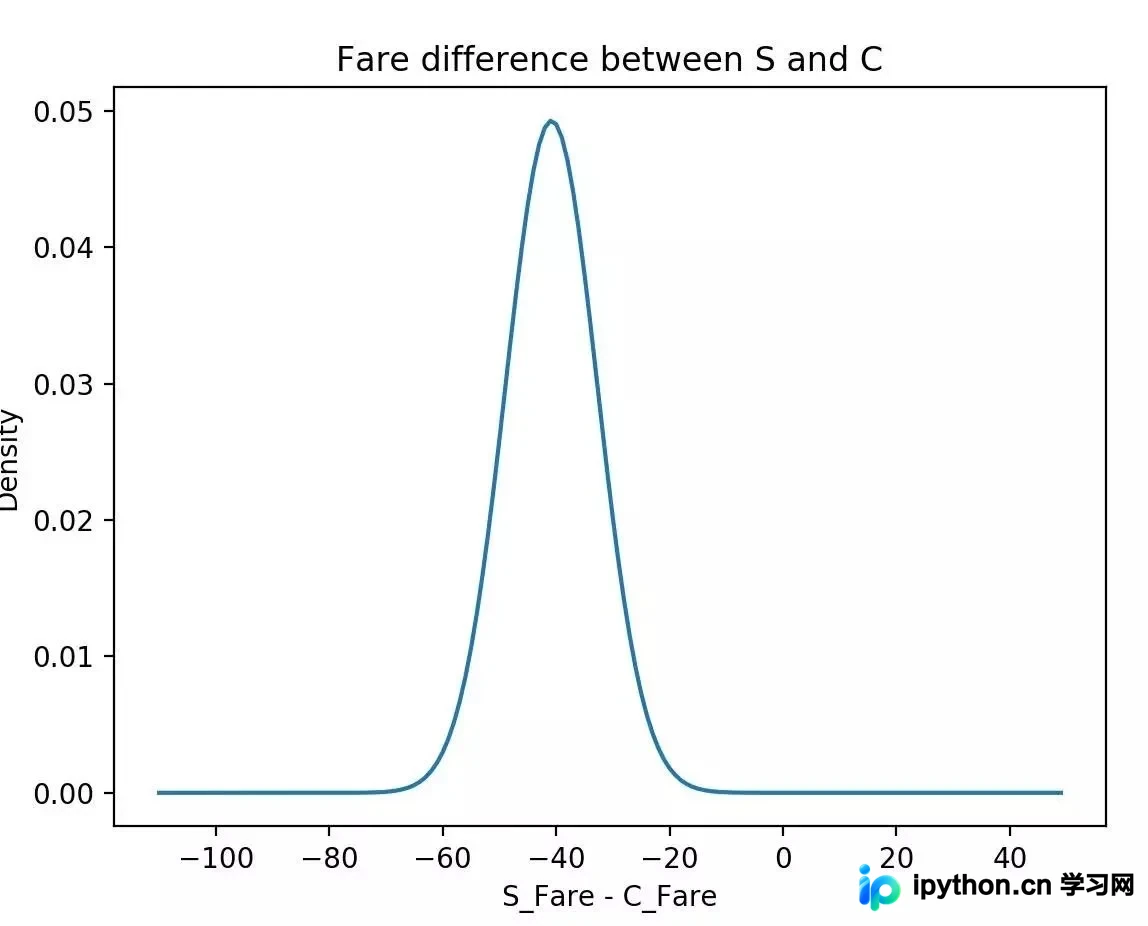
以上即为本文的全部内容,希望对读者的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









