

Python K-Means聚类算法原理与实战详解

本文深入解析Python中K-Means聚类算法的核心原理。从无监督学习的概念入手,详细阐述如何通过随机初始化质心、计算欧式距离及迭代更新中心点来划分数据簇。同时介绍利用误差平方和确定最佳K值的方法,并提供完整的Python代码实现与不同K值下的可视化结果对比,帮助读者掌握聚类分析的关键技术。
K-Means算法概述
一、概述
首先需要介绍无监督学习的概念。所谓无监督学习,是指训练样本中没有标记信息,其目标是通过学习无标记的训练样本来揭示数据的内在性质及规律。通俗地说,就是根据数据的内在性质,挖掘其隐含的规律。在这一类算法中,应用最为广泛的是“聚类”算法。
聚类算法的主要作用包括数据归约,即在尽可能保证数据完整性的前提下减少数据量级,以便后续处理;此外,也可以直接对聚类结果进行应用或分析。
K-Means算法是聚类算法中较为基础且常见的一种。
K-Means算法原理示例
二、从样例开始
假设我们在二维平面上有一组数据点。
   x         y
1.658985    4.285136
-3.453687    3.424321
4.838138    -1.151539
-5.379713    -3.362104
0.972564    2.924086
-3.567919    1.531611
0.450614    -3.302219
-3.487105    -1.724432
2.668759    1.594842
-3.156485    3.191137
3.165506    -3.999838
-2.786837    -3.099354
4.208187    2.984927
-2.123337    2.943366
0.704199    -0.479481
-0.392370    -3.963704
2.831667    1.574018
-0.790153    3.343144
2.943496    -3.357075
...
这些点在二维平面上的分布大致如下:
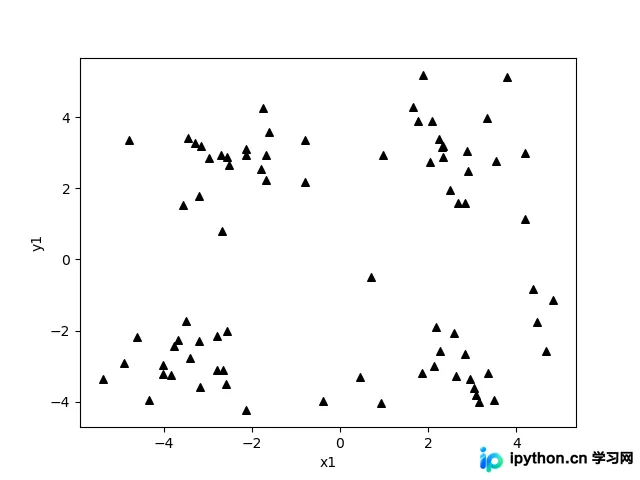
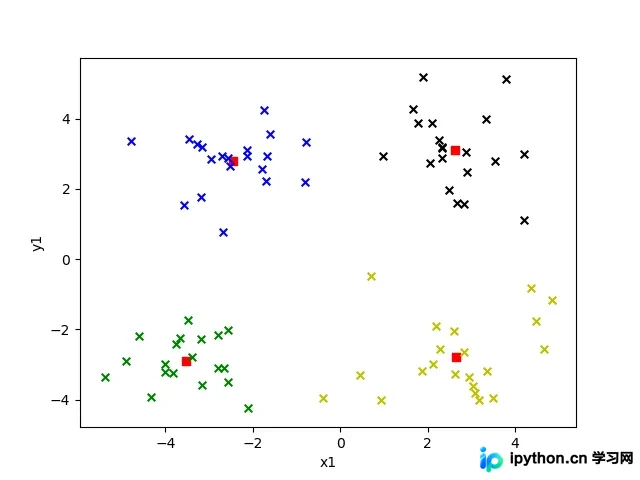
观察这些点,可以隐约看出它们分成了4个“簇”。因此,我们可以假定目标是将数据分成4个簇(尽管实际上也可能分为其他数量,如5个)。这里的“4个簇”是基于视觉判断得出的,而在实际应用中,这一数值应由算法计算得出,下文将详细介绍。
确定4个“簇”后,下一步是找出每个簇的中心。虽然人类可以“看出”大概的中心位置,但计算机无法直接感知。计算机通过向量距离(即向量相似性)来确定中心。相似性的计算方法有多种,例如欧氏距离、曼哈顿距离、切比雪夫距离等。
本文采用欧氏距离,它反映的是空间中两点之间的直线距离。
基于上述原理,我们可以让计算机计算出4个“簇”。
主要步骤如下:首先随机生成4个点,假设这4个点即为4个簇的中心。接着计算平面中每个点到这4个中心点的距离,并将每个点分配给距离最近的那个中心点。
此时,我们完成了第一步,即将平面中的所有点分成了4个簇。然而,由于初始中心点是随机生成的,这样划分出的4个簇显然不是最优结果。解决方法如下:
现有4个簇,根据每个簇中所有点的坐标计算出每个簇的新中心点。这个新中心点比旧的初始中心点更优,因为它更接近簇内所有点的几何中心。随后,使用新中心点重复第一步的操作,即重新计算所有点到新中心点的距离,并将点重新分配到4个新簇中。通过不断迭代,直到误差收敛到较小范围。
以上就是K-Means算法的基本流程。
关键知识点解析
三、知识点浅析
3.1 确定“簇”的个数
前文提到的分成4个簇,其中的“4”即为K-Means算法中的参数K。使用K-Means算法时,首先必须选择一个K值作为聚类的簇数。在上例中,K=4是我们主观“看”出来的,但在多数实际场景中,我们无法直观判断应该分为多少个簇。那么该如何确定呢?
我们可以从较小的K值开始尝试。使用简单的K-Means算法(即较少迭代次数,不追求最佳结果,只求快速)计算结果。然后计算每个点到其所属簇中心点的距离,并求和,该总和即为误差值。
接着增加K值,再次计算误差值。例如在上例中,我们可以从K=2开始,计算K值从2到7的K-Means算法误差值。 这样会得到类似如下的图表:
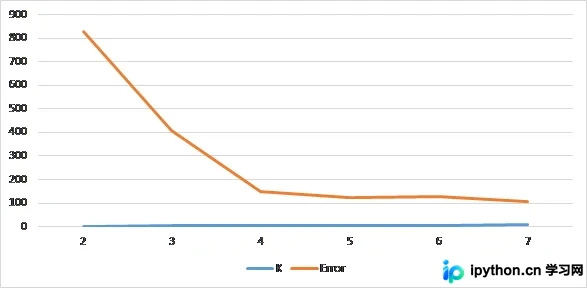
图中的“Error”代表K-Means的误差。当分成的“簇”越多时,误差通常会越来越小。
但是,“簇”越多越好吗?答案是否定的。有时“簇”过多反而不利于得到预期结果或进行后续操作。
因此,我们通常选择误差减小速度变得平缓的那个临界点,例如上图中的4。
可以发现,在分成4个簇之后,再增加簇的数量,误差并没有显著减少。而取4个簇也与我们的视觉观察相符。
3.2 欧氏距离
欧氏距离是常用的距离定义,指在m维空间中两个点之间的真实距离,计算公式如下:
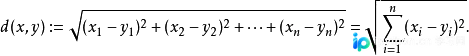
而本例是在二维空间中,因此本例的计算公式简化为:
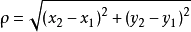
Python代码实现与结果分析
四、代码和结果
加载数据的代码使用了numpy库,先将数据加载为matrix类型。
import numpy as np

def loadDataSet(fileName):
  '''
  加载数据集
  :param fileName:
  :return:
  '''
  # 初始化一个空列表
  dataSet = []
  # 读取文件
  fr = open(fileName)
  # 循环遍历文件所有行
  for line in fr.readlines():
    # 切割每一行的数据
    curLine = line.strip().split('\t')
    # 将数据转换为浮点类型,便于后面的计算
    # fltLine = [float(x) for x in curLine]
    # 将数据追加到dataMat
    fltLine = list(map(float,curLine))  # 映射所有的元素为 float(浮点数)类型
    dataSet.append(fltLine)
  # 返回dataMat
  return np.matrix(dataSet)
接下来需要生成K个初始质点(即中心点)。这里采用随机生成的方法生成K个“簇”的初始中心。
def randCent(dataMat, k):
  '''
  为给定数据集构建一个包含K个随机质心的集合,
  随机质心必须要在整个数据集的边界之内,这可以通过找到数据集每一维的最小和最大值来完成
  然后生成0到1.0之间的随机数并通过取值范围和最小值,以便确保随机点在数据的边界之内
  :param dataMat:
  :param k:
  :return:
  '''
  # 获取样本数与特征值
  m, n = np.shape(dataMat)
  # 初始化质心,创建(k,n)个以零填充的矩阵
  centroids = np.mat(np.zeros((k, n)))
  # 循环遍历特征值
  for j in range(n):
    # 计算每一列的最小值
    minJ = min(dataMat[:, j])
    # 计算每一列的范围值
    rangeJ = float(max(dataMat[:, j]) - minJ)
    # 计算每一列的质心,并将值赋给centroids
    centroids[:, j] = np.mat(minJ + rangeJ * np.random.rand(k, 1))
  # 返回质心
  return centroids
欧氏距离计算函数。
def distEclud(vecA, vecB):
  '''
  欧氏距离计算函数
  :param vecA:
  :param vecB:
  :return:
  '''
  return np.sqrt(sum(np.power(vecA - vecB, 2)))
cost方法执行一个简化的K-Means,即较少次数的迭代,计算出其中的误差(即当前点到簇质心的距离,后续将使用该误差来评价聚类效果)。
def cost(dataMat, k, distMeas=distEclud, createCent=randCent,iterNum=300):
  '''
  计算误差的多少,通过这个方法来确定 k 为多少比较合适,这个其实就是一个简化版的 kMeans
  :param dataMat: 数据集
  :param k: 簇的数目
  :param distMeans: 计算距离
  :param createCent: 创建初始质心
  :param iterNum:默认迭代次数
  :return:
  '''
  # 获取样本数和特征数
  m, n = np.shape(dataMat)
  # 初始化一个矩阵来存储每个点的簇分配结果
  # clusterAssment包含两个列:一列记录簇索引值,第二列存储误差(误差是指当前点到簇质心的距离,后面会使用该误差来评价聚类的效果)
  clusterAssment = np.mat(np.zeros((m, 2)))
  # 创建质心,随机K个质心
  centroids = createCent(dataMat, k)
  clusterChanged = True
  while iterNum > 0:
    clusterChanged = False
    # 遍历所有数据找到距离每个点最近的质心,
    # 可以通过对每个点遍历所有质心并计算点到每个质心的距离来完成
    for i in range(m):
      minDist = np.inf
      minIndex = -1
      for j in range(k):
        # 计算数据点到质心的距离
        # 计算距离是使用distMeas参数给出的距离公式,默认距离函数是distEclud
        distJI = distMeas(centroids[j, :], dataMat[i, :])
        # print(distJI)
        # 如果距离比minDist(最小距离)还小,更新minDist(最小距离)和最小质心的index(索引)
        if distJI < minDist:
          minDist = distJI
          minIndex = j
      # 更新簇分配结果为最小质心的index(索引),minDist(最小距离)的平方
      clusterAssment[i, :] = minIndex, minDist ** 2
      iterNum -= 1;
    # print(centroids)
    # 遍历所有质心并更新它们的取值
    for cent in range(k):
      # 通过数据过滤来获得给定簇的所有点
      ptsInClust = dataMat[np.nonzero(clusterAssment[:, 0].A == cent)[0]]
      # 计算所有点的均值,axis=0表示沿矩阵的列方向进行均值计算
      centroids[cent, :] = np.mean(ptsInClust, axis=0)
  # 返回给定迭代次数后误差的值
  return np.mat(clusterAssment[:,1].sum(0))[0,0]
最后可以调用K-Means算法进行正式计算。
def kMeans(dataMat, k, distMeas=distEclud, createCent=randCent):
  '''
  创建K个质心,然后将每个店分配到最近的质心,再重新计算质心。
  这个过程重复数次,直到数据点的簇分配结果不再改变为止
  :param dataMat: 数据集
  :param k: 簇的数目
  :param distMeans: 计算距离
  :param createCent: 创建初始质心
  :return:
  '''
  # 获取样本数和特征数
  m, n = np.shape(dataMat)
  # 初始化一个矩阵来存储每个点的簇分配结果
  # clusterAssment包含两个列:一列记录簇索引值,第二列存储误差(误差是指当前点到簇质心的距离,后面会使用该误差来评价聚类的效果)
  clusterAssment = np.mat(np.zeros((m, 2)))
  # 创建质心,随机K个质心
  centroids = createCent(dataMat, k)
  # 初始化标志变量,用于判断迭代是否继续,如果True,则继续迭代
  clusterChanged = True
  while clusterChanged:
    clusterChanged = False
    # 遍历所有数据找到距离每个点最近的质心,
    # 可以通过对每个点遍历所有质心并计算点到每个质心的距离来完成
    for i in range(m):
      minDist = np.inf
      minIndex = -1
      for j in range(k):
        # 计算数据点到质心的距离
        # 计算距离是使用distMeas参数给出的距离公式,默认距离函数是distEclud
        distJI = distMeas(centroids[j, :], dataMat[i, :])
        # 如果距离比minDist(最小距离)还小,更新minDist(最小距离)和最小质心的index(索引)
        if distJI < minDist:
          minDist = distJI
          minIndex = j
      # 如果任一点的簇分配结果发生改变,则更新clusterChanged标志
      if clusterAssment[i, 0] != minIndex: clusterChanged = True
      # 更新簇分配结果为最小质心的index(索引),minDist(最小距离)的平方
      clusterAssment[i, :] = minIndex, minDist ** 2
    # print(centroids)
    # 遍历所有质心并更新它们的取值
    for cent in range(k):
      # 通过数据过滤来获得给定簇的所有点
      ptsInClust = dataMat[np.nonzero(clusterAssment[:, 0].A == cent)[0]]
      # 计算所有点的均值,axis=0表示沿矩阵的列方向进行均值计算
      centroids[cent, :] = np.mean(ptsInClust, axis=0)
  # 返回所有的类质心与点分配结果
  return centroids, clusterAssment
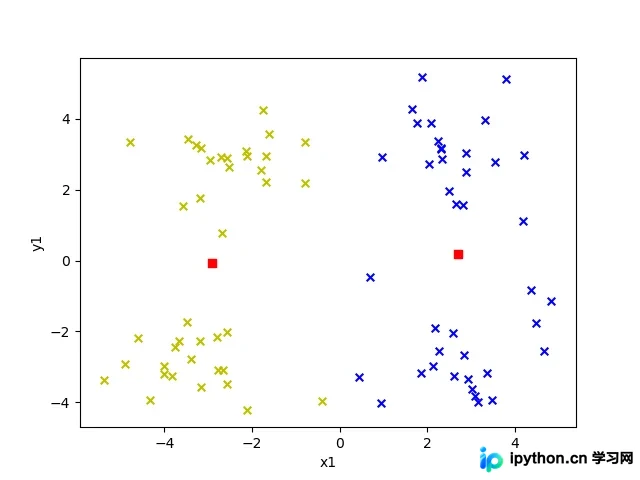
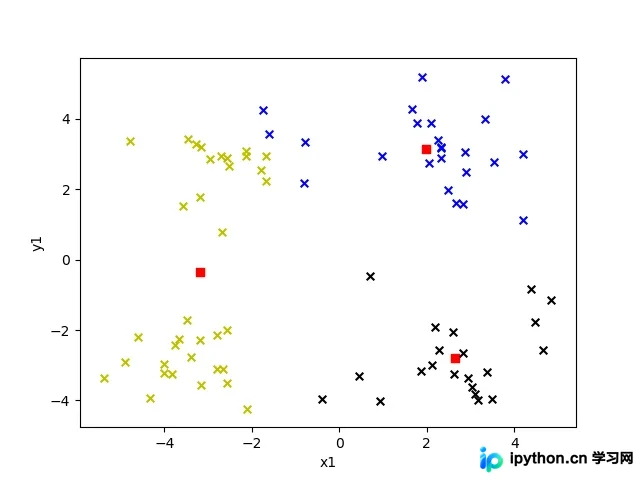
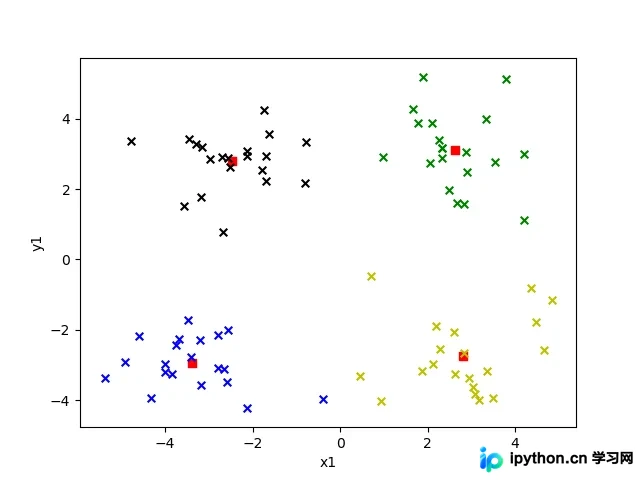
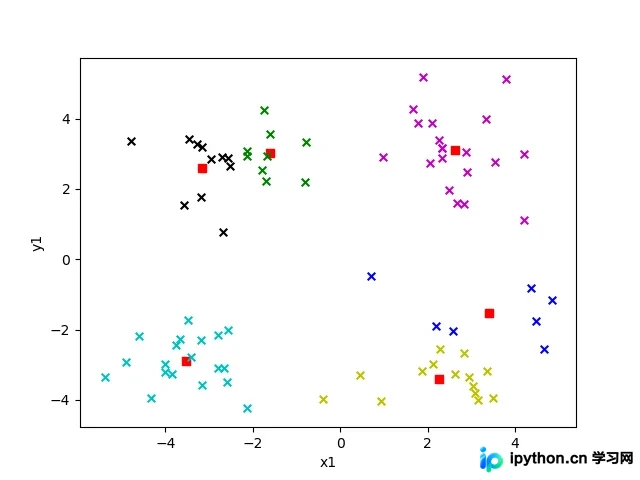
选取不同的K值对结果影响有多大?我们通过以下K值为2到6的效果来观察。 图中红色方块代表“簇”的中心点,每个“簇”所属的点用不同颜色表示。
K = 2
K = 3
K = 4
K = 5
K = 6
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









