

Python 使用 docopt 解析 JSON 参数文件的方法

发布时间:2026-10-13| 6人浏览过
本文介绍如何在 Python 中使用 docopt 库解析 JSON 参数文件。针对深度学习任务中复杂的配置需求,docopt 提供了比传统 argparse 更简洁的解决方案。通过定义 Usage 字符串和加载 JSON 文件,可轻松将参数传入训练函数,实现配置与代码的分离。
背景与问题
1. 背景
在深度学习任务中,往往涉及复杂的参数设置以及输入输出配置。例如,可能需要指定不同的训练数据集、选择不同的模型架构、将日志写入特定的文件,并将结果输出到不同的文件夹,以避免输出内容混淆。
传统的 parser.add() 方法会占用大量代码空间,且输入输出配置无法通过文件进行更改,只能依赖命令行参数进行调整,灵活性较差。
docopt 库提供了一种优雅的命令行解析工具。本文主要介绍如何利用该库解析文件参数。
安装与使用
2. 安装
pip install docopt
import docopt
import json
3. 使用
解析定义
docopt 主要由两部分组成:第一部分是解析定义部分,通过三重双引号(""" - """)包裹的一段类似注释的字符串表示,这是必不可少的步骤。
"""
Usage: train <json_file>
"""
上述解析部分的指令非常简洁,预期的输入格式应为:
python test.py config.json主函数实现
第二部分是主函数(main function)的实现:
if __name__ == "__main__":
  args = docopt.docopt(__doc__)
  args = json.load(open(args["<json_file>"]))
  print('==>Params')
  for key in args.keys():
    print('\t{}:{}\n'.format(key,args[key]))
  train(args)
假设我们将 config.json 文件内容设置为:
{
 "dataset":    "human_science",
 "length":     1000,
 "model":     "CNN",
 "log_dir":    "./logs/",
 "output_dir":   "./output/",
 "output_prefix": "human_science_CNN",

 "lr":0.01
}
此时命令行执行后的输出结果应为:
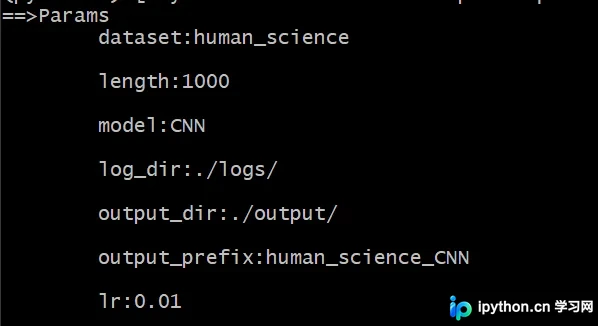
这样便成功将参数传递给了 train() 函数。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









