


很多列表页都会遇到“按首字母分组”的需求,比如城市选择、通讯录索引,或者 App 里的字母检索。本文把一段可直接使用的 PHP 实现重新梳理一遍:先看它怎么取中文首字母,再看如何完成二维数组分组排序,最后结合示例结果说明这种写法适合什么场景、有哪些边界需要提前心里有数。
为什么项目里经常需要首字母分组
这类需求并不少见。最典型的场景,是城市列表、地区选择器、品牌索引页,以及移动端常见的 A-Z 快速定位。用户并不关心数据在数据库里怎么存,但会很在意列表能不能按字母快速找到目标。
如果数据本身是中文,就不能直接用普通字符串排序替代“拼音首字母分组”。例如“安徽”“福建”“广东”“江苏”在展示层经常需要被整理成 A、F、G、J 这样的索引结构,前端拿到结果后,无论是网页还是 App,都能直接渲染成带字母标题的列表。
原始思路并不复杂,核心就两步:
- 先为每一项计算一个首字母字段;
- 再按这个字段把二维数组归组并排序。
下面这份代码正是围绕这两个步骤展开的。
核心实现:先取首字母,再完成分组排序
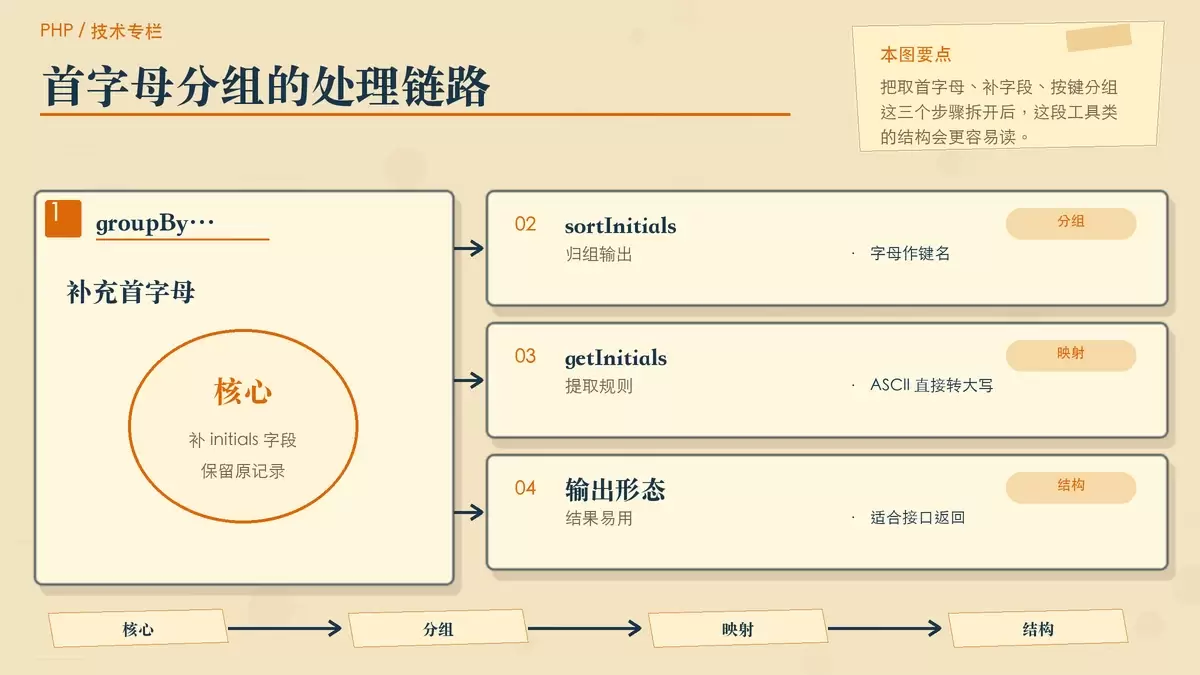
先看完整类。它包含 3 个方法:groupByInitials() 负责给每条数据补上首字母并触发排序,sortInitials() 负责按字母归组,getInitials() 负责把中文转换成对应的首字母。
<?php

/**
 * @author Tech
 */
class Character
{
    /**
     * 二维数组根据首字母分组排序
     * @param  array  $data      二维数组
     * @param  string $targetKey 首字母的键名
     * @return array             根据首字母关联的二维数组
     */
    public function groupByInitials(array $data, $targetKey = 'name')
    {
        $data = array_map(function ($item) use ($targetKey) {
            return array_merge($item, [
                'initials' => $this->getInitials($item[$targetKey]),
            ]);
        }, $data);
        $data = $this->sortInitials($data);
        return $data;
    }

    /**
     * 按字母排序
     * @param  array  $data
     * @return array
     */
    public function sortInitials(array $data)
    {
        $sortData = [];
        foreach ($data as $key => $value) {
            $sortData[$value['initials']][] = $value;
        }
        ksort($sortData);
        return $sortData;
    }

    /**
     * 获取首字母
     * @param  string $str 汉字字符串
     * @return string 首字母
     */
    public function getInitials($str)
    {
        if (empty($str)) {return '';}
        $fchar = ord($str{0});
        if ($fchar >= ord('A') && $fchar <= ord('z')) {
            return strtoupper($str{0});
        }

        $s1  = iconv('UTF-8', 'gb2312', $str);
        $s2  = iconv('gb2312', 'UTF-8', $s1);
        $s   = $s2 == $str ? $s1 : $str;
        $asc = ord($s{0}) * 256 + ord($s{1}) - 65536;
        if ($asc >= -20319 && $asc <= -20284) {
            return 'A';
        }

        if ($asc >= -20283 && $asc <= -19776) {
            return 'B';
        }

        if ($asc >= -19775 && $asc <= -19219) {
            return 'C';
        }

        if ($asc >= -19218 && $asc <= -18711) {
            return 'D';
        }

        if ($asc >= -18710 && $asc <= -18527) {
            return 'E';
        }

        if ($asc >= -18526 && $asc <= -18240) {
            return 'F';
        }

        if ($asc >= -18239 && $asc <= -17923) {
            return 'G';
        }

        if ($asc >= -17922 && $asc <= -17418) {
            return 'H';
        }

        if ($asc >= -17417 && $asc <= -16475) {
            return 'J';
        }

        if ($asc >= -16474 && $asc <= -16213) {
            return 'K';
        }

        if ($asc >= -16212 && $asc <= -15641) {
            return 'L';
        }

        if ($asc >= -15640 && $asc <= -15166) {
            return 'M';
        }

        if ($asc >= -15165 && $asc <= -14923) {
            return 'N';
        }

        if ($asc >= -14922 && $asc <= -14915) {
            return 'O';
        }

        if ($asc >= -14914 && $asc <= -14631) {
            return 'P';
        }

        if ($asc >= -14630 && $asc <= -14150) {
            return 'Q';
        }

        if ($asc >= -14149 && $asc <= -14091) {
            return 'R';
        }

        if ($asc >= -14090 && $asc <= -13319) {
            return 'S';
        }

        if ($asc >= -13318 && $asc <= -12839) {
            return 'T';
        }

        if ($asc >= -12838 && $asc <= -12557) {
            return 'W';
        }

        if ($asc >= -12556 && $asc <= -11848) {
            return 'X';
        }

        if ($asc >= -11847 && $asc <= -11056) {
            return 'Y';
        }

        if ($asc >= -11055 && $asc <= -10247) {
            return 'Z';
        }

        return null;
    }

}
这段实现的优点,是结构足够直接,放进项目就能用。只要你的二维数组里有一个中文字段,比如地区名、城市名、分类名,就可以通过 $targetKey 指定它,然后统一补充 initials 字段。
groupByInitials 做了什么
groupByInitials() 的入口很明确:接收原始二维数组,再接收一个要提取首字母的字段名。它用 array_map() 遍历每一项,把原来的数据和新的 initials 字段合并在一起。
这意味着它不会破坏你原来的业务字段,而是在原结构上补充一个可用于展示和排序的值。对于接口层来说,这种处理方式比较顺手,因为前端通常也希望保留完整记录,而不是只拿到一个字母列表。
sortInitials 怎么完成分组
sortInitials() 的逻辑也很实用。它没有对整条记录做复杂排序,而是直接把首字母作为关联数组的键:
$sortData['A'][]收集所有 A 开头的数据;$sortData['H'][]收集所有 H 开头的数据;- 最后再通过
ksort($sortData)按键名升序排列。
这样处理后的结果,天然就适合渲染成“字母标题 + 列表项”的结构。相比先整体排序、再遍历切段,这种写法更贴近常见接口返回格式。
getInitials 的核心原理
真正的关键在 getInitials()。如果字符串首字符本身就是英文字母,代码直接返回其大写形式:
if ($fchar >= ord('A') && $fchar <= ord('z')) {
    return strtoupper($str{0});
}
如果是中文,则先经过一次编码转换:
$s1  = iconv('UTF-8', 'gb2312', $str);
$s2  = iconv('gb2312', 'UTF-8', $s1);
$s   = $s2 == $str ? $s1 : $str;
$asc = ord($s{0}) * 256 + ord($s{1}) - 65536;
这里的思路是利用 gb2312 编码区间,把汉字映射到一个数值范围,再根据不同区间落在哪一段,返回对应的拼音首字母。例如某个区间返回 A,另一个区间返回 B,一直到 Z。
这种方式是早期 PHP 项目里很常见的方案,优点是不用额外依赖第三方库;缺点也很明显,它依赖固定的编码区间判断,因此更适合做“常见中文词条的首字母归组”,而不是做严格意义上的完整拼音转换。
怎么在项目里使用这段代码
原文给出的建议是直接引入类文件即可;如果你的项目已经使用命名空间,也可以按现有目录结构自行补充。实际使用时,只需要准备好原始数据,再指定目标字段名。
// 按首字母排序
$data = [
    ['id' => 1, 'area_name' => '山东'],
    ['id' => 2, 'area_name' => '江苏'],
    ['id' => 3, 'area_name' => '安徽'],
    ['id' => 4, 'area_name' => '福建'],
    ['id' => 5, 'area_name' => '江西'],
    ['id' => 6, 'area_name' => '广东'],
    ['id' => 7, 'area_name' => '广西'],
    ['id' => 8, 'area_name' => '海南'],
    ['id' => 9, 'area_name' => '河南'],
    ['id' => 10, 'area_name' => '湖南'],
    ['id' => 11, 'area_name' => '湖北'],
];
// 初始化,然后调用分组方法
$data = (new Character)->groupByInitials($data, 'area_name');
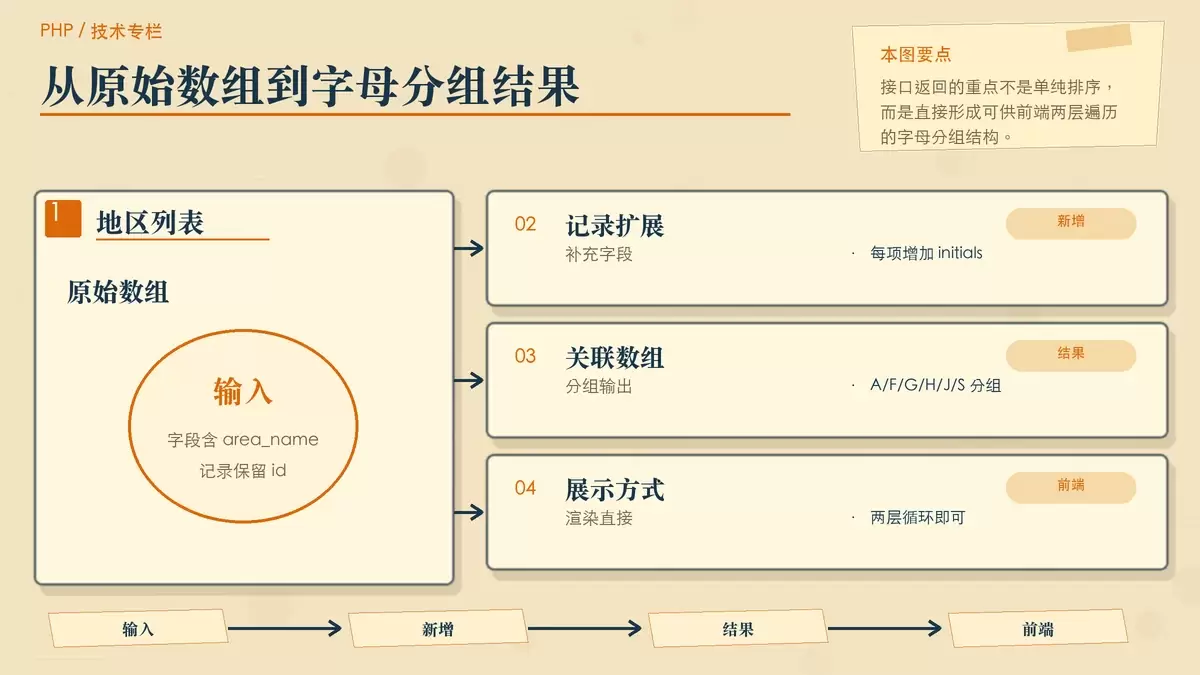
这里的重点有两个。第一,原始数组中的字段名并不固定,所以方法第二个参数 'area_name' 很重要,它告诉程序应该从哪个字段中提取首字母。第二,返回结果已经不是简单的顺序数组,而是“首字母 => 对应列表”的结构。
如果你处理的不是地区,而是城市、学校、品牌、联系人姓名,只要字段里存的是需要拿来分组的中文文本,这个调用方式都一样。接口层通常可以直接把结果返回给前端,前端按字母键遍历输出即可。
输出结果长什么样,为什么它适合前端展示
执行后的结果如下:
$data = array(
    'A' => array(
        0 => array(
            'id' => 3,
            'area_name' => '安徽',
            'initials' => 'A'
        )
    ) ,
    'F' => array(
        0 => array(
            'id' => 4,
            'area_name' => '福建',
            'initials' => 'F'
        )
    ) ,
    'G' => array(
        0 => array(
            'id' => 6,
            'area_name' => '广东',
            'initials' => 'G'
        ) ,
        1 => array(
            'id' => 7,
            'area_name' => '广西',
            'initials' => 'G'
        )
    ) ,
    'H' => array(
        0 => array(
            'id' => 8,
            'area_name' => '海南',
            'initials' => 'H'
        ) ,
        1 => array(
            'id' => 9,
            'area_name' => '河南',
            'initials' => 'H'
        ) ,
        2 => array(
            'id' => 10,
            'area_name' => '湖南',
            'initials' => 'H'
        ) ,
        3 => array(
            'id' => 11,
            'area_name' => '湖北',
            'initials' => 'H'
        )
    ) ,
    'J' => array(
        0 => array(
            'id' => 2,
            'area_name' => '江苏',
            'initials' => 'J'
        ) ,
        1 => array(
            'id' => 5,
            'area_name' => '江西',
            'initials' => 'J'
        )
    ) ,
    'S' => array(
        0 => array(
            'id' => 1,
            'area_name' => '山东',
            'initials' => 'S'
        )
    )
);
从展示层角度看,这个结果很清晰:
- A 组里有“安徽”;
- G 组里有“广东”“广西”;
- H 组里有“海南”“河南”“湖南”“湖北”。
前端如果要做通讯录式索引,通常只需要两层循环:外层遍历字母分组,内层输出组内项目。因为每条记录都保留了原始字段和新增的 initials 字段,所以无论你是做接口缓存、模板渲染,还是给移动端返回 JSON,结构都比较顺手。
另外,ksort() 已经保证了 A-Z 的键顺序,因此前端一般不需要再单独排序一次,除非业务上还要加入“热门城市”“当前定位”这种额外分区。
这类实现的适用范围与需要注意的地方
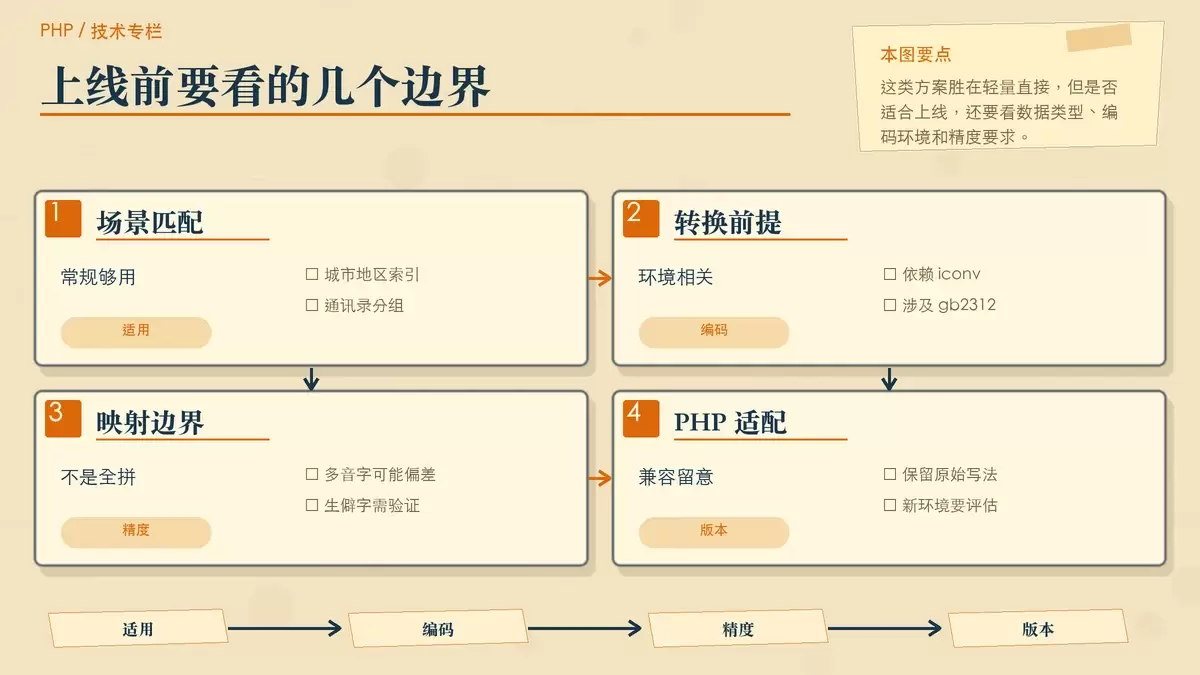
这段代码能解决很多常规需求,但在实际项目里,仍有几个判断标准值得提前说明。
适合哪些场景
如果你的目标是做首字母索引、列表归组、地区字母导航,这种写法已经够用。它轻量、直接、没有外部依赖,尤其适合老项目、工具类封装,或者只需要把中文名称按拼音首字母粗略归类的接口场景。
编码依赖要留意
getInitials() 明确使用了 iconv('UTF-8', 'gb2312', $str)。这意味着你的运行环境需要支持相应编码转换,同时数据本身也要尽量保持规范的 UTF-8 输入。否则一旦转换异常,首字母结果就可能不稳定。
多音字和生僻字不是它的强项
这种方案基于编码区间映射,并不是完整拼音词典。对于常见省份、城市、一般词条,表现通常没问题;但如果遇到多音字、人名、品牌特例或生僻字,返回结果未必符合业务预期。换句话说,它更适合“首字母归组”,不适合“高精度拼音系统”。
老写法在新 PHP 版本中的兼容性
代码里使用了 $str{0}、$s{0}、$s{1} 这种字符串下标写法。对阅读老项目代码来说这没问题,但如果你准备在较新的 PHP 环境里长期使用,通常会考虑按项目规范评估兼容性处理方式。本文保留原实现,是为了完整呈现它的原始思路和调用方法。
总体来看,这份工具类最大的价值,不是把“拼音转换”做得多复杂,而是用很短的代码,把“中文字段提取首字母 + 二维数组按字母分组排序”这件事一次解决掉。对于城市列表、地区索引、通讯录导航这类需求,它依然是一种相当务实的 PHP 写法。









