

Python实现逻辑回归:原理推导与梯度上升算法详解

本文详细解析逻辑回归的核心原理,通过最大似然概率构建方程并利用牛顿梯度上升求解参数。文章结合Python代码,逐步演示如何读取数据、定义Sigmoid函数及实现梯度上升算法,最后通过可视化结果展示分类效果,帮助读者深入理解二分类问题的数学推导与工程实现。
逻辑回归核心原理与优缺点
逻辑回归分类器的核心思想是利用最大似然概率方法构建数学方程,并通过最大化该方程,使用牛顿梯度上升法来求解方程中的参数。
- 该算法的优势在于计算成本较低,且概念直观,易于理解和实现。
- 其局限性在于容易产生欠拟合现象,导致分类精度可能不够理想。
- 逻辑回归适用于处理数值型和标称型数据。
最大似然概率直观理解
在深入介绍逻辑回归之前,我们先探讨一个直观问题:假设有一个黑箱,内部装有白球和黑球,如何判断这两种球的比例?
如果我们从箱中随机抓取3个球,观察到2个黑球和1个白球,有人可能会直接推断黑球占比67%,白球占比33%。这实际上运用了最大似然概率的思想:通俗来说,当黑球真实占比为67%时,抽取3个球出现2黑1白组合的概率是最大的。
假设黑球的占比为P,白球占比为1-P。我们的目标是求解 MAX(P^2(1-P))。显然,当P=67%时方程取得最大值(求解方法是对该方程求导,令导数为0,此时的P值即为最优解)。
逻辑回归的数学推导
回顾逻辑回归,它主要解决二分类问题,这与上述黑球白球问题在逻辑上高度相似。逻辑回归同样基于最大似然概率来进行参数求解。
假设我们有n个独立的训练样本{(x1, y1), (x2, y2), …, (xn, yn)},其中y的取值集合为{0, 1}。那么,每一个观察到的样本(xi, yi)出现的概率可以表示为特定的数学形式。
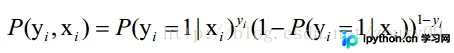
上述公式的构造逻辑在于:当y=1时,公式中涉及(1-y)的项消失,仅保留x属于1类的概率;当y=0时,涉及y的项消失,仅保留x属于0类的概率(即1减去x属于1类的概率)。因此,无论y取0还是1,该公式计算出的都是样本(x, y)出现的联合概率。对于包含n个独立样本的整个数据集,其似然函数L(θ)等于所有样本出现概率的乘积。
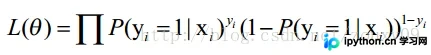
为了便于计算,我们对L(θ)进行变换:取自然对数并化简(无需畏惧复杂的公式,只需耐心推导即可理解)。注:公式中的xi表示第i个样本,后续推导中未做额外区分。化简后得到的对数似然函数形式如下。
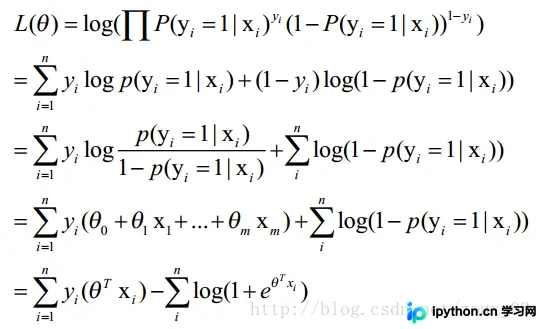
其中,从第三步到第四步的推导使用了特定的替换关系。
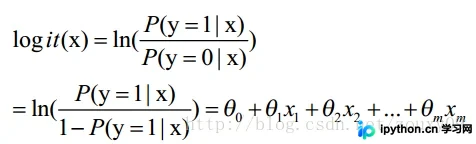
为了求得最大值,我们需要对L(θ)关于参数θ求导,得到的导数表达式为特定形式。
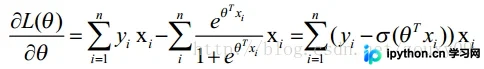
接着,我们令该导数为0,理论上可以求出最优解。然而,该方程无法通过解析方法直接求解(此处省略证明过程)。因此,问题转化为寻找一组参数使方程L最大化,求解这些参数的方法采用梯度上升法(其原理可参考详细代码中的计算方式,结合代码理解更为直观)。
根据参数转换公式:
我们将参数和特征代入,计算P,即样本属于类别1的概率。
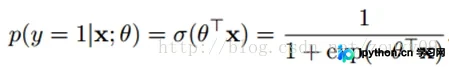
上述公式即为常见的Sigmoid函数,也常被称为激活函数,最终用于分类决策(若P(y=1|x;Θ)大于0.5,则判定该样本为类别1)。
Python代码实现与结果分析
以下是详细的逻辑回归Python代码实现。代码逻辑相对简单,重点在于理解前文所述的算法思想。个人建议读者结合代码逐步跟踪计算过程,并与前文的公式推导进行对比,这样有助于加深理解并巩固记忆。
from numpy import *
filename='...\\testSet.txt' #文件目录
def loadDataSet():  #读取数据(这里只有两个特征)
  dataMat = []
  labelMat = []
  fr = open(filename)
  for line in fr.readlines():
    lineArr = line.strip().split()
    dataMat.append([1.0, float(lineArr[0]), float(lineArr[1])])  #前面的1,表示方程的常量。比如两个特征X1,X2,共需要三个参数,W1+W2*X1+W3*X2
    labelMat.append(int(lineArr[2]))
  return dataMat,labelMat

def sigmoid(inX): #sigmoid函数
  return 1.0/(1+exp(-inX))

def gradAscent(dataMat, labelMat): #梯度上升求最优参数
  dataMatrix=mat(dataMat) #将读取的数据转换为矩阵
  classLabels=mat(labelMat).transpose() #将读取的数据转换为矩阵
  m,n = shape(dataMatrix)
  alpha = 0.001 #设置梯度的阀值,该值越大梯度上升幅度越大
  maxCycles = 500 #设置迭代的次数,一般看实际数据进行设定,有些可能200次就够了
  weights = ones((n,1)) #设置初始的参数,并都赋默认值为1。注意这里权重以矩阵形式表示三个参数。
  for k in range(maxCycles):
    h = sigmoid(dataMatrix*weights)
    error = (classLabels - h)   #求导后差值
    weights = weights + alpha * dataMatrix.transpose()* error #迭代更新权重
  return weights

def stocGradAscent0(dataMat, labelMat): #随机梯度上升,当数据量比较大时,每次迭代都选择全量数据进行计算,计算量会非常大。所以采用每次迭代中一次只选择其中的一行数据进行更新权重。
  dataMatrix=mat(dataMat)
  classLabels=labelMat
  m,n=shape(dataMatrix)
  alpha=0.01
  maxCycles = 500
  weights=ones((n,1))
  for k in range(maxCycles):
    for i in range(m): #遍历计算每一行
      h = sigmoid(sum(dataMatrix[i] * weights))
      error = classLabels[i] - h
      weights = weights + alpha * error * dataMatrix[i].transpose()
  return weights

def stocGradAscent1(dataMat, labelMat): #改进版随机梯度上升,在每次迭代中随机选择样本来更新权重,并且随迭代次数增加,权重变化越小。
  dataMatrix=mat(dataMat)
  classLabels=labelMat
  m,n=shape(dataMatrix)
  weights=ones((n,1))
  maxCycles=500
  for j in range(maxCycles): #迭代
    dataIndex=[i for i in range(m)]
    for i in range(m): #随机遍历每一行
      alpha=4/(1+j+i)+0.0001 #随迭代次数增加,权重变化越小。
      randIndex=int(random.uniform(0,len(dataIndex))) #随机抽样
      h=sigmoid(sum(dataMatrix[randIndex]*weights))
      error=classLabels[randIndex]-h
      weights=weights+alpha*error*dataMatrix[randIndex].transpose()
      del(dataIndex[randIndex]) #去除已经抽取的样本
  return weights

def plotBestFit(weights): #画出最终分类的图
  import matplotlib.pyplot as plt
  dataMat,labelMat=loadDataSet()
  dataArr = array(dataMat)
  n = shape(dataArr)[0]
  xcord1 = []; ycord1 = []
  xcord2 = []; ycord2 = []
  for i in range(n):
    if int(labelMat[i])== 1:
      xcord1.append(dataArr[i,1])
      ycord1.append(dataArr[i,2])
    else:
      xcord2.append(dataArr[i,1])
      ycord2.append(dataArr[i,2])
  fig = plt.figure()
  ax = fig.add_subplot(111)
  ax.scatter(xcord1, ycord1, s=30, c='red', marker='s')
  ax.scatter(xcord2, ycord2, s=30, c='green')
  x = arange(-3.0, 3.0, 0.1)
  y = (-weights[0]-weights[1]*x)/weights[2]
  ax.plot(x, y)
  plt.xlabel('X1')
  plt.ylabel('X2')
  plt.show()

def main():
  dataMat, labelMat = loadDataSet()
  weights=gradAscent(dataMat, labelMat).getA()
  plotBestFit(weights)

if __name__=='__main__':
  main()
运行上述代码后,得到的结果展示如下。
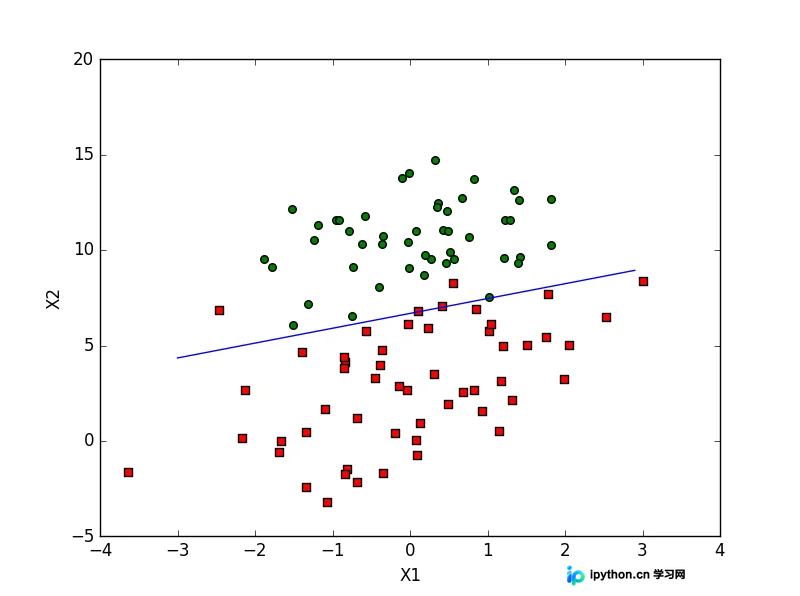
此外,读者还可以尝试使用随机梯度上升法或改进的随机梯度上升算法,这些变体算法通常也能取得不错的效果。
以下是代码所使用的基础数据,您可以直接复制并保存为本地text文件,然后运行前面的代码进行实验。
-0.017612	14.053064	0
-1.395634	4.662541	1
-0.752157	6.538620	0
-1.322371	7.152853	0
0.423363	11.054677	0
0.406704	7.067335	1
0.667394	12.741452	0
-2.460150	6.866805	1
0.569411	9.548755	0
-0.026632	10.427743	0
0.850433	6.920334	1
1.347183	13.175500	0
1.176813	3.167020	1
-1.781871	9.097953	0
-0.566606	5.749003	1
0.931635	1.589505	1
-0.024205	6.151823	1
-0.036453	2.690988	1
-0.196949	0.444165	1
1.014459	5.754399	1
1.985298	3.230619	1
-1.693453	-0.557540	1
-0.576525	11.778922	0
-0.346811	-1.678730	1
-2.124484	2.672471	1
1.217916	9.597015	0
-0.733928	9.098687	0
-3.642001	-1.618087	1
0.315985	3.523953	1
1.416614	9.619232	0
-0.386323	3.989286	1
0.556921	8.294984	1
1.224863	11.587360	0
-1.347803	-2.406051	1
1.196604	4.951851	1
0.275221	9.543647	0
0.470575	9.332488	0
-1.889567	9.542662	0
-1.527893	12.150579	0
-1.185247	11.309318	0
-0.445678	3.297303	1
1.042222	6.105155	1
-0.618787	10.320986	0
1.152083	0.548467	1
0.828534	2.676045	1
-1.237728	10.549033	0
-0.683565	-2.166125	1
0.229456	5.921938	1
-0.959885	11.555336	0
0.492911	10.993324	0
0.184992	8.721488	0
-0.355715	10.325976	0
-0.397822	8.058397	0
0.824839	13.730343	0
1.507278	5.027866	1
0.099671	6.835839	1
-0.344008	10.717485	0
1.785928	7.718645	1
-0.918801	11.560217	0
-0.364009	4.747300	1
-0.841722	4.119083	1
0.490426	1.960539	1
-0.007194	9.075792	0
0.356107	12.447863	0
0.342578	12.281162	0
-0.810823	-1.466018	1
2.530777	6.476801	1
1.296683	11.607559	0
0.475487	12.040035	0
-0.783277	11.009725	0
0.074798	11.023650	0
-1.337472	0.468339	1
-0.102781	13.763651	0
-0.147324	2.874846	1
0.518389	9.887035	0
1.015399	7.571882	0
-1.658086	-0.027255	1
1.319944	2.171228	1
2.056216	5.019981	1
-0.851633	4.375691	1
-1.510047	6.061992	0
-1.076637	-3.181888	1
1.821096	10.283990	0
3.010150	8.401766	1
-1.099458	1.688274	1
-0.834872	-1.733869	1
-0.846637	3.849075	1
1.400102	12.628781	0
1.752842	5.468166	1
0.078557	0.059736	1
0.089392	-0.715300	1
1.825662	12.693808	0
0.197445	9.744638	0
0.126117	0.922311	1
-0.679797	1.220530	1
0.677983	2.556666	1
0.761349	10.693862	0
-2.168791	0.143632	1
1.388610	9.341997	0
0.317029	14.739025	0
以上就是本文的全部内容,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









