


很多 Go 开发者第一次接触 Gin 时,都会注意到它在性能上的口碑,尤其是“路由匹配比标准库快很多”这一点。真正值得理解的,不只是结论本身,而是 Gin 为什么把性能消耗压在了更少的步骤里:它如何组织路由、如何决定匹配顺序,又是怎样减少内存分配的。读完这篇文章,你可以把 Gin 的性能优势拆成几个可验证的技术点,而不只是停留在“它更快”这个印象上。
Gin 的路由为什么能跑得更快
在 Go Web 开发里,Gin 一直以高性能著称。它的 API 风格接近 Martini,但底层实现更强调执行效率。核心原因之一,是 Gin 借助了 httprouter 的思路,没有沿用以正则为主的匹配方式,而是把路由组织成更适合 URL 场景的压缩字典树(Compressed Radix Tree)。
这种设计的重点在于:路由查找更接近按照路径长度进行匹配,时间复杂度近乎 O(m),其中 m 是 URL 路径长度,而不是随着路由总数线性增长。对于路由数量多、请求频繁的服务,这种差异会被迅速放大。
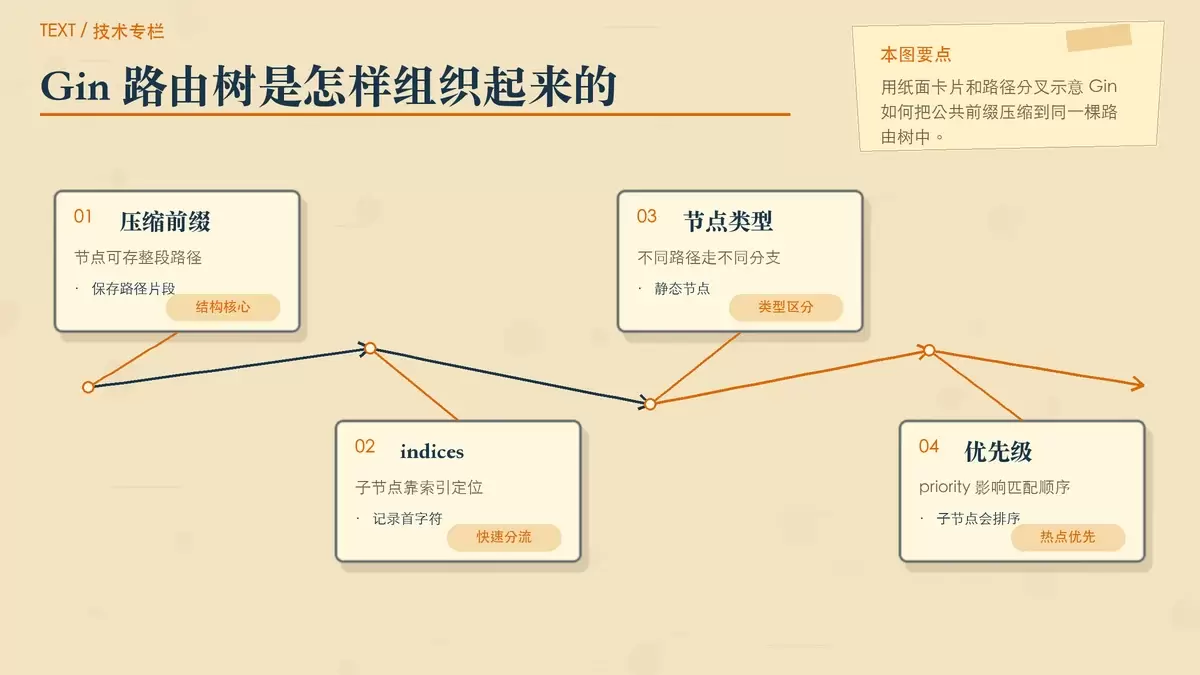
和标准字典树相比,压缩字典树不会让每个节点只保存一个字符,而是直接保存一段公共路径。这样做的好处很直接:树更浅、节点更少、遍历更快、内存占用也更可控。像 apple 和 application 这样的键,会共享公共前缀 appl,后续再分叉成不同子节点。URL 路径天然带有前缀复用特征,所以这类结构非常适合路由系统。
压缩字典树在 Gin 里是怎么落地的
路由节点包含哪些关键字段
Gin 的路由树由节点构成,每个节点都承担路径片段匹配和分支决策的职责。核心结构如下:
type node struct {
    path      string        // 节点路径
    indices   string        // 子节点首字符索引
    children  []*node       // 子节点列表
    handlers  HandlersChain // 处理函数链
    priority  uint32        // 优先级
    nType     nodeType      // 节点类型(static/root/param/catchAll)
    wildChild bool          // 是否为通配节点
    fullPath  string        // 完整路径
}
这里最值得注意的,不只是 path 和 children,还包括几个和性能直接相关的字段:
indices:保存子节点首字符索引,用来快速定位下一跳,而不是盲目遍历全部子节点。priority:记录节点优先级,帮助热点路径更早命中。handlers:路由匹配成功后直接关联处理函数链,避免额外查表。nType与wildChild:区分静态、参数、通配符等路径类型,让不同匹配逻辑可以走更明确的分支。
四类节点分别解决什么问题
Gin 把路由节点分成四种:static、root、param、catchAll。这并不是单纯为了代码分类,而是为了让匹配过程减少歧义。
静态节点对应固定路径,例如 /user/profile;参数节点对应 /user/:id 这类可变段;通配符节点则处理 /static/*filepath 这种“接收剩余路径”的场景。节点类型提前区分后,匹配时不需要把所有规则都放到同一种算法里比较,分支判断会更直接。
请求进来后,Gin 怎样完成路由匹配
先看注册:路由是怎么进入树里的
当我们注册一条路由时,例如:
r.GET("/user/:id", func(c *gin.Context) {
    // 处理函数
})
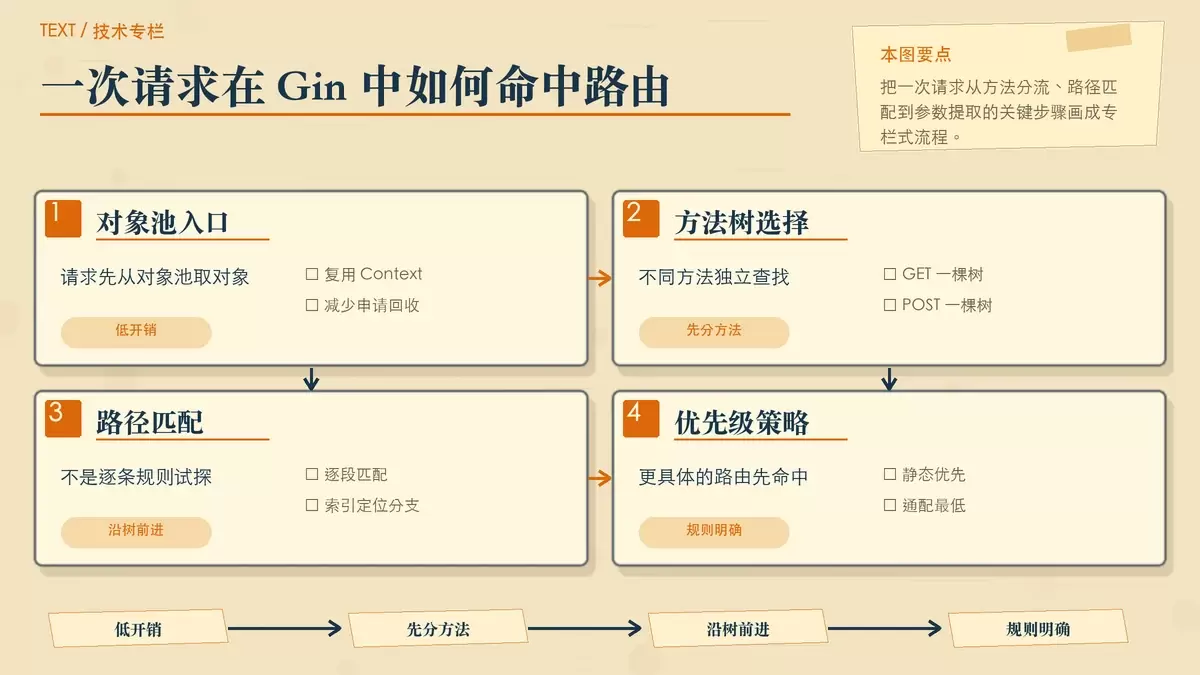
Gin 会把这条规则插入到对应 HTTP 方法的路由树中。也就是说,GET、POST、PUT 这类方法各有自己独立的树,而不是所有请求共用一棵总树。这样做的收益很明确:请求一开始就按方法分流,减少无关匹配。
路由注册本质上是在构建前缀复用结构。凡是有公共前缀的路径,都会共享父节点。例如 /user/:id 和 /user/profile 会共用前面的 /user/ 部分,后续再根据静态路径或参数节点分叉。
一次匹配通常会经历哪几步
当 HTTP 请求到达,Gin 的处理流程大致可以拆成下面几步:
- 从对象池获取 Context:复用已有对象,减少频繁分配和回收。
- 按 HTTP 方法选择路由树:GET 请求只进入 GET 树,POST 请求只进入 POST 树。
- 沿树逐段匹配路径:从根节点出发,依据路径内容和索引定位子节点。
- 提取参数:如果命中
:id这类参数节点,就把对应值解析出来。 - 执行处理链:路由命中后,按顺序执行中间件和最终处理函数。
这里的关键并不是“步骤少”,而是每一步都尽量避免额外动作。尤其在路径匹配阶段,Gin 并不依赖正则去反复尝试模式,而是顺着已经构建好的路径结构前进,这一点对吞吐量影响很大。
为什么静态路由会优先于参数路由
Gin 在匹配时有明确的优先级策略:
- 静态路由优先级最高,例如
/user/profile - 参数路由次之,例如
/user/:id - 通配符路由最低,例如
/static/*filepath
这意味着即使先注册了 /user/:id,后注册 /user/profile,请求访问 /user/profile 时也会优先命中静态路由,而不是把 profile 当成参数值。这种规则既保证语义准确,也减少了模糊匹配带来的额外判断成本。
支撑高性能的几项关键优化
零分配路由匹配
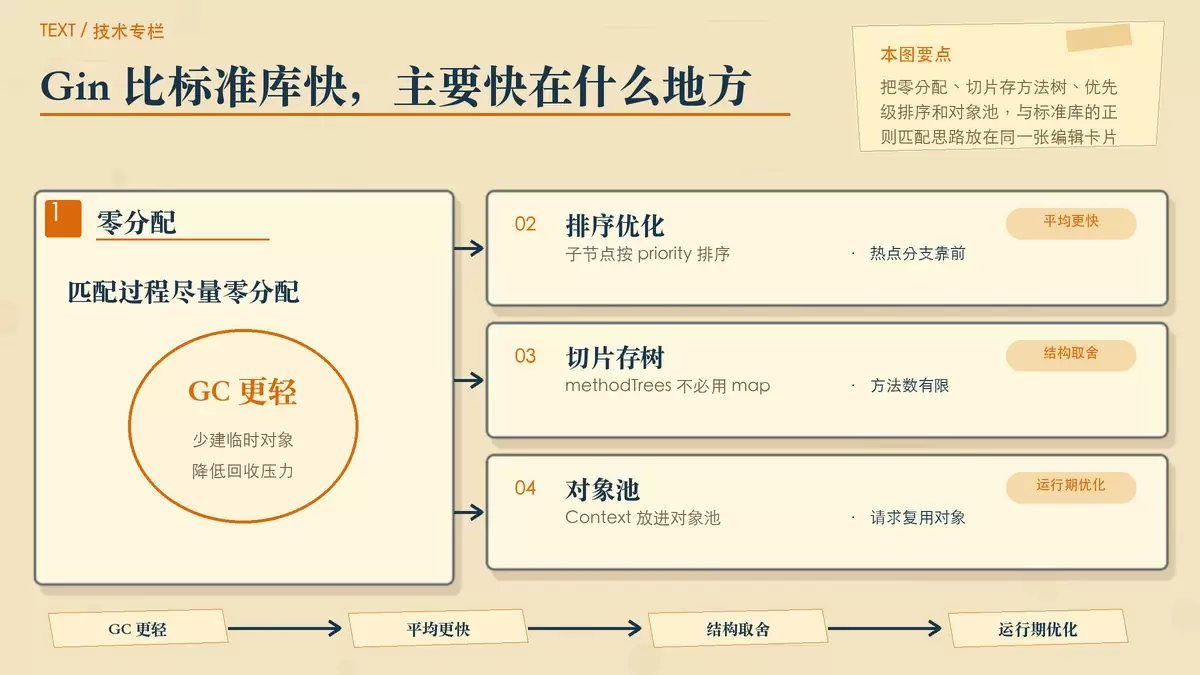
Gin 的一个重要目标,是让路由匹配过程尽量少产生临时对象。少分配内存,不只是省掉几次申请和释放,更重要的是能降低 GC 压力。在高并发服务中,请求量一上来,GC 抖动往往比单次匹配耗时更容易放大系统延迟。
因此,Gin 会尽量把匹配过程控制在已有结构上完成,避免为一次普通路径查找额外创建短生命周期数据。
子节点优先级排序
每个节点的子节点并不是随意排列的,而是按照 priority 排序。这个优先级和子节点上承载的路由数量相关,常被访问、被更多路径复用的分支会更靠前。
这么做的目的,是让更有可能命中的分支先被检查。路径树虽然已经降低了搜索范围,但在分叉点上仍然需要选择下一步,优先级排序可以继续把平均匹配成本压低。
方法树为什么用切片而不是 map
Gin 在存储不同 HTTP 方法的路由树时,没有直接使用 map,而是采用切片:
type methodTree struct {
    method string
    root   *node
}

type methodTrees []methodTree  // 使用切片而非map
原因并不复杂:HTTP 方法的数量很有限,常见范围内不过 9 种左右。对于这样一个小规模集合,切片足以高效遍历,同时还能减少 map 带来的额外内存开销和哈希成本。这是一个非常典型的工程取舍例子:不是所有查找都该默认上 map,数据规模决定了最优方案。
对象池复用 Context
Gin 还通过对象池复用 Context。请求到达时,从池中取出一个可用对象;请求处理完成后,再把它放回池中。这样做能显著减少高频创建、销毁对象的成本,对延迟稳定性也有帮助。
这项优化不只影响路由层,但它和零分配匹配一起,构成了 Gin 在高并发下保持轻量处理路径的重要基础。
和标准库相比,差距主要出现在哪里
把 Gin 和以正则匹配为主的标准库实现放在一起看,差距并不只体现在某个单点 benchmark,而是贯穿数据结构、匹配方式和内存行为:
| 维度 | Gin框架 | 标准库实现 |
|---|---|---|
| 路由算法 | 压缩前缀树(零分配) | 正则表达式匹配 |
| 性能基准 | 约2000 ns/请求(小负载) | 约5000 ns/请求 |
| 内存分配 | 极低(零分配路由) | 较高(每次请求约200B分配) |
| 适用场景 | 高并发、低延迟场景 | 一般并发需求 |
从这组数据看,Gin 的路由匹配速度大约是标准库的 2.5 倍,而不是表面口号里常见的所有场景统一“40 倍”。这恰恰说明,理解性能要看具体指标和测试口径。真正让 Gin 在生产环境里进一步拉开差距的,往往是低分配、低 GC 压力,以及在高并发下更稳定的延迟表现。
换句话说,基准测试里的纳秒差异只是入口,工程上的意义在于:当请求量持续上升时,Gin 的路由系统更不容易把成本转移给内存管理和调度系统。
实际使用时,怎么把这些优势用出来
合理使用路由组
Gin 的路由组不仅是代码组织工具,也有助于保持清晰的路径结构和中间件层次。通过统一前缀和批量挂载中间件,可以减少重复逻辑,降低维护成本:
v1 := router.Group("/api/v1")
{
    v1.GET("/users", getUsers)    // 实际路径:/api/v1/users
    v1.POST("/user", createUser) // 实际路径:/api/v1/user
}
从实现上看,分组不会改变压缩树的基本工作方式,但它能让路径设计更规整,避免路由规则散乱带来的冲突和理解成本。
控制中间件链长度和职责
Gin 的中间件采用链式执行。命中路由之后,请求会依次经过中间件和最终处理函数。这个模型本身很高效,但前提是每个中间件都足够明确、足够轻量。把过多业务逻辑塞进公共中间件,仍然会把请求路径拉长。
因此,Gin 的高性能并不意味着“怎么写都快”。更准确地说,它把底层匹配成本降得很低,但最终是否能把优势兑现出来,仍然取决于路由设计、中间件数量以及处理函数本身的复杂度。
结论:Gin 快在更贴近路径结构的设计
Gin 的路由性能优势,核心不在某个单独技巧,而在几项设计同时成立:用压缩字典树复用公共前缀,用节点类型区分静态与动态路径,用优先级提高命中效率,再通过零分配和对象池控制运行期成本。
对 Go 开发者来说,理解这套机制的价值不只是“知道 Gin 很快”,而是能看清高性能框架的基本思路:先让数据结构贴近问题本身,再把热点路径上的分配、分支和查找次数一层层减掉。这也是很多高并发系统优化最终都会回到的工程原则。









