

Python操作Kafka实战:从基础到分区、偏移量与主动拉取

本文通过Python代码示例,详细讲解Kafka的核心操作。内容涵盖基础的消息生产与消费、基于分区机制的负载均衡策略、利用偏移量(Offset)进行历史数据回溯,以及通过轮询(poll)实现定时批量拉取数据的最佳实践,帮助开发者掌握Kafka在Python环境下的关键应用技巧。
Kafka基础:生产者与消费者示例
首先介绍最基础的场景:生产者发送消息,消费者接收消息。以下是生产者的简化实现代码。
#!/usr/bin/env python
# -*- coding: utf-8 -*-
import json
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers='xxxx:x')

msg_dict = {
  "sleep_time": 10,
  "db_config": {
    "database": "test_1",
    "host": "xxxx",
    "user": "root",
    "password": "root"
  },
  "table": "msg",
  "msg": "Hello World"
}
msg = json.dumps(msg_dict)
producer.send('test_rhj', msg, partition=0)
producer.close()
对应的消费者简单代码如下所示:
from kafka import KafkaConsumer

consumer = KafkaConsumer('test_rhj', bootstrap_servers=['xxxx:x'])
for msg in consumer:
  recv = "%s:%d:%d: key=%s value=%s" % (msg.topic, msg.partition, msg.offset, msg.key, msg.value)
  print recv
运行上述代码后的输出结果如下:

基于分区机制的负载均衡策略
若需实现负载均衡,必须理解Kafka的分区机制。同一主题可划分为多个分区。当生产者未指定具体分区时,Kafka会将消息自动分发至不同分区。消费者在订阅时,若不指定消费者组(Consumer Group),将接收所有分区的消息;若指定了消费者组,则同一组内的消费者会分担不同分区的消费任务。例如,若有两个分区且由两个消费者的服务组消费,则每个消费者负责一个分区;若该组有三个消费者,则可能出现某个消费者无法获取数据的情况。若要使多个消费者消费同一分区,需使用不同的消费者组。基于此原理,我们对消费者代码进行如下调整:
from kafka import KafkaConsumer

consumer = KafkaConsumer('test_rhj', bootstrap_servers=['xxxx:x'])
for msg in consumer:
  recv = "%s:%d:%d: key=%s value=%s" % (msg.topic, msg.partition, msg.offset, msg.key, msg.value)
  print recv
随后启动两个消费者实例进行消费,生产者分别向0分区和1分区发送消息。结果如下所示,可见一个消费者仅能消费0分区,另一个仅能消费1分区:


利用偏移量(Offset)进行历史数据回溯
Kafka提供了偏移量(Offset)机制,允许消费者根据指定的偏移量消费之前遗漏的消息。这得益于Kafka名义上的全量存储特性,其可保留大量历史数据,且保留时长可配置(通常为7天)。若偏移量定位到已被删除的数据位置,则会出现问题,但这种情况概率较低。每个保存的数据文件均以偏移量命名,当前查询的偏移量减去文件名即为数据在该文件中的相对位置。要指定偏移量消费数据,必须明确指定该消费者所消费的分区,否则代码将无法定位分区从而导致消费失败。相关代码如下:
from kafka import KafkaConsumer
from kafka.structs import TopicPartition

consumer = KafkaConsumer(group_id='123456', bootstrap_servers=['10.43.35.25:4531'])
consumer.assign([TopicPartition(topic='test_rhj', partition=0), TopicPartition(topic='test_rhj', partition=1)])
print consumer.partitions_for_topic("test_rhj") # 获取test主题的分区信息
print consumer.assignment()
print consumer.beginning_offsets(consumer.assignment())
consumer.seek(TopicPartition(topic='test_rhj', partition=0), 0)
for msg in consumer:
  recv = "%s:%d:%d: key=%s value=%s" % (msg.topic, msg.partition, msg.offset, msg.key, msg.value)
  print recv
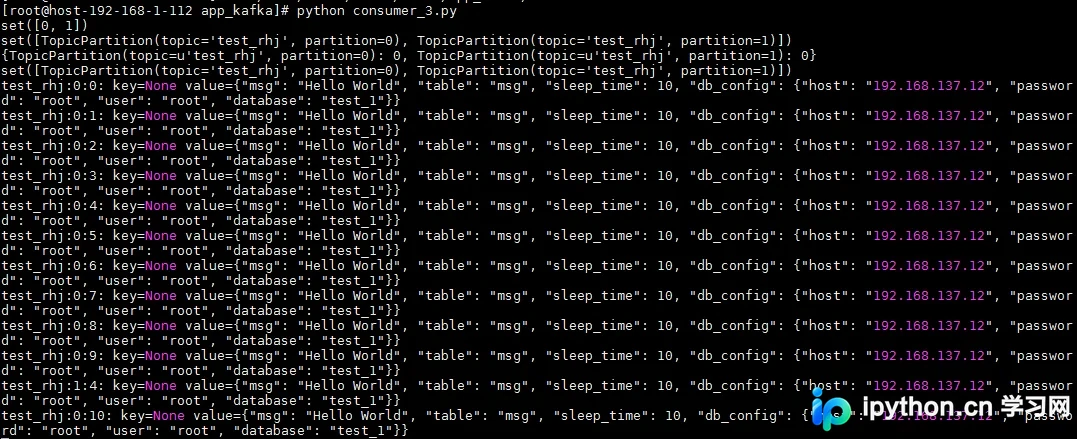
由于指定的偏移量为0,因此可以查询到从初始插入的所有数据。同时,因指定了具体分区,该分区内的结果均可被消费。输出结果如下:
主动拉取与定时批量处理机制
在某些场景下,实时获取数据可能导致性能瓶颈。此时,我们只需定时从队列中获取数据并进行批量处理。针对这种情况,可以选择主动拉取数据的方式。
from kafka import KafkaConsumer
import time

consumer = KafkaConsumer(group_id='123456', bootstrap_servers=['10.43.35.25:4531'])
consumer.subscribe(topics=('test_rhj',))
index = 0
while True:
  msg = consumer.poll(timeout_ms=5) # 从kafka获取消息
  print msg
  time.sleep(2)
  index += 1
  print '--------poll index is %s----------' % index
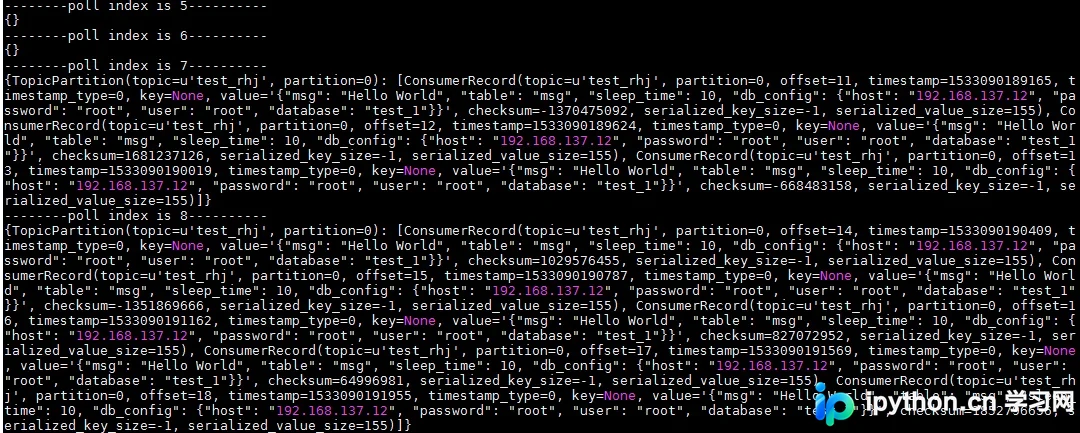
运行结果如下:每次拉取到的都是之前生产的数据,结果可能是一个包含多条消息的列表,也可能为空。若无数据,拉取结果为空。
以上内容为本文的全部介绍,希望能为您的学习提供帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









