

Python一行代码实现快速排序:原理、优化与面试实战

本文深入解析Python中快速排序的实现,展示如何仅用一行代码完成排序,并探讨其背后的分治原理。针对小规模数据集性能问题,提出结合插入排序的优化方案。同时包含符合PEP8规范的代码示例及模拟面试问答,帮助开发者掌握算法核心与工程实践。
本文将重点介绍快速排序算法。
一、算法介绍
排序算法是计算机科学中最基础且历史悠久的课题之一。对于程序员而言,理解并掌握各类排序算法是必备技能。在众多排序算法中,快速排序(Quicksort)应用最为广泛,且执行速度较快。该算法由图灵奖得主C. A. R. Hoare(托尼·霍尔)于1960年提出。
二、算法原理
快速排序的实现方式多样,这里介绍一种易于理解的分治加迭代方法,主要包含以下三个步骤:
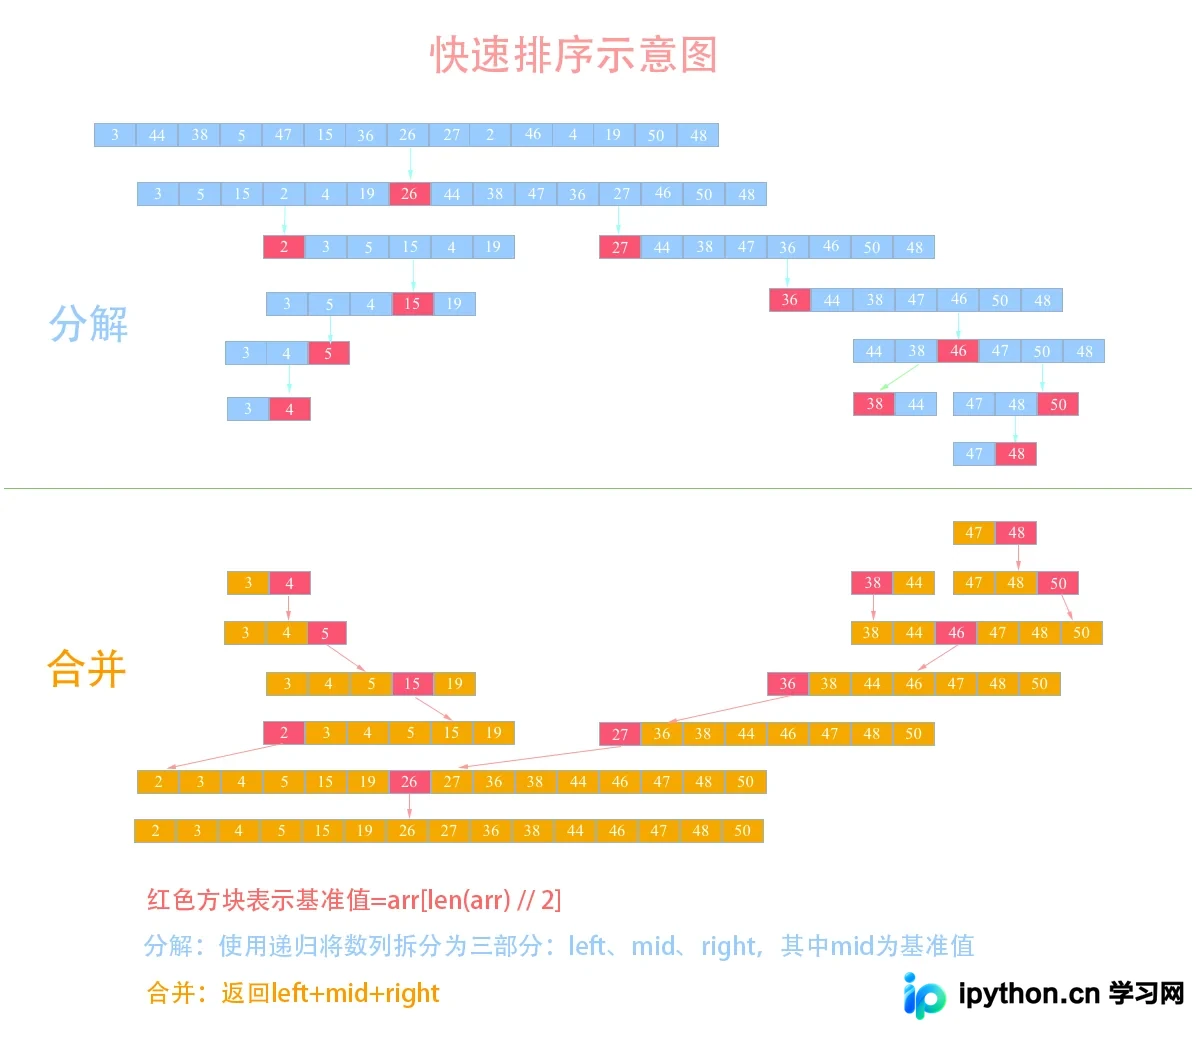
首先,在数列中选择一个元素作为“基准”(pivot,也可称为比较值)。将数列中所有其他元素与基准值进行比较:小于基准值的元素移至基准值左侧,大于基准值的元素移至右侧。随后,以基准值左右两侧的子数列作为新的处理对象,重复上述第一步和第二步,直到所有子集仅包含一个元素为止。
例如,假设有一个待排序数列:{3, 44, 38, 5, 47, 15, 36, 26, 27, 2, 46, 4, 19, 50, 48},我们来看使用快排的具体步骤:
选取中间的26作为基准值(基准值的选择可以是任意的)。从数列第一个元素3开始与基准值26进行比较,若小于基准值,则将其放入左侧分区;若第二个元素44大于基准值26,则将其放入右侧分区。依此类推,得到图中第二列的结果。接着,对左右两个分区分别进行再分区,得到第三列,如此递归下去,直到最后只剩下一个元素。分解完成后,按“左侧分区 + 基准值 + 右侧分区”的规则逐层返回。
三、代码实现
代码是否简洁优雅?如果面试官要求手写快排,你可以直接使用这一行代码,这可能会让面试官眼前一亮。
在赞叹Python强大功能的同时,也应考虑代码的可读性。lambda函数的设计旨在简化代码,但过度使用会导致可读性急剧下降。此外,当前的PEP8代码规范也不推荐使用lambda函数,而是建议使用关键字def来定义函数。因此,下面提供一段符合pythonic风格的快排代码供参考。
四、算法分析
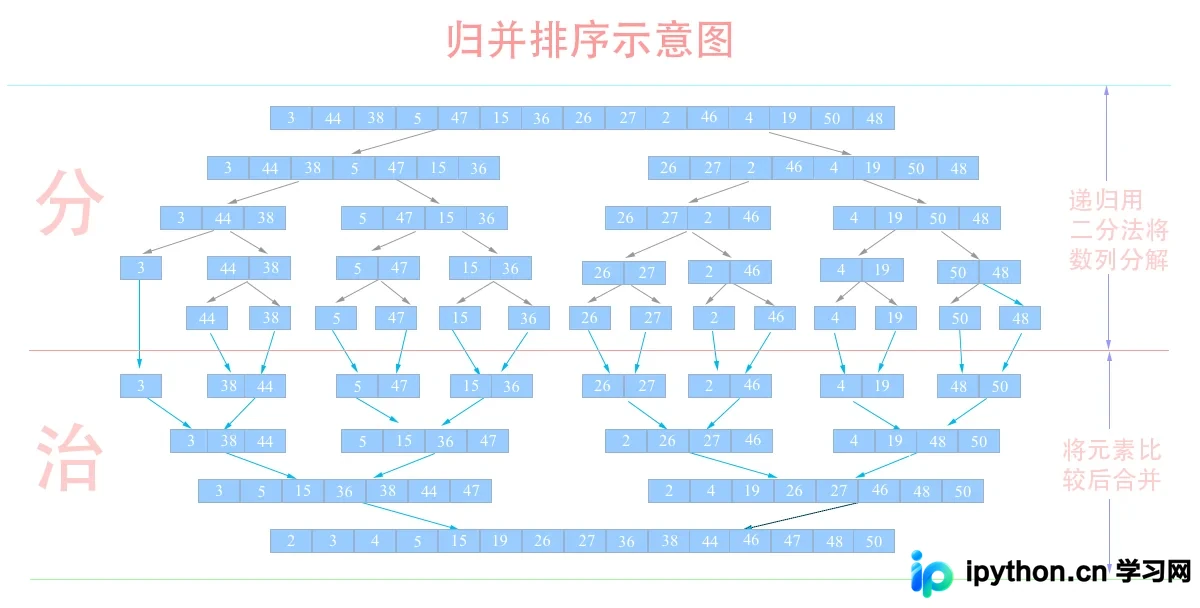
稳定性:快排属于不稳定排序。例如,当基准值前后存在与基准值相同的元素时,这些相同值的相对顺序可能会被打乱。比较性:由于排序过程中涉及元素间的比较,因此快排属于比较排序。时间复杂度:快排的时间复杂度为O(nlogn)。空间复杂度:排序时需要额外申请空间,且随着数列规模增大而增加,其复杂度为O(nlogn)。归并排序与快排的对比:两者均基于分治思想,但分解和合并策略不同。归并排序直接从中间将数列分为两部分,而快排通过比较将小元素放左、大元素放右。在合并阶段,归并排序需对两个子数列重新排序,而快排直接合并无需再次排序,因此快排在效率上通常高于归并排序,具体区别可参考示意图。
五、快排优化
快速排序的一个缺点是对小规模数据集的性能表现不佳。有人可能认为这一点可以忽略,因为大多数场景关注大规模数据的适应性。然而,快排采用分治技术,最终会将大数据集分解为小数据集进行处理。因此,在快排分解的最后几层,性能表现可能不理想。我们可以采取扬长避短的策略来优化快排:
首先使用快排对数据集进行排序,此时数据集已基本有序。当分区规模缩小到一定程度时,停止快排算法,转而使用插入排序。正如前文所述,插入排序在处理基本有序的数据集时具有接近线性的复杂度,性能更优。
实践证明,这一改进比持续使用快排算法更为有效。
六、模拟面试
面试官:你了解快排吗? 你:略知一二。 面试官:请讲讲快排的算法思想。 你:快排的基本思想是从数据集中选取一个基准,然后将数据集中的每个元素与基准值比较,小于基准值的元素放入左侧分区,大于基准值的元素放入右侧分区,最后以左右分区为新的数据集进行递归分区,直到只剩一个元素。 面试官:快排有哪些优缺点? 你:分治思想在处理大规模数据集时效果显著,但在小规模数据集上性能较差。 面试官:如何优化? 你:对大规模数据集使用快排,当分区规模达到一定小时,改用插入排序,因为插入排序在小数据规模下性能较好。 面试官:你能手写一个快排吗? 你:
七、总结
以上介绍了Python一行代码实现快速排序的方法,希望对大家有所帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家对本站的支持! 如果本文对您有帮助,欢迎转载,请注明出处,谢谢!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









