


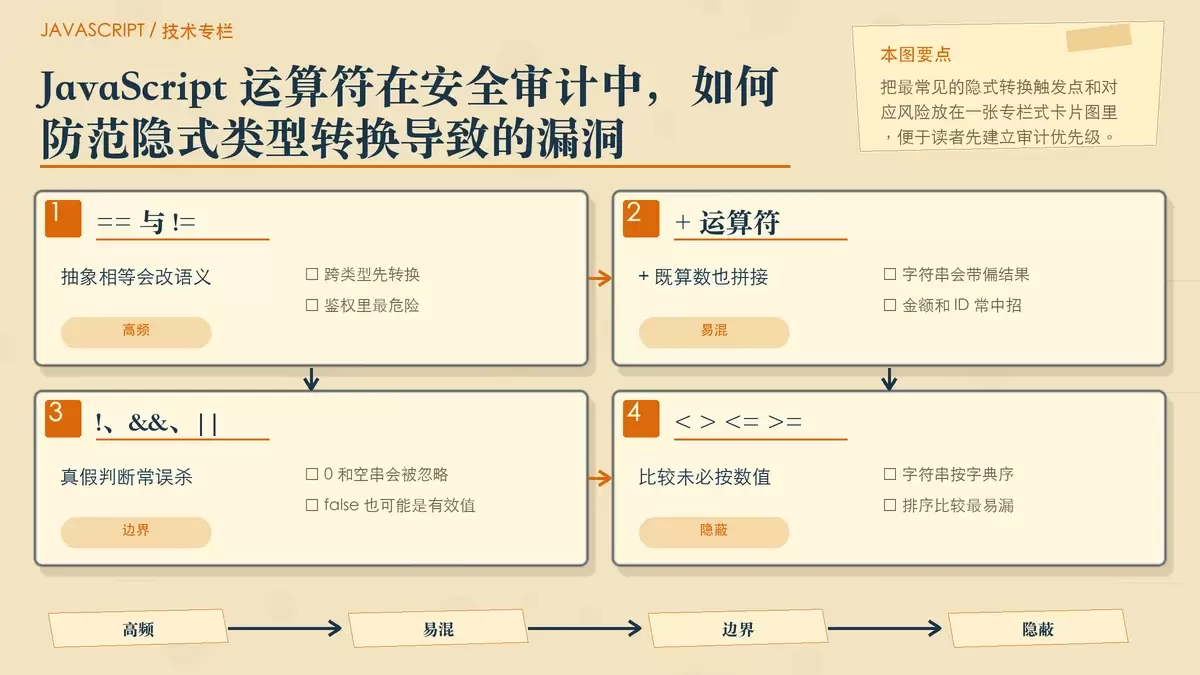
JavaScript 运算符触发的隐式类型转换,往往不是传统漏洞里那种注入或内存破坏问题,却会在业务逻辑最关键的位置制造偏差。真正麻烦的地方在于,这类问题通常藏在“代码能跑、测试也未必立刻报错”的路径里,直到它落到鉴权、计费、排序或输入校验上,才会演变成权限绕过、身份误判或规则失效。本文按审计视角梳理高危运算符、人工可执行的检查方法,以及更适合长期治理的工程化防线,帮助你判断哪些写法只是风格问题,哪些已经接近安全风险。
重点关注哪些运算符
在安全审计中,隐式类型转换的防范重点不是一刀切禁用运算符,而是识别那些最容易让比较语义、计算语义和布尔判断发生偏移的场景。真实业务里,以下几类运算符最值得优先排查。
== 和 != 为什么风险最高
== 和 != 使用的是抽象相等比较,会触发完整的 Abstract Equality Comparison 过程。只要比较两边类型不同,JavaScript 就可能先做转换,再给出结果。问题不在于“它能比较”,而在于比较结果经常不是代码阅读者以为的那个结果。
例如下面这类代码,在鉴权或角色判断中就很危险:
userRole == "admin"如果变量来源并不稳定,可能来自接口、表单、缓存或历史序列化逻辑,那么跨类型比较就容易把本该严格区分的值混在一起。审计时,凡是看到 ==、!= 出现在登录态、权限、配置开关、状态机判断中,都应该优先确认是否存在“先转换后比较”的隐患。
+ 运算符什么时候会污染业务语义
+ 在 JavaScript 里既能做数值运算,也能做字符串拼接。只要任一操作数是字符串,表达式就会偏向拼接语义,这也是审计中最常见、最隐蔽的一类问题。
典型场景包括:
- 金额计算:
"19.99" + 1 -> "19.991" - ID 拼接:
id + "_cache",但id实际为null,结果变成"null_cache"
这类问题一旦进入金额、库存、缓存键、资源定位符等上下文,后果往往不是简单的显示错误,而是数据写错位置、校验被绕开,或者后续逻辑基于错误值继续执行。
!、&&、|| 的问题不在变值,而在真假判断
!、&&、|| 本身不一定直接改写原值,但它们依赖 ToBoolean 规则决定分支是否成立。审计里要特别注意“裸变量判断”,也就是直接拿变量做条件判断的写法。
例如:
if (input)这样的代码会把 0、""、false 都视为假值。如果业务上这些值本来就是合法输入,比如价格可以为 0、开关状态可以为 false、空字符串代表“主动清空备注”,那么条件判断就会把合法边界值误判成“没有输入”。这种误判在表单校验、权限配置、特性开关、筛选条件里都很常见。
关系运算符为什么会在排序和比较里埋雷
<、>、<=、>= 在字符串和数字混用时,很容易出现与业务直觉不一致的结果。比如:
"10" < "2" === true这是因为它按字典序比较,而不是按数值大小比较。只要代码里有版本号、时间戳、权限等级、分页游标或数值排序相关逻辑,这类比较都值得单独确认类型是否已经统一。
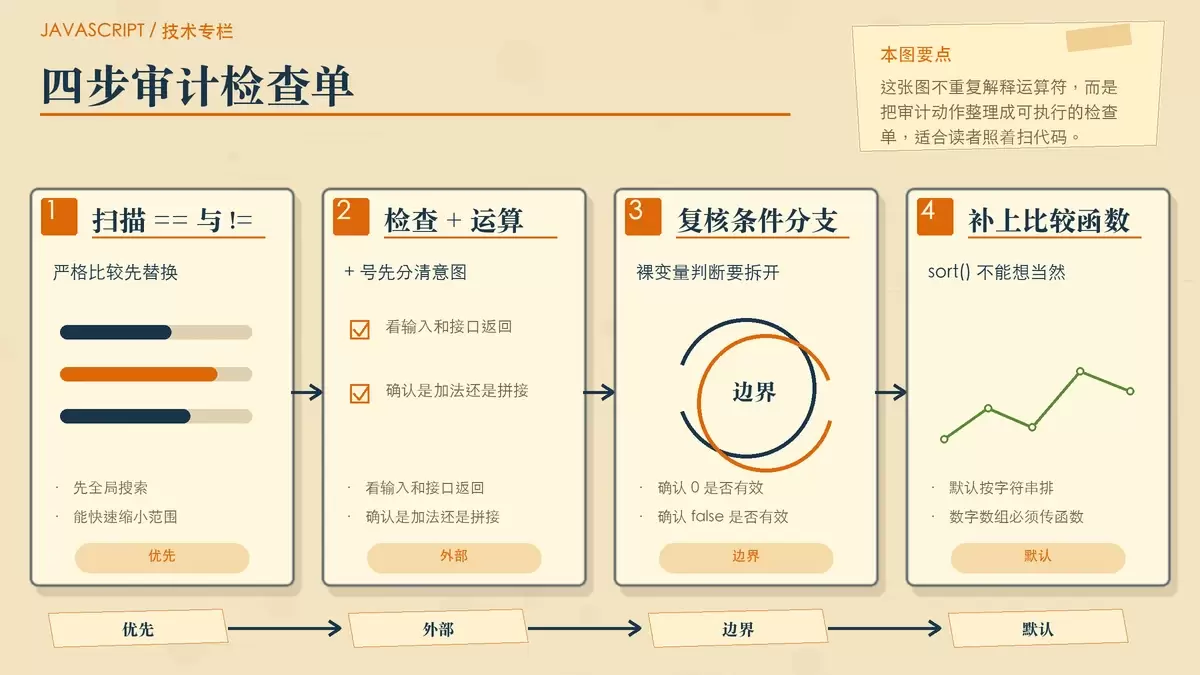
审计时可以直接执行的检查清单
这类问题并不一定要依赖复杂工具,很多风险用人工走查或简单搜索就能覆盖大部分。对审计人员来说,关键是按高频触发点逐项排查,而不是零散地看代码风格。
先搜索所有 == 和 !=
第一步通常最有效:全局搜索 == 和 !=。绝大多数业务代码里,它们都应该替换为 === 或 !==。
如果确实需要跨类型比较,比如后端返回字符串 ID,而本地是数字 ID,也不要直接依赖抽象比较,应该先显式转换,再做严格判断:
String(idFromAPI) === String(localId)这样做的价值在于,比较语义被固定下来,后续阅读代码的人也能明确知道“这是有意统一类型”,而不是碰运气让引擎帮你做转换。
检查所有与外部数据相关的 + 运算
凡是涉及用户输入、API 响应、localStorage 数据的 +,都应该确认开发者的真实意图到底是“加法”还是“拼接”。
如果本意是数值计算,应该在进入表达式前显式转换:
Number(value)或者:
+value如果本意是字符串拼接,建议统一改用模板字面量,让表达意图更直接:
`prefix-${value}`这一步尤其适合排查金额、库存、数量、订单号、缓存键和路径构造,因为这些地方一旦混入错误类型,影响范围往往会顺着数据链一路扩散。
审查条件判断里的裸变量
看到 if (x)、x ? a : b 这类写法时,不要只问“能不能运行”,而要问“x 可能出现哪些合法值”。如果 x 可能为 0、""、false,并且这些值在业务上是有效状态,那么裸判断就不可靠。
更稳妥的做法是把判定条件写清楚,例如:
x != null && x !== ""或者:
typeof x === "number" && !isNaN(x)前者适合判空,后者适合确保数值有效。审计时,凡是参数校验、表单提交、开关控制、额度判断里出现裸变量,都应该逐个确认。
不要漏掉默认 sort()
sort() 是另一个容易被忽视的入口。JavaScript 默认按字符串排序,数字数组如果没有传入比较函数,就可能得到完全错误的顺序。
例如:
[10, 2, 1].sort((a, b) => a - b)这类问题看上去更像业务 bug,但一旦排序结果参与权限优先级、时间比较、版本选择或额度规则判断,就可能进一步放大成安全问题。
把防御措施放进工程流程
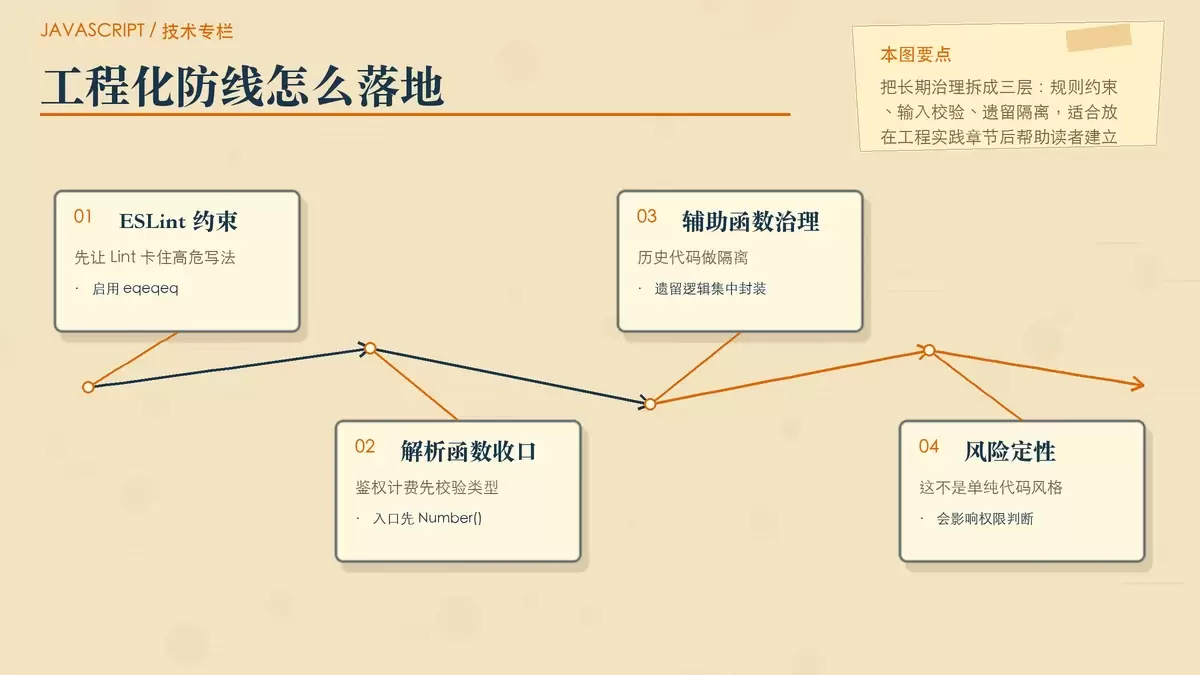
如果只靠人工审计,这类风险很难长期收敛。更现实的做法,是把隐式转换的控制前移到开发流程里,让问题在提交代码阶段就尽量暴露出来。
先用 ESLint 卡住高危写法
对大多数前端或 Node.js 项目,Lint 规则是最直接的第一道防线。至少应考虑启用以下规则:
eqeqeq:禁止==no-implicit-coercion:禁止value + ""、!!value等模糊转换no-mixed-operators:减少+与其他算术符混用带来的歧义
这些规则的价值不只是“统一风格”,更重要的是把易误判的表达式尽早拦在代码评审之前。
关键模块必须先过类型校验
鉴权、计费、配置这类关键模块,不应该让原始输入直接进入业务逻辑。更稳妥的方式是统一经过解析函数,把“类型合法”和“业务可接受”两层约束放在入口处。
例如金额处理函数可以写成:
function parseAmount(input) { const n = Number(input); return isFinite(n) && n >= 0 ? n : null; }这样做的关键在于,后续逻辑只处理已经验证过的值,而不是边计算边猜测输入类型。对于安全敏感模块,这比在每个调用点零散补判断要可靠得多。
历史代码要做“转换隔离”
很多项目里,隐式转换问题集中在历史遗留代码,不可能一次性全部改完。这时可以先做“转换隔离”:把确实存在的类型兼容逻辑收口到带注释的辅助函数中,例如 coerceToNumber(str)。
同时可以在函数内部增加异常输入观测,比如 console.warn 或 Sentry 上报,逐步统计哪些来源仍然在喂入不稳定类型。这样做不是纵容隐式转换,而是给历史系统一个可治理的过渡带。
为什么它是安全问题,而不只是代码规范
很多团队把隐式类型转换理解成“写法不够严谨”,但在安全审计里,它的本质是可被利用的逻辑偏差。只要攻击者能控制输入格式,或者能利用系统在序列化、反序列化、缓存、接口返回中的类型不一致,这类偏差就可能变成真正的攻击面。
鉴权场景里的误判会直接影响权限
例如登录态或角色判断中,如果存在类似:
if (user.role == "admin")那么问题就不只是“比较不够严格”,而是角色来源一旦混乱,整个权限判断都可能建立在错误前提上。原文提到,像 role: "0" 或 role: [] 这类边界数据,就可能在复杂序列化路径中制造歧义;例如 [] == "0" 为 false,但 [] == 0 为 true。只要上下游对类型的理解不一致,攻击者就有机会利用这个缝隙。
计费和额度控制最怕输入类型漂移
支付、充值、优惠额度等逻辑,对输入格式尤其敏感。如果金额字段没有先做明确类型校验,攻击者就可能提交看起来“像字符串、也能被解析”的值。
例如:
{"amount": "100.00e1"}在 JavaScript 里,这可能被解析为 1000。如果前端或中间层的限制规则只是按表面格式理解这个字段,就会出现校验与实际计算不一致的问题,进而让金额限制被绕过。
位运算和字符串混用会把权限计算带偏
权限位掩码、标志位合并这类场景,本来就依赖精确的数值语义。一旦输入来源不是纯数字,而是字符串,例如 "1",整个表达式的结果就可能偏离设计预期。
原文指出,在权限位掩码计算中使用 | 时,如果上游数据类型不稳定,就可能导致权限误开。审计时,这类代码需要结合输入来源一起看,不能只盯着当前这一行运算符是否“看起来没错”。
审计落点:先统一类型,再谈比较和计算
回到实务层面,JavaScript 隐式类型转换的风险并不神秘,核心就是避免把“不确定类型”直接送进比较、计算和条件分支。审计时优先抓 ==、!=、+、裸变量判断、关系比较和默认 sort();整改时优先做显式转换、入口校验和规则约束。
当一段代码同时具备三种特征时,就要提高警惕:输入来自外部、运算符会触发类型转换、执行结果又影响权限或金额。到了这一步,它已经不是单纯的编码风格问题,而是应当纳入安全审计清单的逻辑漏洞风险。









