


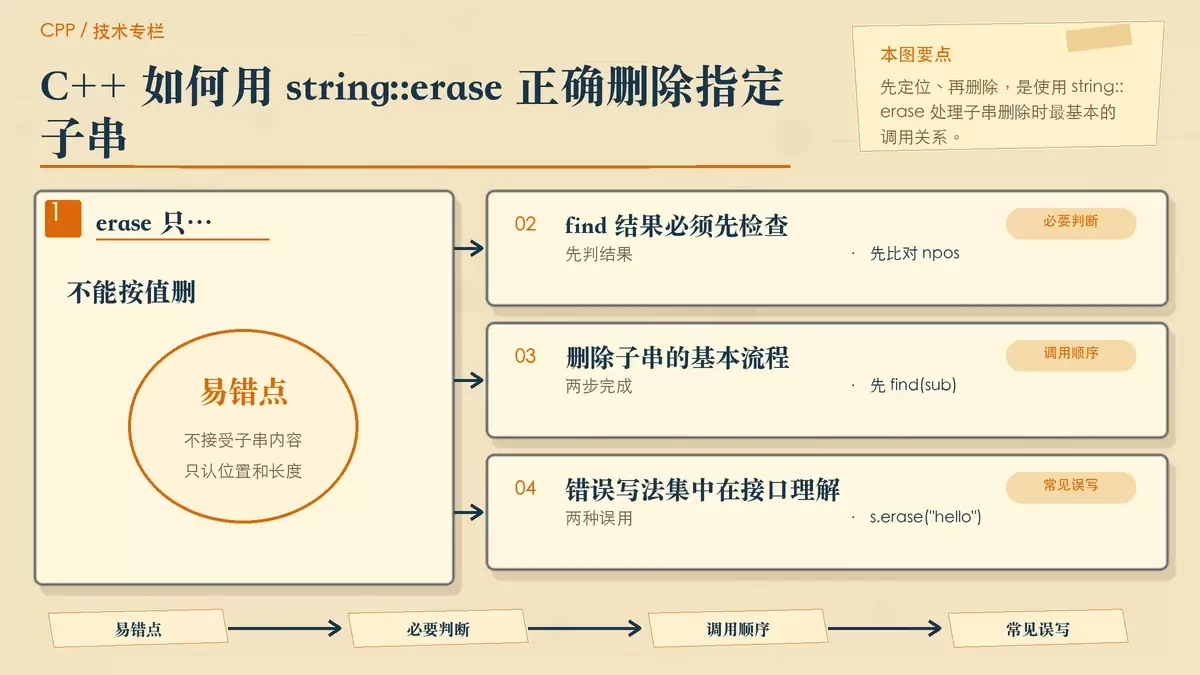
很多人第一次处理 C++ 字符串删除时,都会下意识去写“按内容删子串”,但 std::string::erase 本身并不提供这种接口。真正稳妥的写法,是先用 find 找到位置,再根据长度调用 erase(pos, len);删一个和删全部,索引处理方式也完全不同。本文按实际使用场景拆开说明,顺带把 npos、重叠匹配、单参数 erase 等几个容易踩坑的点一次讲透,方便你判断什么时候该继续用 erase,什么时候该换思路。
string::erase 为什么不能直接按子串删除
string::erase 只认识“位置”和“长度”,并不认识“要删除的内容”。也就是说,它不能像很多人想象的那样,直接把 "hello" 从 "say hello world" 里按值删掉。
因此,类似下面这种写法都不可靠:
s.erase("hello"):接口不匹配,编译就过不了s.erase(s.find("hello")):即使能编译,也有明显风险,因为一旦find返回string::npos,再把它直接传给erase,就可能触发越界问题
这里先记住三个判断标准:
- 必须先检查
find的结果是否等于string::npos - 删除长度要和目标子串一致,通常直接写成
sub.length()或sub.size() - 如果字符串里有多个匹配项,
find只会返回第一个位置;要删全部,必须循环处理
只删除第一个匹配子串,怎么写最稳妥
如果需求只是“找到后删掉第一个匹配项”,写法其实很固定,核心就是先查找、再判断、再删除:
size_t pos = s.find(sub);
if (pos != string::npos) {
s.erase(pos, sub.length());
}
这段代码短,但有几个细节不能省:
1. 删除长度不要硬编码
sub.length() 必须和要删掉的那段内容保持一致。你也可以写 sub.size(),但不要把长度写死成数字,比如用 5 代替 sub.length()。一旦后面换了子串,代码就会悄悄出错。
2. 别误用单参数 erase
s.erase(pos) 是另一个常见误区。这个重载的含义不是“从这里删一个子串”,而是“从 pos 一直删到字符串末尾”。如果你只是想删掉匹配到的那一段,必须传入长度参数。
3. 空子串不会报错,但通常没有意义
如果 sub 是空字符串,find 会返回 0,而 erase(0, 0) 是合法的,只是不会产生任何效果。这不一定算 bug,但在业务逻辑里通常说明你传入了不该为空的删除条件。
删除所有匹配项时,重点是索引不要走错
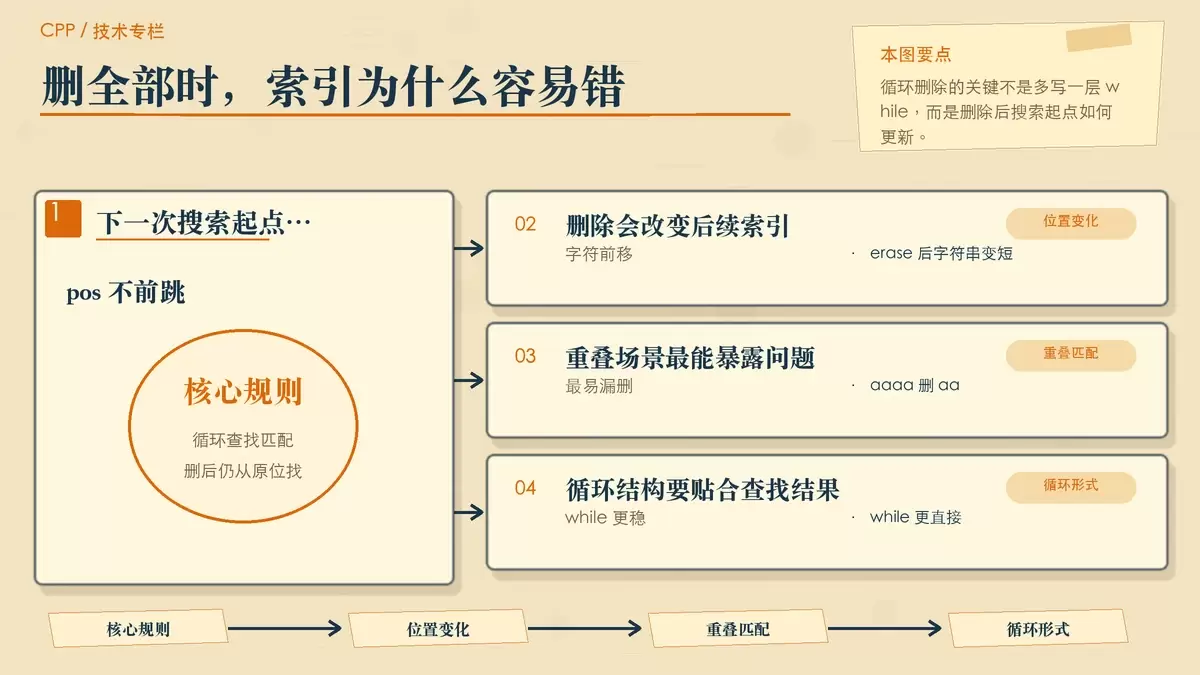
比起删第一个,循环删除全部匹配项才是更容易出错的地方。原因很简单:每执行一次 erase,字符串都会变短,后面的字符位置也会整体前移。如果你还按删除前的索引继续找,就容易漏删,严重时甚至会访问错误位置。
更稳妥的写法如下:
size_t pos = 0;
while ((pos = s.find(sub, pos)) != string::npos) {
s.erase(pos, sub.length());
// 不加 pos += sub.length() —— 否则可能跳过重叠匹配,如删 "aa" 中的 "a"
}
为什么删除后还从 pos 继续找
关键就在这里:删掉一段内容之后,原来排在后面的字符会向前移动,因此下一次搜索起点仍然应该放在当前的 pos。如果你直接写成 pos + sub.length(),等于跳过了一段已经前移过来的内容。
重叠匹配时尤其容易漏删
例如在 "aaaa" 中删除 "aa",或者在 "aa" 中删除 "a",都可能涉及重叠或连续匹配。上面这类“删完仍从当前位置继续找”的写法,才能把结果清干净。要是加上 pos += sub.length(),很可能只删掉一部分。
什么时候可以手动前移
如果你能非常确定业务场景中不存在重叠匹配,并且确实想少做一点重复扫描,那么可以在删除后写 pos += sub.length()。但这个前提必须明确成立,否则可读性和正确性都不划算。
另外,这类场景用 while 通常比 for 更顺手,因为 pos 的更新完全依赖查找结果,放在循环头里更不容易写乱。
replace 能不能替代 erase,以及什么时候该换思路
有些人更习惯把“删除子串”写成“替换为空字符串”,例如:
s.replace(pos, sub.length(), "")
这种写法在语义上更接近“把这一段换成空”,阅读时确实更直观一些。但从效果上看,它和 erase 本质相同,底层都要移动后续字符,性能差异通常可以忽略。
几个边界点也值得单独说明:
- 如果删除的是固定字面量,比如
"n",直接写s.erase(s.find("n"), 1)会更轻量 - Boost 里的
erase_all,以及 C++20 的std::erase,不要和std::string的子串删除混为一谈;它们适用的对象和语义并不一样 - 无论是
erase还是replace,频繁操作超长字符串时都会产生明显的内存移动成本
这也是为什么在 MB 级字符串上反复删除时,程序常会出现肉眼可见的卡顿。真遇到这种场景,通常就不该继续执着于“原地擦除”本身,而是应该考虑用 std::string_view 做逻辑切分,或者调整算法,尽量避开反复移动整段内存。
实际使用时,可以直接按这套判断
- 删一个匹配项:
find+ 判空 +erase(pos, sub.length()) - 删全部匹配项:用
while循环查找,删除后继续从当前pos开始搜索 - 担心可读性:可以改写成
replace(..., ""),但不要期待性能本质变化 - 字符串特别大、删除特别频繁:优先怀疑算法和数据处理方式,而不是纠结
erase还是replace
归根结底,string::erase 不是不能删子串,而是它从设计上就要求你先把“删哪里、删多长”这两个问题说明白。只要把位置判断和索引更新处理对,删除子串这件事其实并不复杂。









