


自制机械臂要想顺畅接收网页控制指令,蓝牙链路不能只“能用”,还得足够轻、足够快。这次改动的核心,不是继续给 ESP32 叠复杂机制,而是回到实际需求:网页发指令,单片机解析后转成电机帧并发送。文章会按问题现象、代码删改点和性能提升路径展开,帮助你判断这些优化是否也适合自己的 BLE 控制项目。
优化后达到了什么效果
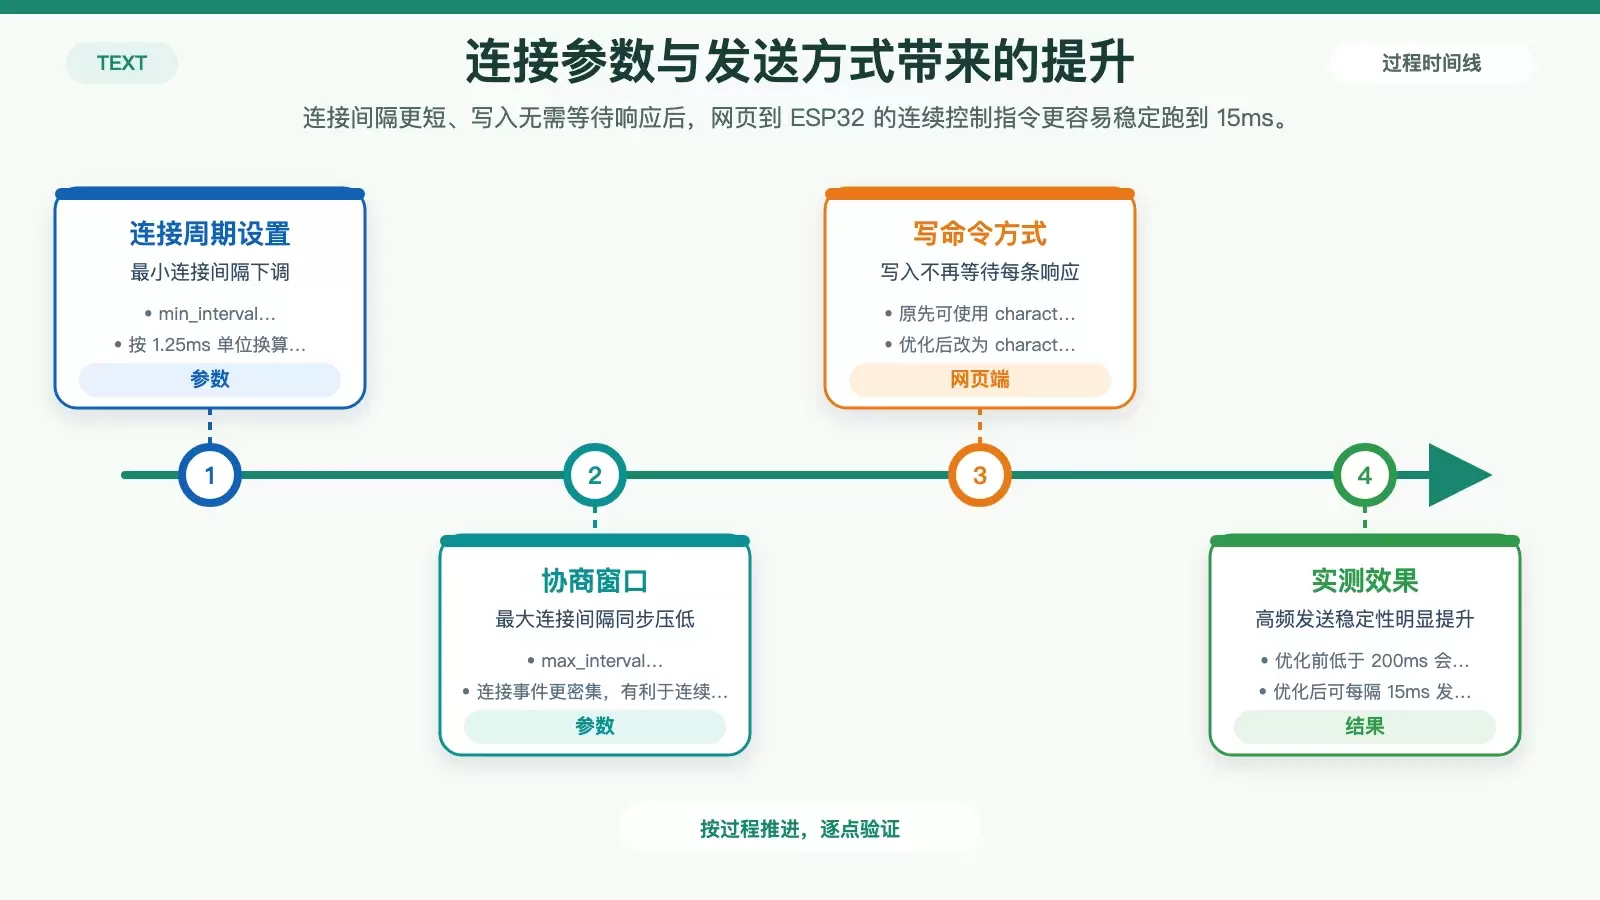
先看结果。修改之后,网页端现在可以每隔 15ms 向单片机发送一条蓝牙消息,而不会再出现阻塞;优化之前,只要发送间隔低于 200ms,就容易报错。
换算下来,当前链路大约能做到每秒 66 条消息。对于后续准备引入贝塞尔曲线来优化机械臂电机运动姿态的场景,这个吞吐量已经基本够用。
核心改动:把写事件处理缩到最小闭环
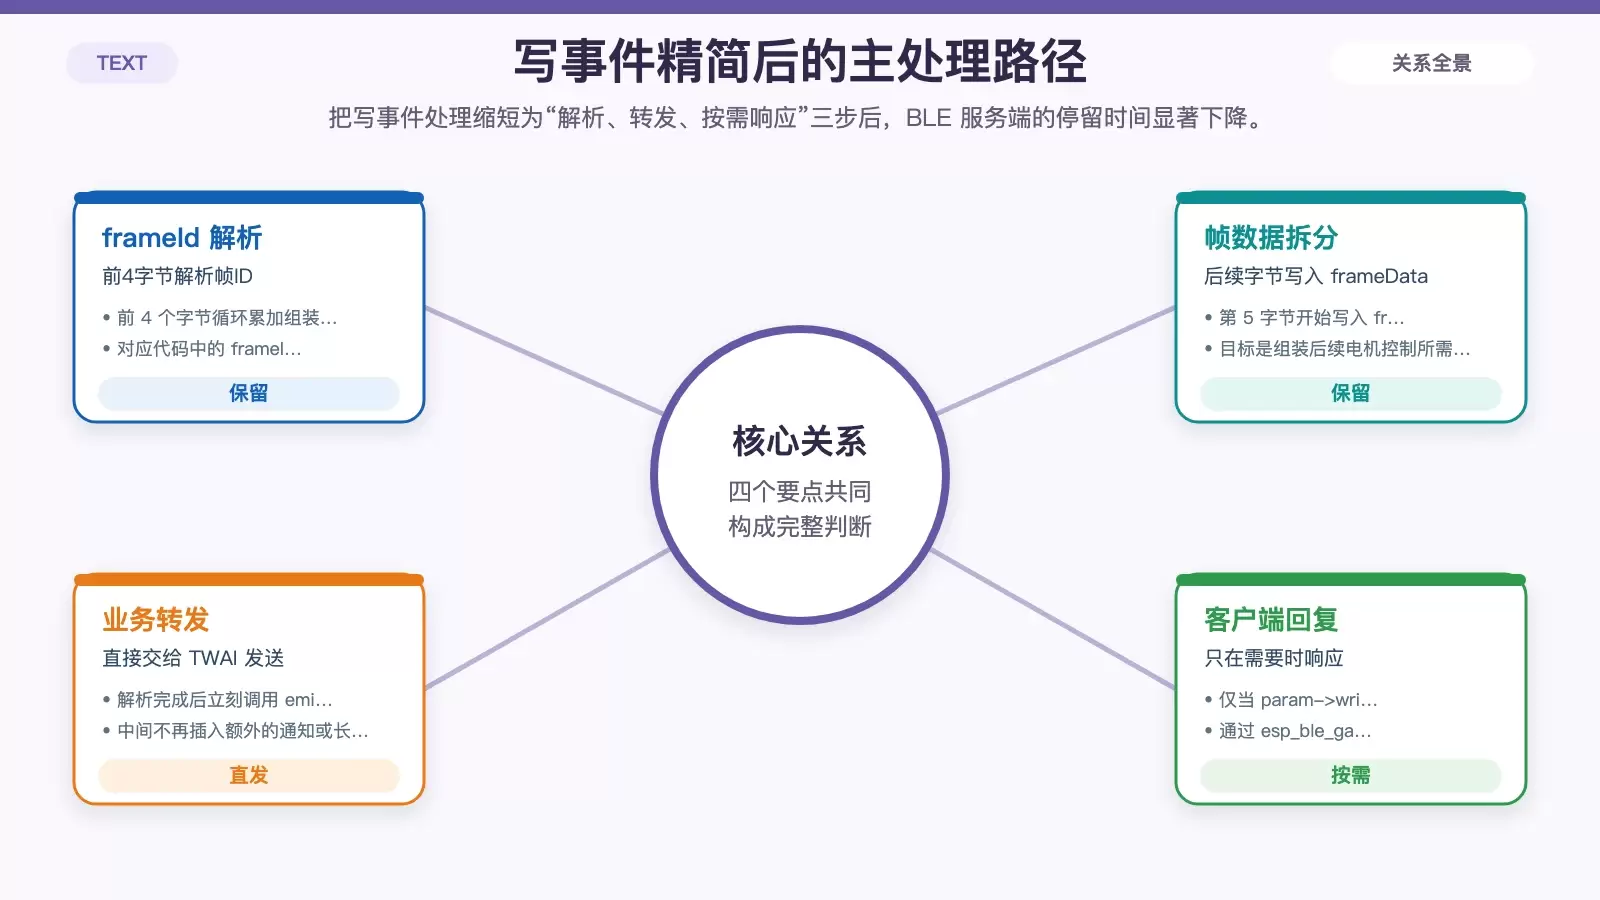
这次优化最关键的地方,是重新梳理 ESP_GATTS_WRITE_EVT 的处理逻辑。目标很明确:收到网页传来的字节流后,只做当前业务真正需要的事,即解析出帧 ID 与帧数据,然后交给 TWAI 发送。
修改后的主逻辑如下:
case ESP_GATTS_WRITE_EVT: {
        //ESP_LOGI(GATTS_TAG, "蓝牙写入事件 GATT_WRITE_EVT, conn_id %d, trans_id %" PRIu32 ", handle %d", param->write.conn_id, param->write.trans_id, param->write.handle);
        esp_gatt_status_t status = ESP_GATT_OK;

        //ESP_LOGW(GATTS_TAG, "GATT_WRITE_EVT, value len %d, value :", param->write.len);
        //esp_log_buffer_hex(GATTS_TAG, param->write.value, param->write.len);

        // 将接收到的蓝牙数据做处理,提取出想要格式的帧id和帧数据
        unsigned int frameId = 0;
        int frameData[8];
        for(int i = 0; i < param->write.len; i++) {
          // printf("遍历蓝牙%d值: %d", i, param->write.value[i]);
          if(i < 4) {
            frameId = frameId * 16 * 16 + param->write.value[i];
            // ESP_LOGI(GATTS_TAG, "----蓝牙 16进制 转换帧id:  %u", frameId);
          }else {
            frameData[i - 4] = param->write.value[i];
          }
        }
       // printf("frameId%u值: %d, --- %d  n", frameId, frameData[0], frameData[7]);

        // ESP_LOGI(EXAMPLE_TAG, "-----发送can数据指令------");
        emitMsg(frameId, frameData);
        // ESP_LOGI(EXAMPLE_TAG, "-----发送can数据指令结束-----");

        // 客户端的请求是需要需要回复时候
        if(param->write.need_rsp) {
          esp_ble_gatts_send_response(gatts_if, param->write.conn_id, param->write.trans_id, status, NULL);
        }
        break;
这段代码做的事情可以拆成三步:
1. 从写入数据中拆出 frameId 和 frameData
前 4 个字节用于组装帧 ID,后续字节写入 frameData[8]。也就是说,蓝牙层在这里不承担过多协议职责,只负责把网页侧传来的数据整理成后续总线发送所需的格式。
2. 直接调用发送函数
整理完数据后,马上执行 emitMsg(frameId, frameData);,把消息交给 TWAI 发送。原作者提到,这一层未来也许可以继续用观察者模式再做解耦,但当前目标是先把路径缩短,减少写事件中的停留时间。
3. 仅在需要时回复客户端
如果 param->write.need_rsp 为真,再调用 esp_ble_gatts_send_response。这一点很重要,因为写事件里任何额外处理,都会直接占用 BLE 服务端的执行时间。
原来为什么会报错:两个典型问题的定位思路
优化前,蓝牙部分主要有两个明显问题:
- 单片机会频繁报错:
BTC stack overflow。 - 蓝牙发送速度稍快,就会出现阻塞报错。
什么是 BTC
文中引用了 ESP32 蓝牙架构 的说明:
BTC 层主要负责向应⽤层提供接⼝⽀持、处理基于 GATT 的规范、处理杂项等,并向应⽤层提供以“esp”为前缀的接⼝。所有的 API 都在 ESP_API 层,开发者应当使⽤“esp”为前缀的蓝牙 API(特殊的除外)。
简单理解,BTC 就是蓝牙控制路径里承接应用调用的重要一层。开发者平时配置广播、连接、服务和特征,背后都会经过这一层处理。因此,写事件逻辑太重、调用链太长,就更容易把这里拖慢,甚至引发栈溢出。
问题一:BTC stack overflow
这个问题大致有两类处理方式。
第一类是增大相关内存分配,这能缓解,但通常只是把问题往后拖,并没有改变代码路径过长、处理过重的根因。
第二类就是回头检查自己的蓝牙业务逻辑,看看是不是在官方示例基础上保留了并不需要的处理分支。本文最终采用的是这一条路线,优化后已经不再出现蓝牙栈溢出。
问题二:高频发送时阻塞
从报错现象看,核心原因是上一条蓝牙请求还没有处理完,下一条请求就已经到达,结果后续写入被阻塞。
这个问题的定位方法也很直接:检查蓝牙服务端代码,找出哪些逻辑占用了写事件的处理时间。作者对照示例项目 README 后发现,问题并不在“蓝牙本身不够快”,而在于原代码里保留了不少当前项目根本用不上的通用处理。
删掉哪些示例逻辑,为什么能提速
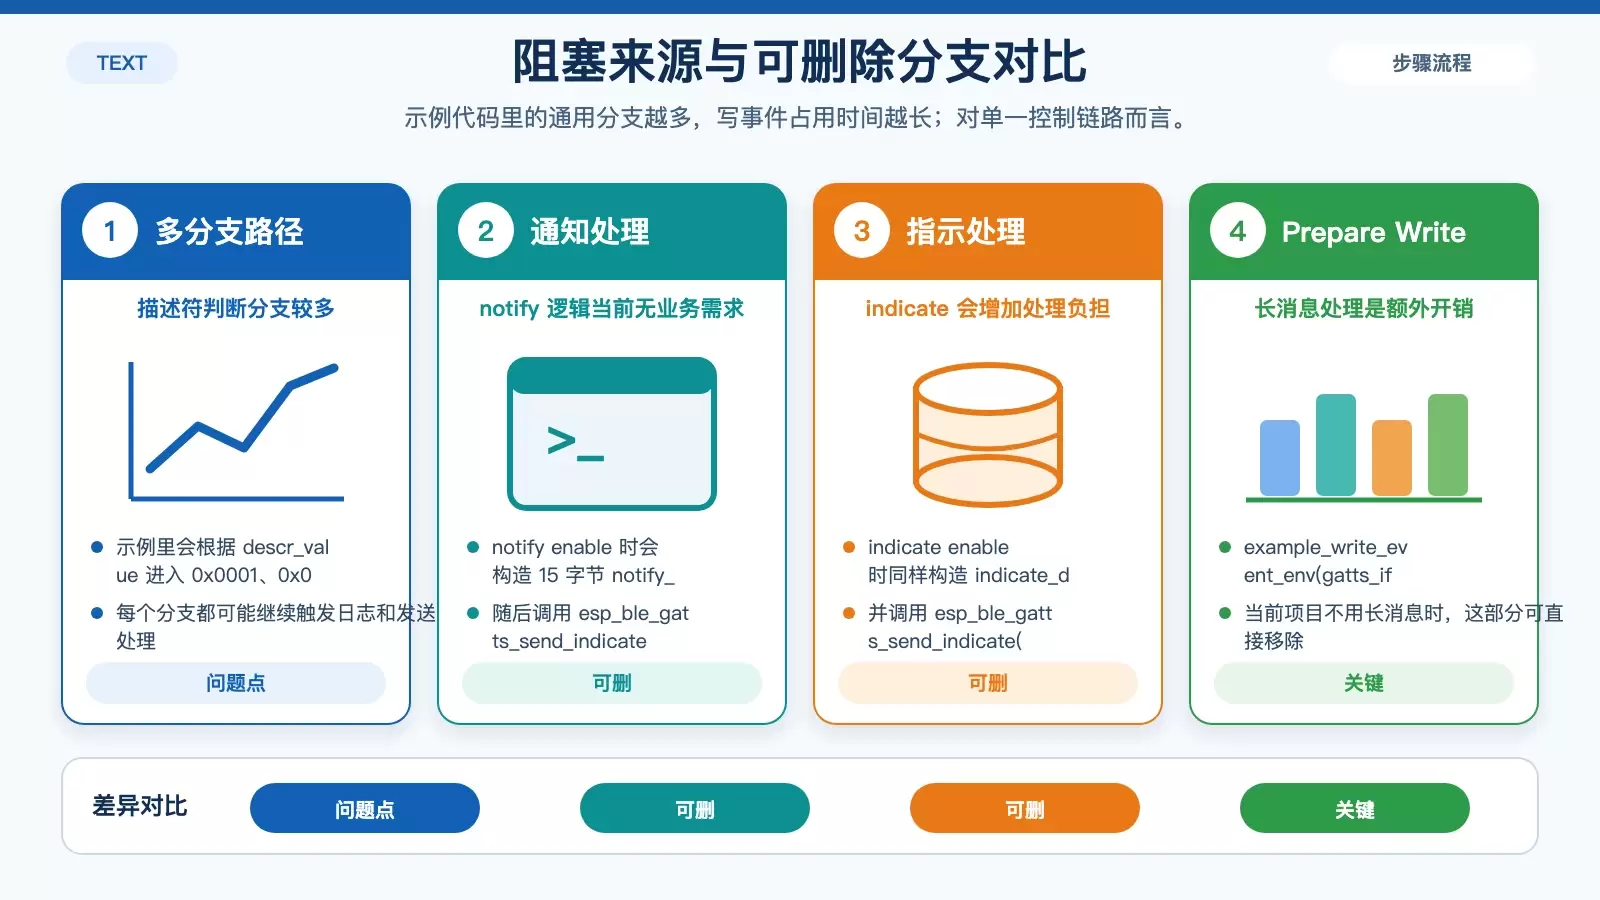
原始示例的 ESP_GATTS_WRITE_EVT 处理相对完整,适合教学或通用 GATT Server 场景,但放在“网页控制机械臂”这个单一链路里,就显得偏重了。
原代码中包含了如下这类逻辑:
case ESP_GATTS_WRITE_EVT: {
    ESP_LOGI(GATTS_TAG, "GATT_WRITE_EVT, conn_id %d, trans_id %" PRIu32 ", handle %d", param->write.conn_id, param->write.trans_id, param->write.handle);
    if (!param->write.is_prep){
        ESP_LOGI(GATTS_TAG, "GATT_WRITE_EVT, value len %d, value :", param->write.len);
        esp_log_buffer_hex(GATTS_TAG, param->write.value, param->write.len);
        if (gl_profile_tab[PROFILE_A_APP_ID].descr_handle == param->write.handle && param->write.len == 2){
            uint16_t descr_value = param->write.value[1]<<8 | param->write.value[0];
            if (descr_value == 0x0001){
                if (a_property & ESP_GATT_CHAR_PROP_BIT_NOTIFY){
                    ESP_LOGI(GATTS_TAG, "notify enable");
                    uint8_t notify_data[15];
                    for (int i = 0; i < sizeof(notify_data); ++i)
                    {
                        notify_data[i] = i%0xff;
                    }
                    //the size of notify_data[] need less than MTU size
                    esp_ble_gatts_send_indicate(gatts_if, param->write.conn_id, gl_profile_tab[PROFILE_A_APP_ID].char_handle,
                                            sizeof(notify_data), notify_data, false);
                }
            }else if (descr_value == 0x0002){
                if (a_property & ESP_GATT_CHAR_PROP_BIT_INDICATE){
                    ESP_LOGI(GATTS_TAG, "indicate enable");
                    uint8_t indicate_data[15];
                    for (int i = 0; i < sizeof(indicate_data); ++i)
                    {
                        indicate_data[i] = i%0xff;
                    }
                    //the size of indicate_data[] need less than MTU size
                    esp_ble_gatts_send_indicate(gatts_if, param->write.conn_id, gl_profile_tab[PROFILE_A_APP_ID].char_handle,
                                            sizeof(indicate_data), indicate_data, true);
                }
            }
            else if (descr_value == 0x0000){
                ESP_LOGI(GATTS_TAG, "notify/indicate disable ");
            }else{
                ESP_LOGE(GATTS_TAG, "unknown descr value");
                esp_log_buffer_hex(GATTS_TAG, param->write.value, param->write.len);
            }

        }
    }
    example_write_event_env(gatts_if, &a_prepare_write_env, param);
    break;
}
这部分多做了什么
可以看到,示例代码里处理了 notify、indicate、描述符写入状态切换,以及 example_write_event_env(gatts_if, &a_prepare_write_env, param); 这种长消息准备写入流程。
这些逻辑本身没有问题,但前提是你的项目确实要用到它们。如果当前蓝牙职责只是“网页发一段控制数据,ESP32 收到后立刻解析并转发”,那这部分处理就会变成额外负担。
为什么删除后更稳定
原因很简单:写事件回调是高频入口,里面做的每一步都在累计延迟。把不需要的通知、指示、长消息处理和日志输出删掉后,服务端处理一条写请求的时间明显缩短,后续请求自然更不容易排队阻塞。
作者的结论也很明确:example_write_event_env(gatts_if, &a_prepare_write_env, param); 这类用于长消息的处理,如果业务根本不用长消息,直接删除即可。
进一步提升吞吐:连接周期和写入方式一起调
在精简服务端逻辑之外,文中还做了两项直接影响吞吐的调整。
1. 降低蓝牙连接间隔
连接参数改动如下:
  // 从机连接的最小连接间隔 0x0006 * 1.25ms = 7.5ms    slave connection min interval, Time = min_interval * 1.25 msec
    .min_interval = 0x0006,
    // 从机连接的最大连接间隔 0x0010 * 1.25ms = 16 * 1.25 = 20ms   slave connection max interval, Time = max_interval * 1.25 msec
    .max_interval = 0x000A,
这里的含义是,把 BLE 连接事件之间的等待时间压低,让主从设备有更高频率交换数据。文中原注释里保留了时间换算方式:连接间隔单位是 1.25ms,因此 0x0006 对应 7.5ms。
对于这类需要连续控制电机姿态的场景,较短的连接间隔通常更有利于提高指令发送密度。不过连接参数是否最终生效,也仍受主设备和系统蓝牙栈协商结果影响。
2. 改用 writeValueWithoutResponse
网页端原先如果直接调用 characteristic.writeValue,通常要等待蓝牙响应返回;而在高频写入场景里,这个等待会显著拉低吞吐。
改成 characteristic.writeValueWithoutResponse 后,发送端不再等待每条消息的应答,更适合这种单向、连续、低负载的控制指令写入。
对应代码如下:
function rotateMotor({motorId, limit_spd, loc_ref}) {
  // motorId, limit_spd;
  // let a =  loc_ref * 0.017;
  // debugger;
  let rad = loc_ref * Math.PI / 180
  // let cmdArr = Loc_Director({motorId, limit_spd, loc_ref: loc_ref * 0.017});
  let cmdArr = Loc_Director({motorId, limit_spd, loc_ref: rad});
  console.log('---cmdArr: ', cmdArr);
  for(let i = 0; i < cmdArr.length; i++) {
    setTimeout(() => {
      try {
        // BleCharacteristic.writeValue(cmdArr[i]);
        BleCharacteristic.writeValueWithoutResponse(cmdArr[i]);
        console.log("---指令发送成功---", cmdArr[i]);
        recordCmd.value.push({type: 'send', data: cmdArr[i], status: 'success'});
      } catch (error) {
        console.log("---指令发送失败---", cmdArr[i]);
        recordCmd.value.push({type: 'send', data: cmdArr[i], status: 'fail'});
      }
    }, 15);
  }
}
这段实现还有两个值得注意的点:
- 发送前先把角度
loc_ref转成弧度rad,再传给Loc_Director生成指令数组。 - 通过
setTimeout(..., 15)控制发送节奏,与前面实测的 15ms 稳定间隔相对应。
文中没有给出更完整的基准测试,因此“具体能提升多少性能”仍未量化到更细的指标;但从现象上看,服务端简化和无响应写入叠加后,已经足以解决此前的阻塞问题。









