


累计总额看起来只是“把前面的值不断加起来”,真正落到 SQL 查询时,难点其实在两个地方:一是结果必须保留每一行,二是累加顺序必须稳定可复现。只要把这两点想清楚,就能判断什么时候该用窗口函数,什么时候即便语法能跑,结果也未必可信。
下面按“能不能用 GROUP BY、基础写法怎么写、排序为什么会出错、数据量大时怎么避免变慢”四个问题来拆开说明,方便你直接套到日常报表和明细统计里。
什么是累计总额,为什么不能用 GROUP BY
累计总额(running total),就是按照某个字段定义的顺序,逐行把当前值累加起来,得到“截至当前这一行”为止的总和。典型场景是按日期累计销售额、按流水号累计收入,或者按事件时间累计用户操作次数。
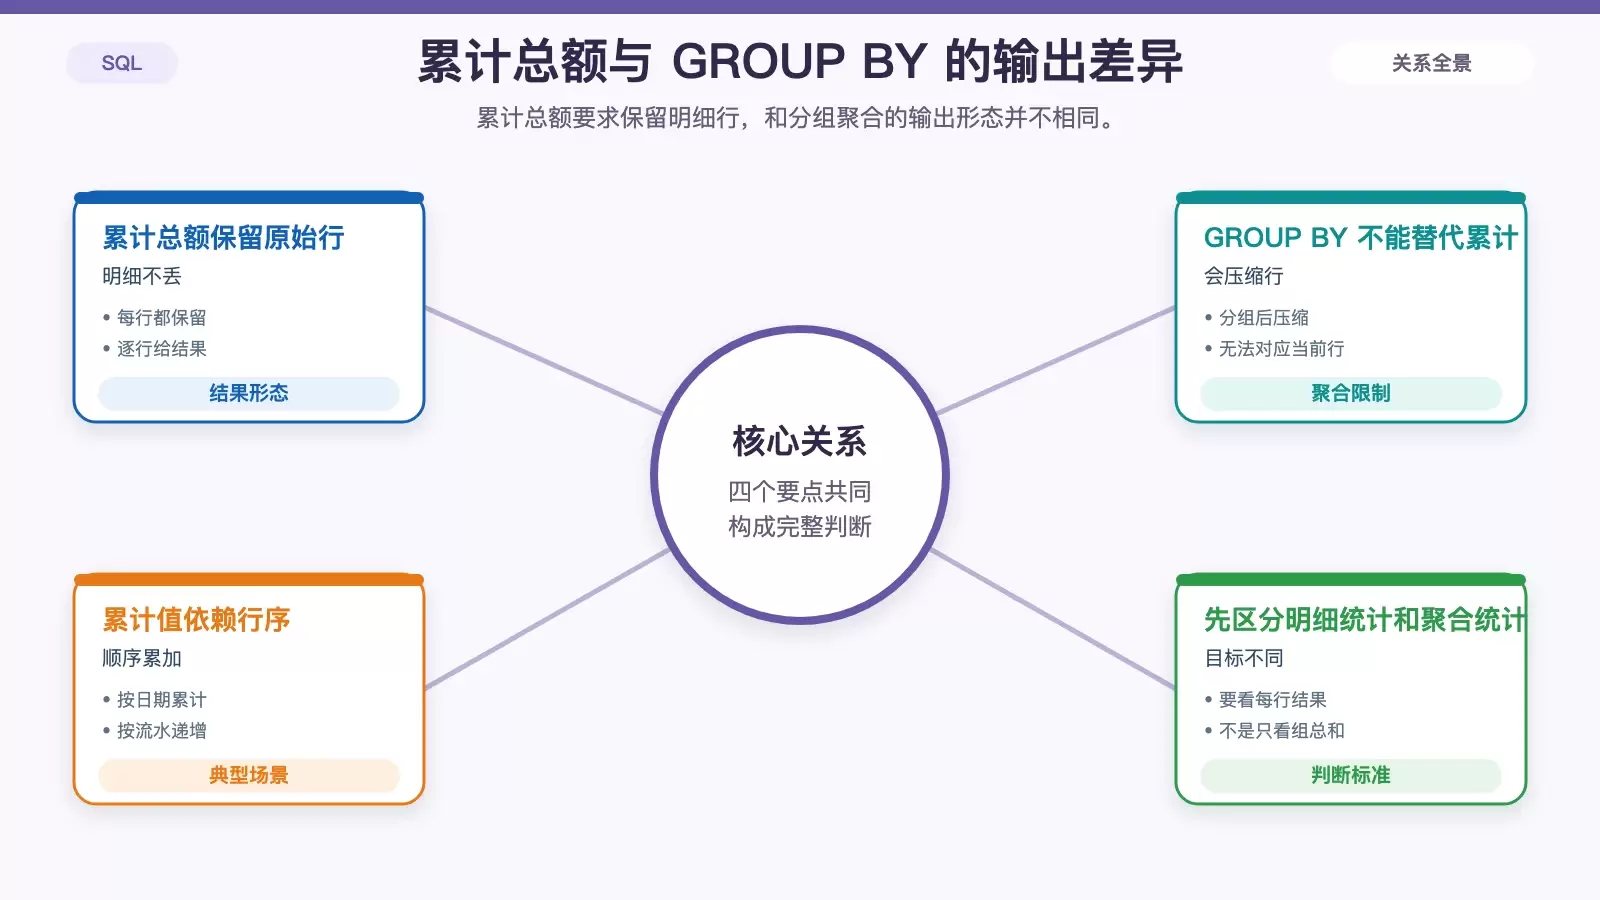
这里最容易混淆的是:累计总额不是普通聚合。它要求保留原始行数,并且让每一行都有一个对应的累计结果。
GROUP BY 做不到这一点,因为它的目标是把多行压缩成分组结果。例如你按日期分组,它返回的是“每个日期的汇总值”;而累计总额要的是“每一条记录到当前为止的累计值”。两者看起来都用了 SUM(),但输出形态完全不同。
因此,如果你需要的是逐行增长的动态和,就不能依赖 SUM() + GROUP BY,而要换成窗口函数来处理。
用 SUM() OVER() 实现基础累计和
最常见的写法是:
SUM(column) OVER (ORDER BY key)这类写法的核心在于:SUM() 负责求和,OVER (...) 定义窗口规则,窗口函数本身不会压缩行数,所以每一行都能拿到自己的累计结果。
几种常见形式如下:
SUM(sales) OVER (ORDER BY date):按date升序,从第一行累计到当前行SUM(sales) OVER (PARTITION BY region ORDER BY date):先按region分区,再在每个分区内部按date累加- 默认帧范围通常可理解为
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW,也就是“从开头到当前行”
一个基础示例如下,适用于 PostgreSQL、MySQL 8.0+、SQL Server:
SELECT date, sales,
 SUM(sales) OVER (ORDER BY date) AS running_total
FROM sales_data;
如果你的业务不是全表累计,而是“每个区域各算各的”,只需要把分区字段加进去:
SELECT region, date, sales,
 SUM(sales) OVER (PARTITION BY region ORDER BY date) AS running_total
FROM sales_data;
理解这一层后,可以把窗口函数当成一种“在不打散明细记录的前提下做统计”的方式。它和聚合函数的最大区别,不在于函数名,而在于是否保留明细行。
ORDER BY 缺失或重复时,累计结果为什么不可靠
很多累计总额查询“语法没报错,结果却时好时坏”,问题通常不在 SUM(),而在排序规则。
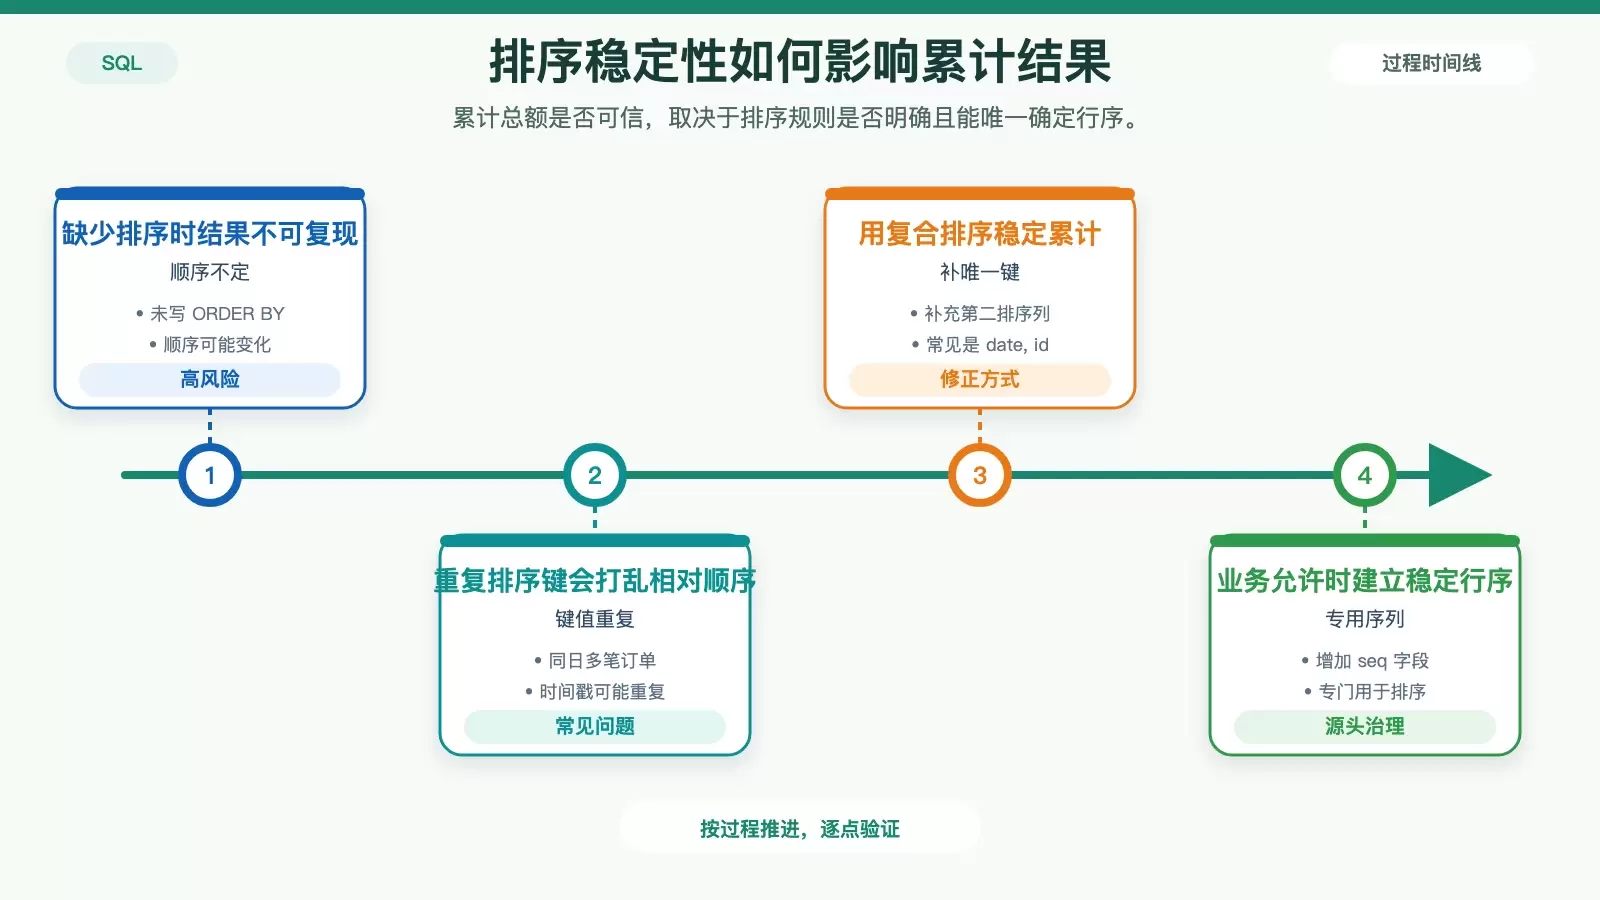
首先,如果没有显式写 ORDER BY,SUM() OVER() 的累加顺序就不可靠。数据库可能按物理存储顺序、读取顺序或执行计划中的临时顺序处理这些行,而这些顺序并不是固定不变的。换一次执行计划、做一次 VACUUM、调整数据写入顺序,结果都可能变化。
其次,即便写了 ORDER BY,如果排序键本身不唯一,累计结果仍然可能不稳定。最常见的例子是同一天有多笔订单,或者多条记录拥有相同的 created_at 时间戳。此时数据库只能保证“相同排序值的记录大致排在一起”,却不一定保证它们彼此之间的先后次序。
一旦相对顺序变化,累计值就会在这些重复键之间重新分配,表现出来就是你看到的数字“忽高忽低”或者“同一批数据重跑结果不同”。
怎么让累计顺序稳定下来
- 始终显式写出
ORDER BY - 让排序字段能够唯一确定行序,例如使用
ORDER BY date, id - 不要只依赖
ORDER BY created_at这类可能重复的字段 - 如果业务上长期需要稳定顺序,可以在源表增加专用排序字段,例如自增
seq
一个更稳妥的例子是:
SELECT date, id, sales,
 SUM(sales) OVER (ORDER BY date, id) AS running_total
FROM sales_data;
这类写法的意义不只是“多写一个字段”,而是明确告诉数据库:当 date 相同的时候,还要按 id 决定先后。只有顺序可重复,累计值才可重复。
大表上的性能问题:排序才是真正的成本
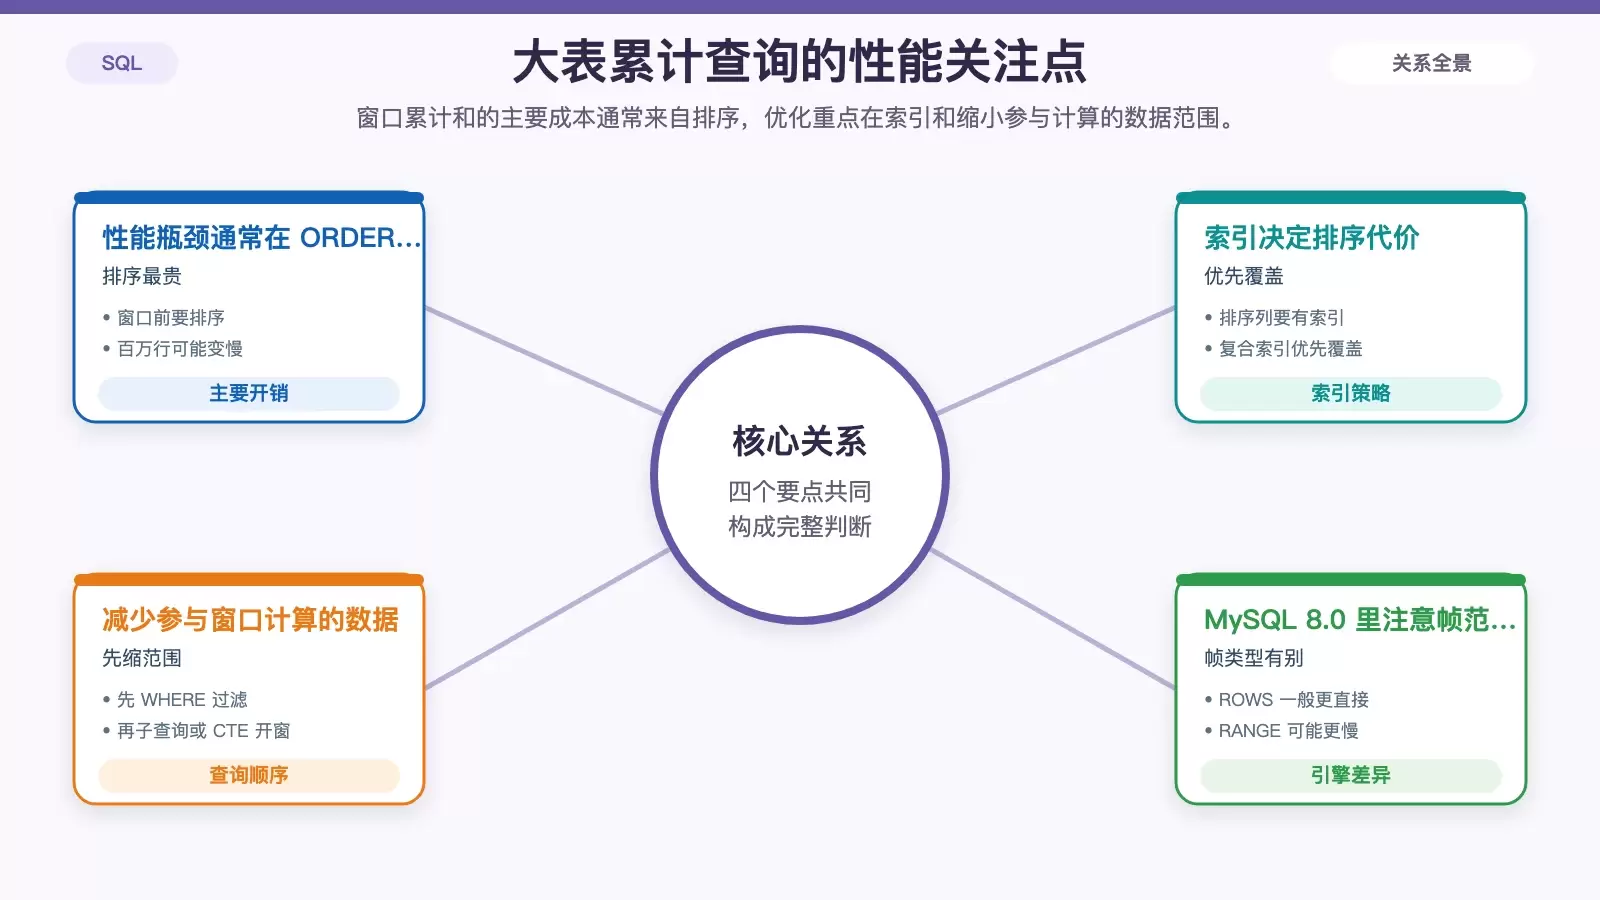
累计总额的语法通常很短,但执行代价未必低。原因在于 OVER (ORDER BY ...) 本质上需要先对窗口数据进行排序,而排序往往是大表查询最贵的一步。
当数据量上到 100 万行以上,如果排序字段没有合适索引,查询很可能明显变慢;在内存不足时,还可能把排序结果写入磁盘临时文件。这个问题不是窗口函数“不能用”,而是执行计划没有为排序成本兜底。
优化时优先看这几点
- 确保
ORDER BY字段有索引 - 如果同时用了
PARTITION BY和ORDER BY,优先考虑能覆盖这两部分的复合索引 - 不要在全表上先算累计、再做过滤;更合理的方式通常是先
WHERE过滤,再在子查询或 CTE 里执行OVER - 在 MySQL 8.0 中,
ORDER BY后配合ROWS UNBOUNDED PRECEDING通常不会额外带来明显性能问题,但使用RANGE帧时可能更慢,因为它需要做值范围比较
也就是说,累计总额的性能优化方向很明确:先确认排序是否必要、排序字段是否稳定,再检查是否有索引支撑,最后看是否能缩小参与窗口计算的数据范围。
对很多报表 SQL 来说,慢不慢并不取决于 SUM(),而是取决于你让数据库为多少行做排序,以及排序后的数据能不能直接从索引里拿到。
写累计总额时,最该先检查的 3 件事
如果你只想快速判断一条 SQL 是否写对,可以先检查下面三件事:
- 是不是用了窗口函数而不是
GROUP BY,并且结果保留了原始行数; - 排序条件是否显式、稳定、可唯一确定先后;
- 大表场景下,排序字段和过滤顺序是否考虑过执行计划成本。
累计总额本身并不复杂,真正容易出问题的是这些看起来像“细节”的地方。顺序没定义清楚,数字就可能今天对、明天错;排序没有索引,查询就可能从秒级变成分钟级。
只要把“保留明细行、稳定定义顺序、控制排序代价”这三点一起把住,SUM() OVER() 就是 SQL 里处理累计总额最直接、也最可靠的方案之一。









