

Python调用Tesseract库实现图片文字识别与知乎模拟登录

本文详细介绍如何在Python环境中使用Tesseract OCR库进行图片文字识别。内容涵盖Tesseract的安装配置、pytesseract模块的使用,以及通过代码示例展示如何识别简单验证码。针对复杂验证码识别失败的情况,文章提供了结合人工输入与自动识别的混合处理方案,并附带了知乎模拟登录的完整源码,帮助开发者解决爬虫中的验证码难题。
一、Tesseract简介
Tesseract是一款开源的光学字符识别(OCR)引擎,全称为Optical Character Recognition。它的主要功能是对扫描后的文本图像进行分析处理,从而提取出其中的文字内容及版面结构信息。目前,Tesseract被广泛认为是最优秀且识别精度较高的OCR工具之一。
二、Tesseract的使用
1. 下载并安装Tesseract:请前往官方渠道点击下载相关安装包。
2. 在Windows系统环境下配置环境变量:
#根据下载安装文件的路径配置环境变量
set TESSDATA_PREFIX F:\Tesseract-OCR\
3. 安装Python对应的pytesseract模块:
pip install pytesseract
4. 在Python脚本中指定tesseract.exe应用程序的路径:
pytesseract.pytesseract.tesseract_cmd = r'F:\Tesseract-OCR\tesseract.exe'
5. 案例演示
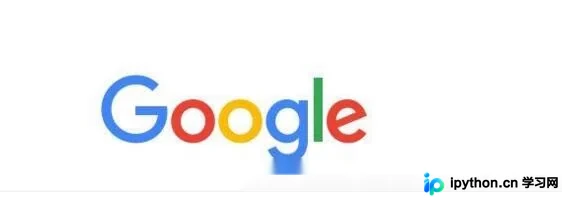
识别以下图片中的文字内容:
import pytesseract
from PIL import Image
#1.引入Tesseract程序
pytesseract.pytesseract.tesseract_cmd = r'F:\Tesseract-OCR\tesseract.exe'
#2.使用Image模块下的Open()函数打开图片
image = Image.open('6.jpg',mode='r')
print(image)
#3.识别图片文字
code= pytesseract.image_to_string(image)
print(code)
运行结果演示:
<PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=611x210 at 0x1A5DFDCB4A8> Google
需要注意的是,Tesseract引擎在处理某些复杂验证码时可能存在识别困难,例如豆瓣生成的部分验证码无法被准确识别。在这种情况下,如果需要通过爬虫获取豆瓣数据,则必须采用手动输入验证码的方式进行处理。
三、模拟登录知乎源码
import requests
import time
import pytesseract
from PIL import Image
from bs4 import BeautifulSoup

def captcha(data):
  with open('captcha.jpg','wb') as fp:
    fp.write(data)
  time.sleep(1)
  image = Image.open("captcha.jpg")
  text = pytesseract.image_to_string(image)
  print "机器识别后的验证码为:" + text
  command = raw_input("请输入Y表示同意使用,按其他键自行重新输入:")
  if (command == "Y" or command == "y"):
    return text
  else:
    return raw_input('输入验证码:')

def zhihuLogin(username,password):

  # 构建一个保存Cookie值的session对象
  sessiona = requests.Session()
  headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:47.0) Gecko/20100101 Firefox/47.0'}

  # 先获取页面信息,找到需要POST的数据(并且已记录当前页面的Cookie)
  html = sessiona.get('https://www.zhihu.com/#signin', headers=headers).content

  # 找到 name 属性值为 _xsrf 的input标签,取出value里的值
  _xsrf = BeautifulSoup(html ,'lxml').find('input', attrs={'name':'_xsrf'}).get('value')

  # 取出验证码,r后面的值是Unix时间戳,time.time()
  captcha_url = 'https://www.zhihu.com/captcha.gif?r=%d&type=login' % (time.time() * 1000)
  response = sessiona.get(captcha_url, headers = headers)


  data = {
    "_xsrf":_xsrf,
    "email":username,
    "password":password,
    "remember_me":True,
    "captcha": captcha(response.content)
  }

  response = sessiona.post('https://www.zhihu.com/login/email', data = data, headers=headers)
  print response.text

  response = sessiona.get('https://www.zhihu.com/people/maozhaojun/activities', headers=headers)
  print response.text


if __name__ == "__main__":
  #username = raw_input("username")
  #password = raw_input("password")
  zhihuLogin('xxxx@qq.com','ALAxxxxIME')
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









