


在 C# 里,数组、List<T>、Dictionary<TKey, TValue> 和 HashSet<T> 经常被放在一起讨论,但它们的设计目标并不一样。要写出性能和可维护性都更稳的代码,关键不是“会用 API”,而是先搞清楚底层代价、扩容机制以及查找方式,再根据数据规模、是否允许重复、是否依赖索引访问来做选择。
这篇文章按“从基础结构到专用集合”的顺序展开:先看数组为什么快、为什么不灵活,再看 List<T> 怎样用内部数组实现动态增长,最后再把按键查找、去重和先进先出这类问题交给更合适的集合类型。读完后,你可以对常见场景做出更明确的选型判断。
数组为什么仍然是理解集合的起点
数组是 C# 中最基础的数据集合形式。很多更高级的集合,本质上都建立在它之上。理解数组,等于先掌握了集合在内存中的最原始模型。
数组的本质:连续的内存空间
当你声明一个数组,例如 int[] numbers = new int[5];,实际上是在内存中申请了一块连续且完整的空间,这块空间足以容纳 5 个 int 类型的数据。
- 连续存储:数组元素在内存中是挨着放的,可以理解为一排连续编号的位置。
- 固定大小:数组一旦创建,长度就确定了,后面不能直接扩容。
- 元素同型:同一个数组只能保存同一种类型的数据。
正因为有连续存储这个特性,数组才能以极低成本完成随机访问。CPU 不需要遍历前面的元素,只要通过 基地址 + i * 单个元素大小,就能直接定位到 array[i] 的地址,这也是它在读取场景下非常快的原因。
数组的声明、初始化与遍历
// 1. 声明并初始化大小
int[] scores = new int[5]; // 在内存中分配了5个int的空间,默认值为0

// 2. 通过索引访问 (从0开始)
scores[0] = 95;
scores[1] = 88;
int firstScore = scores[0];

// 3. 声明并直接初始化内容
string[] names = new string[] { "Alice", "Bob", "Charlie" };
// 或者更简洁的语法
string[] namesShort = { "Alice", "Bob", "Charlie" };

// 4. 遍历数组
foreach (string name in names)
{
    Console.WriteLine(name);
}

// 5. 获取长度
int nameCount = names.Length; // 结果是 3
这些语法并不复杂,但它们背后的限制很明确:你能高效地读写已有位置,却很难在运行中自由增减容量。
数组适合什么场景,不适合什么场景
数组的优势主要有两点:
- 索引访问性能高:通过
array[i]读取元素属于 O(1) 操作,尤其适合频繁随机读取。 - 内存开销低:除元素本身外,额外结构成本很少。
数组的问题同样很直接:
- 长度不可变:创建时就要决定大小,而业务里的数据量往往是动态变化的。
- 中间插入和删除代价高:如果要在中间插入或删除元素,后续数据都要整体移动,复杂度是 O(n)。
所以,数组更适合“元素个数已知、类型固定、读取频繁”的场景,比如固定配置项、坐标缓存、批量数值处理等。如果集合大小会持续变化,数组往往只是起点,而不是终点。
List<T> 如何把数组变成“可增长”的集合
List<T> 可以理解为“带管理能力的数组”。它内部仍然依赖数组,但把容量变化、元素搬移和常用操作封装起来,因此成为日常开发里最常见的通用集合。
先分清 Count 和 Capacity
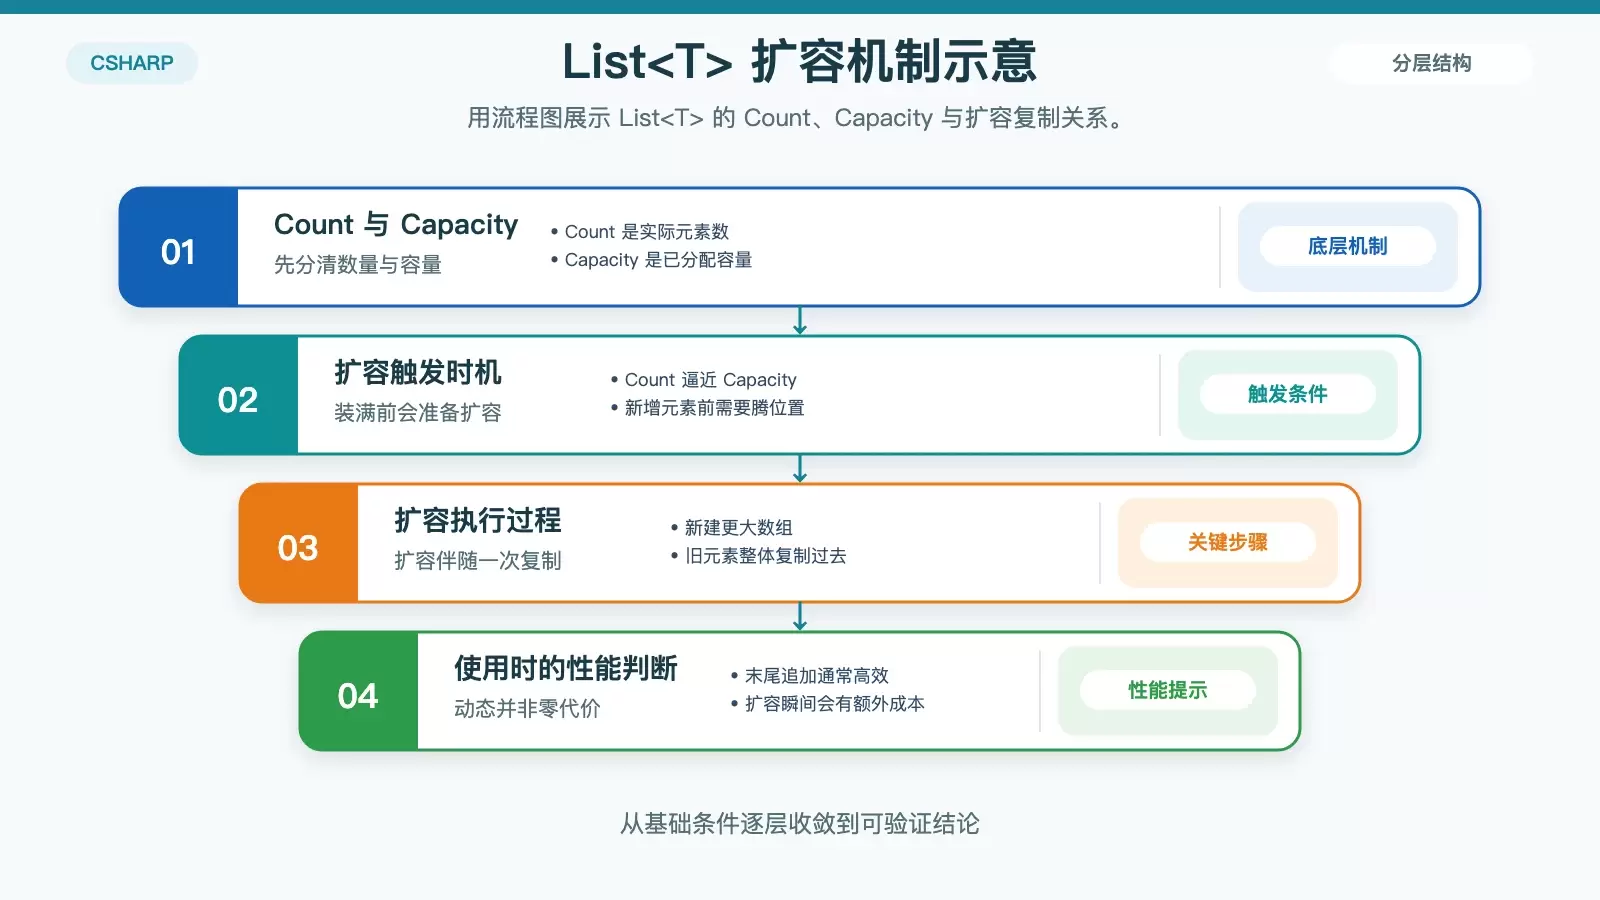
List<T> 之所以能动态增长,关键在于它把“实际元素数量”和“底层已分配容量”分开管理:
Count:当前列表里真正存放的元素数量。Capacity:内部数组当前最多能容纳多少元素。
两者的关系始终是 Capacity >= Count。只要还有空位,新增元素就可以直接放进去;一旦即将装满,就会触发扩容。
扩容机制到底做了什么
当你向一个 List<T> 追加元素,而 Count 已经逼近 Capacity 时,内部通常会执行下面几步:
- 创建一个新的、更大的数组,通常容量会扩到当前的两倍。
- 把旧数组中的全部元素复制到新数组。
- 丢弃旧数组,让内部引用切换到新数组。
- 把新元素追加到新数组末尾。
这也是为什么 List<T> 大多数时候追加很方便,但在容量不够时会突然产生一次额外拷贝成本。数据量较大时,这个过程就值得关注了。
List<int> numbers = new List<int>(); // 初始Capacity通常为0
Console.WriteLine($"Count: {numbers.Count}, Capacity: {numbers.Capacity}");

numbers.Add(1); // 添加元素
Console.WriteLine($"Count: {numbers.Count}, Capacity: {numbers.Capacity}");  // 创建Capacity为4的容器
numbers.Add(2);
numbers.Add(3);
numbers.Add(4);
numbers.Add(5); // 此时会触发内部数组的扩容和复制!此时Capacity为8

Console.WriteLine($"Count: {numbers.Count}, Capacity: {numbers.Capacity}");
从这个例子可以看出,List<T> 的“动态”并不是无限伸缩,而是通过分配更大数组再复制数据实现的。它很好用,但不是没有代价。
常用 API 可以怎么分组理解
相比数组,List<T> 真正拉开差距的地方,在于它提供了更完整的操作接口。与其死记方法名,更有效的方式是按用途理解。
添加与插入
Add(T item):在末尾追加一个元素。AddRange(IEnumerable<T> collection):把一组元素整体追加到末尾。Insert(int index, T item):在指定位置插入一个元素。InsertRange(int index, IEnumerable<T> collection):在指定位置插入一组元素。
末尾追加通常是最自然、成本也最低的使用方式;而在中间插入,本质上仍然需要移动后续元素,代价并没有因为换成 List<T> 就消失。
查找与判断
Contains(T item):判断某个元素是否存在。Exists(Predicate<T> match):判断是否存在满足条件的元素。Find(Predicate<T> match):返回第一个满足条件的元素。FindAll(Predicate<T> match):返回所有满足条件的元素组成的新List<T>。IndexOf(T item)和LastIndexOf(T item):查找元素索引,找不到返回-1。
这类方法非常适合一般业务开发,但要注意,List<T> 的查找大多仍然需要遍历,因此当你的核心需求是“按键快速定位”时,就应该考虑字典了。
删除、排序与转换
Remove(T item)、RemoveAt(int index)、RemoveAll(Predicate<T> match)、RemoveRange(int index, int count)、Clear()Sort()、Sort(Comparison<T> comparison)、Reverse()ForEach(Action<T> action)、ToArray()、GetRange(int index, int count)
这些方法说明了一件事:List<T> 不是简单的“可变数组”,而是一套围绕顺序数据操作优化过的通用容器。它对绝大多数增删改查场景都足够友好,因此在不知道该选什么时,List<T> 往往是比数组更稳妥的默认选择。
什么时候该换成 Dictionary、HashSet、Queue 或 Stack
一旦你的需求不再是“按顺序存一串数据”,就不应该继续勉强使用数组或 List<T>。C# 提供这些特殊集合,本质上是为了把不同问题交给不同结构处理。
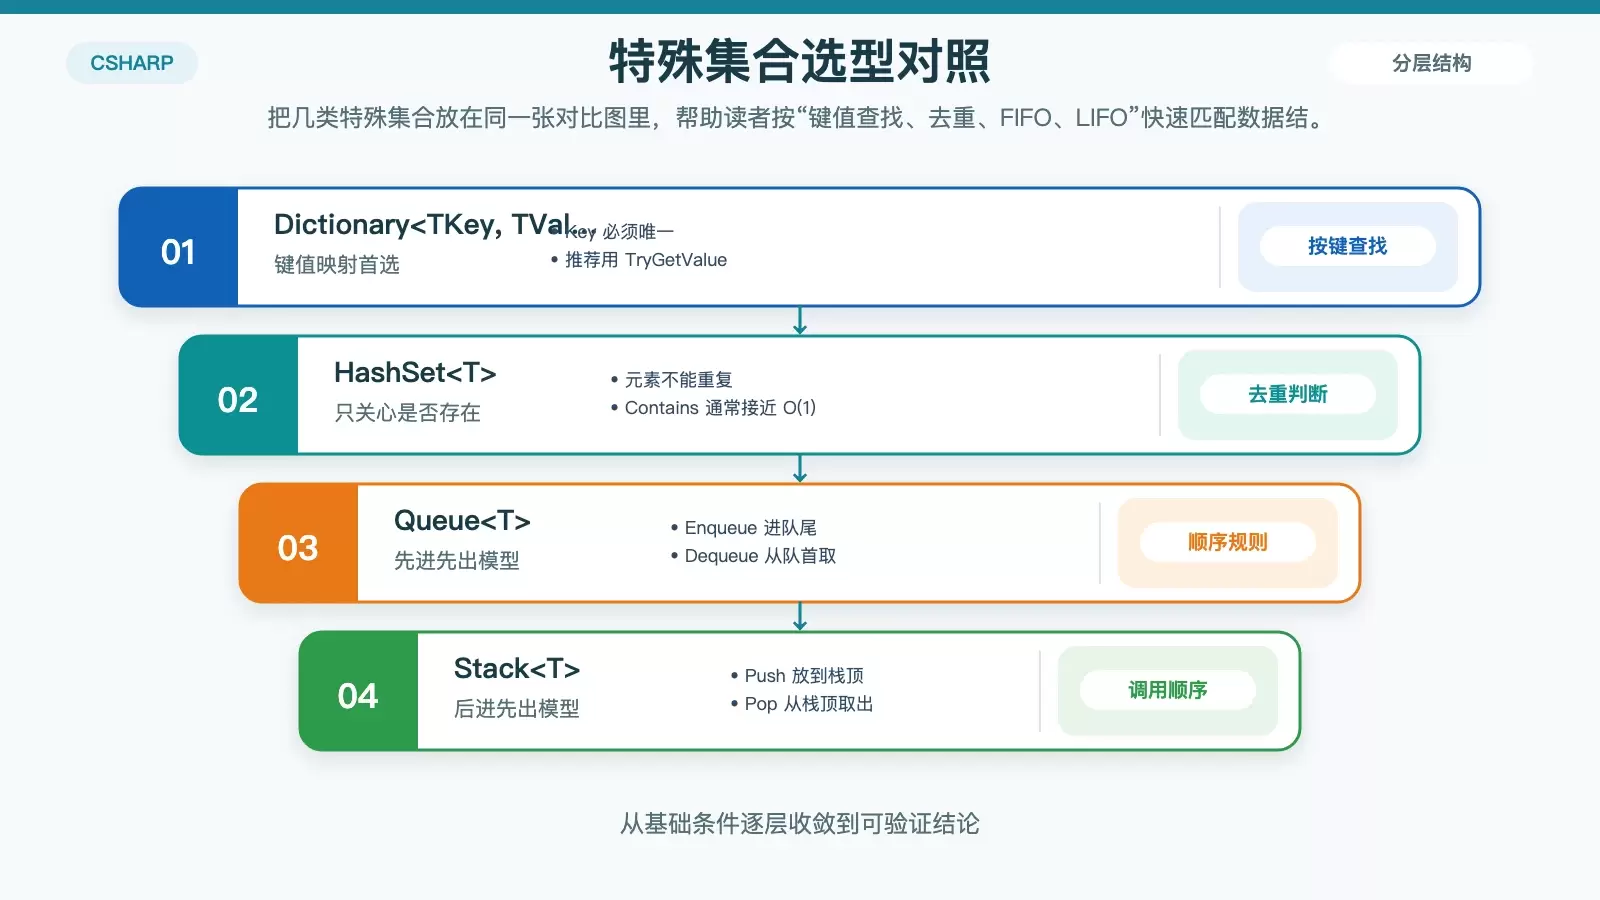
Dictionary<TKey, TValue>:按键查值的首选
当你需要通过一个唯一的 Key 快速找到对应的 Value 时,Dictionary<TKey, TValue> 几乎总是比列表遍历更合适。
- 底层原理:基于哈希表(Hash Table)实现,通过哈希函数把 Key 映射到内部索引。
- 性能特征:查找、插入、删除通常接近 O(1)。
- 使用约束:Key 必须唯一,而且不能为
null。
Dictionary<string, int> studentAges = new Dictionary<string, int>();

// 添加键值对
studentAges.Add("Alice", 20);
studentAges["Bob"] = 22; // 更方便的索引器语法

// 查找
if (studentAges.TryGetValue("Alice", out int age))
{
    Console.WriteLine($"Alice's age is {age}"); // 推荐用法,避免异常
}

// 遍历
foreach (var pair in studentAges)
{
    Console.WriteLine($"Key: {pair.Key}, Value: {pair.Value}");
}
其中 TryGetValue 是非常值得养成的写法。它能在不存在对应 Key 时避免异常,既更稳,也更符合高频查找的编码习惯。
HashSet<T>:只关心是否存在,而且不允许重复
如果你的需求从头到尾都不是“保存顺序”,而是“某个元素是否已经出现过”,那就应该优先考虑 HashSet<T>。
- 底层结构:同样基于哈希表,但只存储元素本身,不保存额外的 Value。
- 核心价值:元素唯一,
Contains检查通常接近 O(1)。 - 适用问题:去重、成员判断、交集并集差集这类集合运算。
HashSet<string> uniqueNames = new HashSet<string>();
uniqueNames.Add("Alice");
uniqueNames.Add("Bob");
uniqueNames.Add("Alice"); // 添加失败,因为 "Alice" 已存在

Console.WriteLine(uniqueNames.Count); // 输出: 2

bool hasBob = uniqueNames.Contains("Bob"); // 极快
很多人一开始会用 List<T> 配合 Contains 做去重,但只要数据量上来,这种写法就会越来越吃亏。HashSet<T> 更贴合问题本身。
Queue<T> 和 Stack<T>:顺序规则不同,结构就不同
当数据处理的关键不是“存多少”,而是“按什么顺序取”,就轮到队列和栈出场了。
Queue<T>:先进先出(FIFO, First-In, First-Out)Enqueue():入队,添加到队尾。Dequeue():出队,从队首移除并返回元素。
Stack<T>:后进先出(LIFO, Last-In, First-Out)Push():入栈,添加到栈顶。Pop():出栈,从栈顶移除并返回元素。
这两种集合在任务调度、撤销操作、深度遍历、消息排队等场景里都很常见。和用 List<T> 自己模拟相比,它们的表达意图更清晰,也更不容易写出方向反了的逻辑。
C# 集合选型可以怎样快速判断
如果把前面的内容压缩成实战规则,可以得到一套很直接的判断方式:
- 元素数量固定,且需要高频按索引读取:优先用数组。
- 元素数量会变化,主要还是顺序存取:优先用
List<T>。 - 需要通过唯一键快速找到值:用
Dictionary<TKey, TValue>。 - 需要去重,或者只关心元素是否存在:用
HashSet<T>。 - 需要先进先出:用
Queue<T>。 - 需要后进先出:用
Stack<T>。
真正的最佳实践,并不是机械记忆“哪个集合更高级”,而是把数据访问方式、是否允许重复、是否需要键值映射、是否依赖顺序规则这些问题先问清楚。集合选对了,代码性能、可读性和后续维护成本通常都会一起变好。









